


真机强化作业概述
传统的行为克隆算法(模仿学习)擅长从人类演示中学习任务操作和语义知识,但其性能往往随着数据量增加而趋于饱和,难以达到100%的成功率,并且现有的SOTA VLA模型通常采用“action chunking”(动作分块)技术,虽然有助于长程任务规划,但其本质上是开环执行,缺乏高频的闭环反应能力,导致在高精度的任务(如精密插孔)中容易失败。
由于真机部署时场景数据会与训练数据存在分布偏移,导致基于模仿学习训练出来的算法在遇到训练数据分布之外(OOD)的状态时,往往无法自愈,因此该误差会逐渐累积最终导致机械臂的运行偏离正常轨迹。
目前,CloudRobo支持基于Physical-Intelligence_PI05-Base模型完成真机强化作业,更好地解决真机部署出现的问题缺陷。
残差强化学习算法价值
- 提高样本效率与探索效率
利用冻结的BC策略作为探索先验,RL仅需学习微小的修正量,而非学习整个动作,大幅缩短训练时间。
引入人类干预纠正机制,当机械臂陷入死胡同或偏离基础策略太远,人类的介入能够将状态快速拉回高价值区域,极大地加速收敛效率。
- 安全性与训练稳定性
冻结基础策略充当了隐性的“安全约束”。通常残差策略会被限制探索幅度,这保证在RL的探索初期,机器人的行为仍然主要由相对安全的BC策略主导,避免纯RL常见的剧烈抖动或危险动作。
人类作为安全保障,可以在机器人即将发生碰撞或严重错误的时候接管控制,进一步降低实机训练的风险,推动VLA的真机强化学习实现业务部署。
- 解决“最后一厘米”的精度问题
通过学习每一步(per-step)的闭环残差,算法能够修正动作分块(action chunking)的开环执行误差,使得机器人得以处理精密装配等高难度任务。
- 数据回流与持续进化
该插件算法不仅能提升当前任务的性能,还能通过RL在线交互生成大量高质量的成功轨迹(包含修正行为),这些数据可以被“蒸馏”回基座模型,打造数据飞轮,实现VLA模型的持续进化。
真机强化作业使用流程
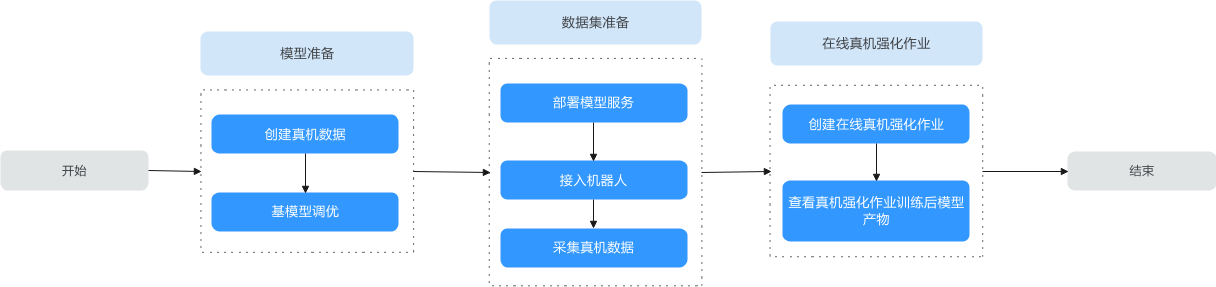
| 操作 | 说明 |
|---|---|
| 在线真机强化作业 |
|
最佳实践
为了用户可以更全量地使用真机强化作业功能,本产品为用户提供全流程最佳实践,具体请参见基于残差强化学习算法完成真机强化作业。


