

PostgreSQL同步到DMS Kafka作业配置
支持的源端和目的端数据库版本
| 源端数据库 | 目的端数据库 |
|---|---|
| PostgreSQL数据库(PostgreSQL 9.4、9.5、9.6、10、11、12、13、14、15、16版本) | Kafka集群(2.7、3.x版本) |
数据库账号权限要求
在使用Migration进行同步时,源端和目的端所使用的数据库账号需要满足以下权限要求,才能启动实时同步任务。不同类型的同步任务,需要的账号权限也不同,详细可参考下表进行赋权。
| 类型名称 | 权限要求 |
|---|---|
| 源数据库连接账号 | 数据库的CONNECT权限,模式的USAGE权限,表的SELECT权限,序列的SELECT权限,REPLICATION连接权限,同时需要有查询pg_ls_waldir()函数的权限,具体操作请参见如何增加PostgreSQL、Gaussdb数据源额外权限?。 说明: REPLICATION连接权限的添加方法:
|
| 目标数据库连接账号 | Kafka开启密文接入场景下,所配置用户需要有发布和订阅Topic的权限,其余场景无特殊权限要求。 说明: |
支持的同步对象范围
在使用Migration进行同步时,不同类型的链路,支持的同步对象范围不同,详细情况可参考下表。
| 类型名称 | 使用须知 |
|---|---|
| 同步对象范围 |
|
注意事项
除了数据源版本、连接账号权限及同步对象范围外,您还需要注意的事项请参见下表。
| 类型名称 | 使用和操作限制 |
|---|---|
| 数据库限制 |
|
| 使用限制 | 通用:
全量同步阶段: 任务启动和全量数据同步阶段,请不要在源数据库执行DDL操作,否则可能导致任务异常。 增量同步阶段:
常见故障排查: 在任务创建、启动、全量同步、增量同步、结束等过程中,如有遇到问题,可先参考常见问题章节进行排查。 |
| 其他限制 |
|
操作步骤
本小节以PostgreSQL到MRS Kafka的实时同步为示例,介绍如何配置Migration实时集成作业。配置作业前请务必阅读使用前自检概览, 确认已做好所有准备工作。
- 参见新建实时集成作业创建一个实时集成作业并进入作业配置界面。
- 选择数据连接类型:源端选PostgreSQL,目的端选MRS Kafka。 图1 选择数据连接类型

- 选择集成作业类型:同步类型默认为实时,同步场景包含整库场景。 图2 选择集成作业类型

- 配置网络资源:选择已创建的PostgreSQL、MRS Kafka数据连接和已配置好网络连接的migration资源组。 图3 选择数据连接及migration资源组


无可选数据连接时,可单击“新建”跳转至管理中心数据连接界面,单击“创建数据连接”创建数据连接,详情请参见配置DataArts Studio数据连接参数进行配置。
无可选migration资源组时,可单击“新建”跳转至购买migration资源组页面创建migration资源组配置,详情请参见购买创建数据集成资源组增量包进行配置。
- 检测网络连通性:数据连接和migration资源组配置完成后需要测试整个迁移任务的网络连通性,可通过以下方式进行数据源和migration资源组之间的连通性测试。
- 单击展开“源端配置”触发连通性测试,会对整个迁移任务的连通性做校验。
- 单击源端和目的端数据源和migration资源组中的“测试”按钮进行检测。
- 配置源端参数。
各同步场景下选择需要同步库表的方式请参考下表。
表5 选择需要同步的库表 同步场景
配置方式
整库
选择需要迁移的PostgreSQL库表。图4 选择库表
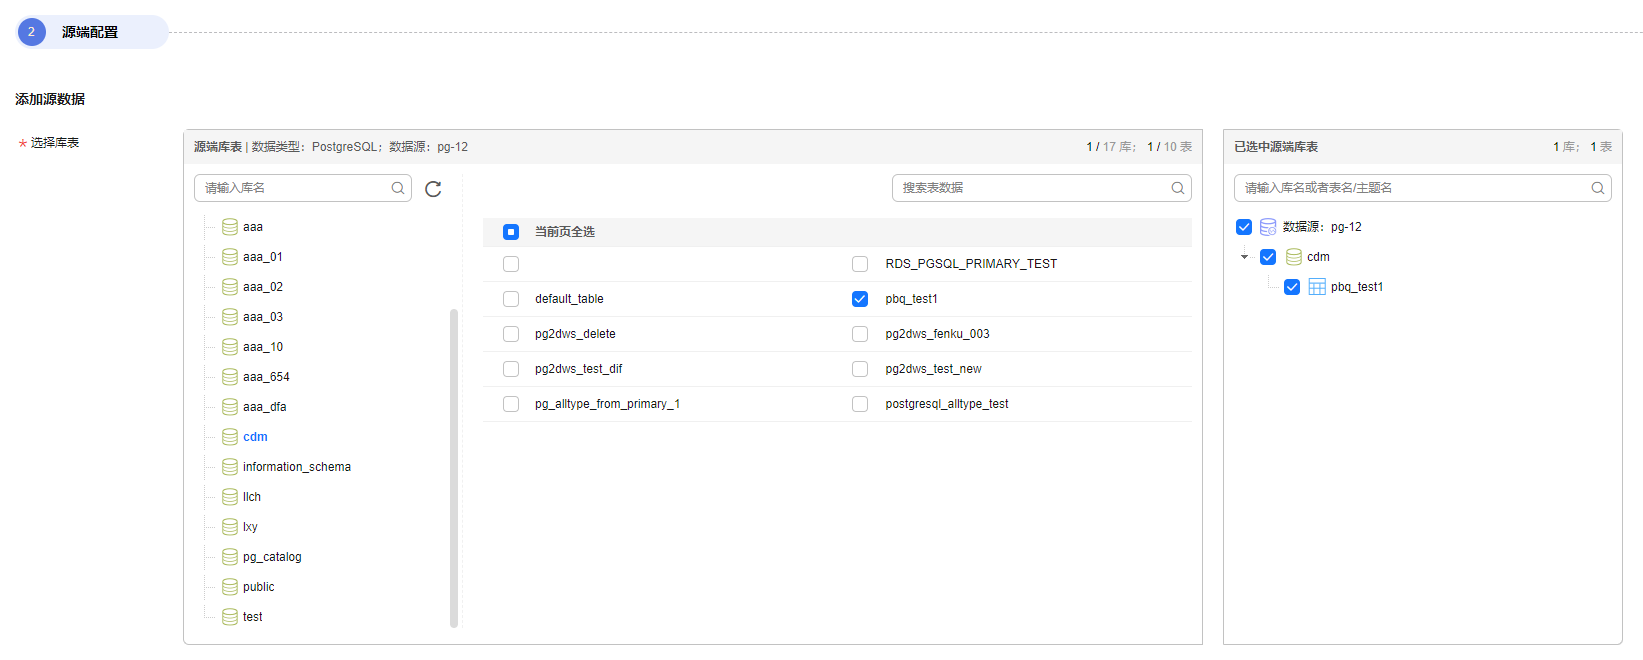
库与表均支持自定义选择,即可选择一库一表,也可选择多库多表。
- 配置目的端参数。 图5 Kafka目的端配置项

- 目标Topic名称规则。
配置源端库表与目的端Kafka Topic的映射规则,可指定为固定的一个Topic,也可使用内置变量做映射,将不同源表数据同步到不同的Topic中。
可以使用的内置变量有:
- 源库名:#{source_db_name}。
- 源表名:#{source_table_name}。
- 同步kafka partition策略
支持以下三种投递策略将源端的数据按规则同步到Kafka Topic的特定Partition:
- 全部投递到Partition 0。
- 按库名+表名的hash值投递到不同Partition。
- 按表的主键值hash值投递到不同的Partition。
源端无主键情况下,目的端默认投递到partition 0。
- 新建Topic的Partition数量
- Kafka目标端属性配置
支持设置Kafka的配置项,需要增加 properties. 前缀,作业将自动移除前缀并传入底层Kafka客户端,具体参数可参考Kafka官方文档中的配置说明。
- 高级配置
支持在作业“任务配置”中添加自定义属性来开启部分高级功能,参数详情可参考PostgreSQL > Kafka高级参数一览表。
图6 添加自定义属性

表6 PostgreSQL > Kafka高级参数一览表 参数名
参数类型
默认值
单位
参数说明
sink.delivery-guarantee
string
at-least-once
-
Flink写Kafka时的语义保证机制。
- at-least-once:在 checkpoint 时会等待 Kafka 缓冲区中的数据全部被 Kafka producer 确认。消息不会因 Kafka broker 端发生的事件而丢失,但可能会在 Flink 重启时重复,因为 Flink 会重新处理旧数据。
- exactly-once:该模式下,Kafka sink 会将所有数据通过在 checkpoint 时提交的事务写入。因此,如果 consumer 只读取已提交的数据,在 Flink 发生重启时不会发生数据重复。然而这会使数据在 checkpoint 完成时才会可见,因此请按需调整 checkpoint 的间隔。
- 目标Topic名称规则。
- 刷新源表和目标表映射,检查映射关系是否正确。 图7 源表与目标表映射

- 配置任务属性。
表7 任务配置参数说明 参数
说明
默认值
执行内存
作业执行分配内存,跟随处理器核数变化而自动变化。
8GB
处理器核数
范围:2-32。
每增加1处理核数,则自动增加4G执行内存和1并发数。
2
并发数
作业执行支持并发数。该参数无需配置,跟随处理器核数变化而自动变化。
1
自动重试
作业失败时是否开启自动重试。
否
最大重试次数
“自动重试”为是时显示该参数。
1
重试间隔时间
“自动重试”为是时显示该参数。
120秒
是否写入脏数据
选择是否记录脏数据,默认不记录脏数据,当脏数据过多时,会影响同步任务的整体同步速度。
- 否:默认为否,不记录脏数据。
- 是:允许脏数据,即任务产生脏数据时不影响任务执行。 允许脏数据并设置其阈值时:
- 若产生的脏数据在阈值范围内,同步任务将忽略脏数据(即不会写入目标端),并正常执行。
- 若产生的脏数据超出阈值范围,同步任务将失败退出。 说明:
脏数据认定标准:脏数据是对业务没有意义,格式非法或者同步过程中出现问题的数据;单条数据写入目标数据源过程中发生了异常,则此条数据为脏数据。 因此只要是写入失败的数据均被归类于脏数据。
例如,源端是VARCHAR类型的数据写到INT类型的目标列中,则会因为转换不合理导致脏数据不会成功写入目的端。用户可以在同步任务配置时,配置同步过程中是否写入脏数据,配置脏数据条数(单个分片的最大错误记录数)保证任务运行,即当脏数据超过指定条数时,任务失败退出。
否
脏数据策略
“是否写入脏数据”为是时显示该参数,当前支持以下策略:
- 不归档:不对脏数据进行存储,仅记录到任务日志中。
- 归档到OBS:将脏数据存储到OBS中,并打印到任务日志中。
不归档
脏数据写入连接
“脏数据策略”选择归档到OBS时显示该参数。
脏数据要写入的连接,目前只支持写入到OBS连接。
-
脏数据目录
脏数据写入的OBS目录。
-
脏数据阈值
是否写入脏数据为是时显示该参数。
用户根据实际设置脏数据阈值。
说明:- 脏数据阈值仅针对每个并发生效。比如阈值为100,并发为3,则该作业可容忍的脏数据条数最多为300。
- 输入-1表示不限制脏数据条数。
100
是否开启心跳表功能
选择是否开启心跳表功能,默认不开启。
如果开启心跳表,实时集成作业将会在源端创建心跳表(如果不存在的话),作业运行阶段会定时往心跳表更新数据。
- 请确保数据源实例可写。
- 请确保账号有心跳表建表权限(如果心跳表不存在)、心跳表写入权限、心跳表抽取权限。
否
模式或表空间
心跳表所在的模式或者表空间名。
test_database
表名
心跳表表名。
如果表不存在,实时集成作业将会自动创建,请确保数据源连接所对应的账号有建表权限。
用户可以手动建表,建表格式参见心跳表格式。
test_hearbeat_table
心跳生成间隔
实时集成作业将按照此时间间隔生成并写入心跳数据到心跳表,单位秒。
10
心跳数据写入topic
选择是否开启心跳数据写入topic,默认不开启。
开启此选项,心跳数据将会写入目的端topic中,当前选项只针对Kafka为目的端的链路生效。
心跳数据格式参考心跳数据格式介绍。
否
添加自定义属性
支持通过自定义属性修改部分作业参数及开启部分高级功能,详情可参见任务性能调优章节。
-
- 提交并运行任务。
作业配置完毕后,单击作业开发页面左上角“提交”,完成作业提交。
图8 提交作业

提交成功后,单击作业开发页面“启动”按钮,在弹出的启动配置对话框按照实际情况配置同步位点参数,单击“确定”启动作业。
图9 启动配置
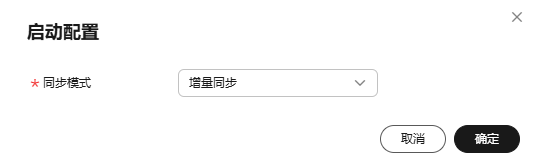
表8 启动配置参数 参数
说明
同步模式
- 增量同步:从指定时间位点开始同步增量数据。
- 全量+增量:先同步全量数据,随后实时同步增量数据。
- 监控作业。
通过单击作业开发页面导航栏的“前往监控”按钮,可前往作业监控页面查看运行情况、监控日志等信息,并配置对应的告警规则,详情请参见实时集成任务运维。
图10 前往监控

性能调优
若链路同步速度过慢,可参见任务性能调优章节中对应链路文档进行排查及处理。


