


查看作业运行历史
在数据处理流程中,用户通常需要追溯不同计算引擎作业的执行状态与历史记录,以进行运维分析或故障排查。
AI DataLake提供作业运行历史查询功能,用户可查看各引擎作业的运行历史,并通过名称、作业ID或作业状态进行筛选。查询结果展示端点名称与显示名称,帮助用户精准识别作业执行上下文,提升作业管理的可观测性与操作便捷性。
作业运行历史保留时间
作业保留时间以作业执行时间开始计算。
| 引擎 | 保留时间 |
|---|---|
| Aura | 3天 |
| Ray、Spark、Flink | 7天 |
前提条件
当前空间已提交Aura、Ray、Spark或Flink作业。
查看Aura作业历史
- 登录AI DataLake管理控制台。
- 在页面左上角切换至对应的工作空间。
- 在左侧导航栏选择“作业开发 > 作业运行历史”进入作业运行历史页面。
- 在“作业运行历史”页面中,选择“多模数据引擎 Aura”页签,查看Aura引擎作业的运行记录。
- 在Aura作业列表上方可以切换AuraJob和AuraJobV2,查看不同类型作业的信息。
- 查看作业基本信息:作业列表中可以查看作业名称/ID、端点名称、状态、提交时间、执行时间、运行时长、提交人等信息。

AuraJobV2端点的作业说明:
- 数据库名称、会话ID、执行时间、作业SQL四列默认隐藏,您可以在“作业运行历史”列表右侧单击
 ,勾选后展示。
- 您可以在搜索框根据作业ID、会话ID、状态、作业类型过滤作业。
- 数据库名称、会话ID、执行时间、作业SQL四列默认隐藏,您可以在“作业运行历史”列表右侧单击
- 查看作业详情信息:
引擎
查看方式
参数说明
AuraJob
单击作业名称。
AuraJobV2
单击作业ID,或者在“操作”列单击“查看详情”,在“作业运行详情”面板的“基本信息”页签下查看作业运行的详情信息。
- 查看作业监控:具体操作,请参见查看Aura作业监控。
- 查看作业基本信息:作业列表中可以查看作业名称/ID、端点名称、状态、提交时间、执行时间、运行时长、提交人等信息。
查看Ray作业历史
- 登录AI DataLake管理控制台。
- 在页面左上角切换至对应的工作空间。
- 在左侧导航栏选择“作业开发 > 作业运行历史”进入作业运行历史页面。
- 在“作业运行历史”页面中,选择“AI 计算引擎 Ray”页签,查看Ray引擎作业的运行记录。
- 查看作业基本信息:在Ray作业列表左上角切换“端点”和“集群联邦”,查看作业名称/ID、端点类型、端点名称、状态、提交时间、执行时间、运行时长、提交人等信息。
- 查看作业详情信息:单击作业名称,或单击“操作”列的“查看详情”,在展开的页面中查看作业运行详情。
- 停止作业:在目标作业的“操作”列,单击“停止”,在弹出的对话框中,单击“确定”,停止作业。
- 查看历史作业:在历史作业列表“操作”列,单击“Web UI”,在Web UI中查看历史作业的运行信息。更多信息,请参见使用History Server查看历史作业。
- 查看作业监控:在目标作业的“操作”列,单击“作业监控”,在展开的“作业监控”页面中查看作业监控信息。更多信息,请参见Ray端点资源监控与作业监控。
查看Spark作业历史
- 方式一:在“作业开发”中查看作业运行历史
- 登录AI DataLake管理控制台。
- 在页面左上角切换至对应的工作空间。
- 在左侧导航栏选择“作业开发”> “作业运行历史”进入作业运行历史页面。
- 在“作业运行历史”页面中,选择“批处理引擎 Spark”页签,查看Spark引擎作业的运行记录。
- 在Spark作业列表上方可以切换SparkSQL和SparkJob,查看SQL和Job类型作业的信息。
- 查看作业基本信息:作业列表中可以查看作业名称/ID、端点名称、状态、提交时间、执行时间、运行时长、提交人等信息。
- 查看作业详情信息:单击作业名称,或单击“操作”列“查看详情”,在展开的页面中可以查看作业的基本信息和参数配置信息。
- 查看归档日志:单击Spark历史作业列表“操作”列的“查看日志”,系统跳转到OBS页面,可以在对应作业日志的OBS路径中查看日志信息。
- 查看Spark UI:单击Spark历史作业列表“操作”列的“Web UI”,可以在Spark UI中查看作业运行信息。
- 方式二:在“引擎端点”中查看作业运行历史
- 登录AI DataLake管理控制台。
- 在页面左上角切换至对应的工作空间。
- 在左侧导航栏选择“引擎端点”> “批处理引擎Spark”。
- 单击目标端点名称后,单击“作业运行历史”页签。
- 查看Spark引擎作业的运行记录。
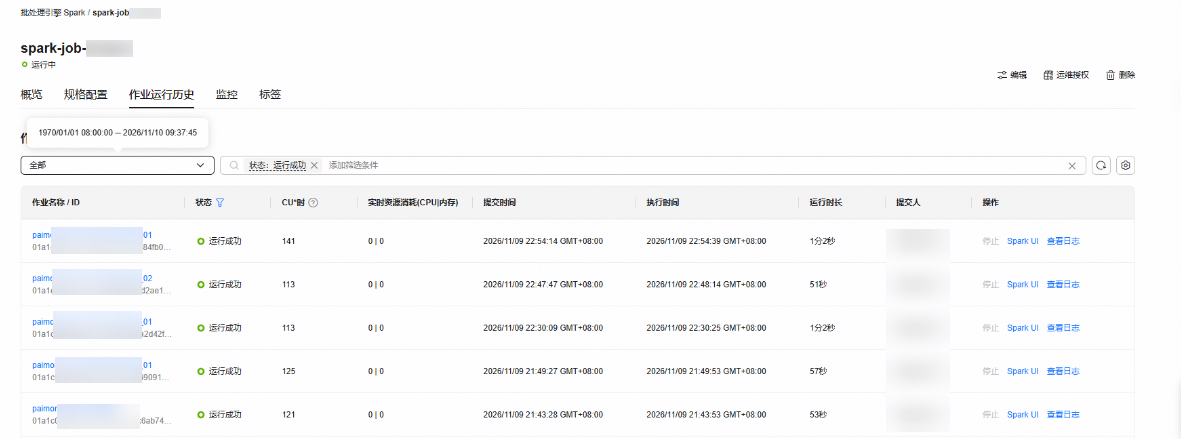
- 查看作业基本信息:作业列表中可以查看作业名称/ID、状态、提交时间、执行时间、运行时长、提交人等信息。
- 查看CU*时:展示作业资源消耗的预估折算值(单位CU*秒),运行中作业每分钟更新,已结束作业按最终值固定。
由于不同Pod的实际规格各异,简单按核数累加无法体现内存差异,系统以1核4G为基准(系数1)统一折算:低规格(1u2g)系数0.83,高规格(1u8g)系数1.33,确保不同规格Pod的消耗能公平累计。具体的折算规则如下:
- 判定档位
按Pod实际内存与CPU的比例(ratio = 内存GB ÷ CPU核数)判定档位:
表2 档位与折算系数 ratio范围
资源规整档位
折算系数
ratio ≤ 2
1u2g
0.83
2 < ratio ≤ 4
1u4g
1
4 < ratio ≤ 8
1u8g
1.33
ratio > 8
1u8g
1.33
- 计算估算CU*时
单Pod估算CU*秒 = CPU核数 × 折算系数 × 运行时长
作业估算CU*秒 = 该作业所有计入Pod的估算CU*秒之和
以某作业运行1小时,包含3个Pod为例
表3 计算估算CU*时 Pod
实际规格
档位
折算系数
估算CU*秒
Pod1
1u2g
1u2g
0.83
0.83*3600
Pod2
1u4g
1u4g
1
1.00*3600
Pod3
1u8g
1u8g
1.33
1.33*3600
该作业估算CU*时 = 0.83*3600 + 1.00*3600 + 1.33*3600 = 11376 CU*秒

该值为预估值,与最终账单可能存在统计口径差异,最终计费以实际发放资源与账单为准。
- 判定档位
- 查看实时资源消耗(CPU|内存):展示作业运行中的实时CPU(核)和内存(MB)使用量,数据每分钟刷新。
- 查看日志:单击Spark历史作业列表“操作”列的“查看日志”,即可直接查看日志信息。
- 查看Spark UI:单击Spark历史作业列表“操作”列的“Web UI”,可以在Spark UI中查看作业运行信息。
查看Flink作业历史
- 登录AI DataLake管理控制台。
- 在页面左上角切换至对应的工作空间。
- 在左侧导航栏选择“作业开发 > 作业运行历史”进入作业运行历史页面。
在列表上方可以根据作业的名称、ID、状态等关键词进行搜索。
- 在“作业运行历史”页面中,选择“流处理引擎 Flink”页签,查看Flink引擎作业的运行记录。
- 查看作业基本信息:作业列表中可以查看作业名称/ID、端点名称、状态、作业类型、提交时间、执行时间、运行时长、提交人等信息。
- 查看作业详情信息:单击作业名称,在展开的页面中可以查看作业的基本信息和作业配置信息。
- 查看归档日志:单击“操作”列的“查看日志”,系统跳转到OBS页面,可以在对应作业日志的OBS路径中查看日志信息。
- 查看Flink UI:单击Flink历史作业列表中状态为“运行中”的作业“操作”列的“Flink UI”,可以查看作业运行信息。


