


上报Trace数据
Trace数据用于记录智能体的单次请求详情,包括调用链路、节点耗时、模型输入输出等。
下面以Python语言开发的智能体为例,介绍如何将Trace数据上报至AgentArts观测平台。

- 第三方智能体上报的Trace数据将直接写入您的华为云应用性能管理APM服务。APM会根据上报的数据量按需计费。为避免在生产环境因大并发测试产生意外费用,请在部署前仔细阅读APM计费说明。
- Trace数据单租户每分钟最多接入20万个Span,当接入数据量超过该限制时,系统将触发限流。
安装依赖库
安装OpenTelemetry Python SDK及相关依赖库。要求Python 3.9或以上版本。
pip install opentelemetry-distro==0.66b1
pip install opentelemetry-api==1.45.1
pip install opentelemetry-exporter-otlp==1.45.1
pip install traceloop-sdk==0.60.0
获取上报参数
- 在AgentArts平台左侧导航栏中选择“观测与优化 > 观测”,并进入“智能体列表”页面。
- 单击“智能体接入”,填写智能体名称,并选择类型。类型按实际选择。 图1 智能体接入

- 填写完成后,单击“创建”,单击“下一步”等待平台自动创建接入信息,记录接入地址、鉴权信息、智能体ID等信息。请妥善保管该信息。
表1 接入信息说明 参数
说明
agent_id
智能体ID。
trace_endpoint
Trace数据接入地址。
trace_token
Trace上报鉴权Token。
图2 获取接入地址、鉴权信息、智能体ID等信息

上报Trace数据
上报Trace数据示例代码:
本示例为连通性测试示例,用于首次接入AgentArts时验证上报地址、Token和智能体ID是否匹配正确,并确认平台能否正常接收数据。此阶段使用手动构造的静态数据。
示例中的智能体ID、智能体名称、您的Trace接入地址等参数值,请参考获取上报参数获取。
import os
import time
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.sdk.trace.export import BatchSpanProcessor

# 1. 替换为您的真实接入凭证
AGENT_ID = "您的智能体ID"
AGENT_NAME = "您的智能体名称"
DOMAIN_ID = "您的华为云账号ID"
TRACE_ENDPOINT = "您的Trace接入地址"
TRACE_TOKEN = "您的Trace鉴权Token"

# 2. 配置 OTel 环境变量
os.environ["OTEL_SERVICE_NAME"] = f"AgentArts.{AGENT_ID}.default"
os.environ["OTEL_EXPORTER_OTLP_TRACES_HEADERS"] = f"Authentication={TRACE_TOKEN}"
os.environ["OTEL_EXPORTER_OTLP_TRACES_ENDPOINT"] = TRACE_ENDPOINT
os.environ["OTEL_EXPORTER_OTLP_TRACES_INSECURE"] = "true"

tracer_provider = TracerProvider()
tracer_provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(tracer_provider)
tracer = trace.get_tracer(__name__)

def test_connection():
    # 模拟数据专用的会话 ID 与用户 ID
    mock_session_id = "test_session_12345"
    mock_user_id = "test_user"

    # 初始化 Token 累加器,用于汇总所有 LLM Span 的 Token 消耗
    total_input_tokens = 0
    total_output_tokens = 0
    total_tokens = 0

    # 创建 AGENT Span(根节点)
    with tracer.start_as_current_span("test_user_request") as root:
        root.set_attribute("gen_ai.span.kind", "AGENT")
        root.set_attribute("gen_ai.operation.name", "invoke_agent")
        root.set_attribute("gen_ai.resource.id", AGENT_ID)
        root.set_attribute("gen_ai.resource.type", "agent")
        root.set_attribute("gen_ai.agent.name", AGENT_NAME)
        root.set_attribute("gen_ai.conversation.id", mock_session_id)
        root.set_attribute("gen_ai.user.id", mock_user_id)
        root.set_attribute("domain.id", DOMAIN_ID)
        root.set_attribute("gen_ai.input.messages", '[{"role":"user","parts":[{"type":"text","content":"测试输入"}]}]')

        # 创建 LLM Span(大模型子节点)
        with tracer.start_as_current_span("test_llm_call") as model_span:
            model_span.set_attribute("gen_ai.span.kind", "LLM")
            model_span.set_attribute("gen_ai.operation.name", "chat")
            model_span.set_attribute("gen_ai.resource.id", AGENT_ID)
            model_span.set_attribute("gen_ai.resource.type", "agent")
            model_span.set_attribute("gen_ai.agent.name", AGENT_NAME)
            model_span.set_attribute("gen_ai.conversation.id", mock_session_id)
            model_span.set_attribute("gen_ai.user.id", mock_user_id)
            model_span.set_attribute("gen_ai.request.model", "deepseek-v4.1-flash")
            model_span.set_attribute("gen_ai.input.messages", '[{"role":"user","parts":[{"type":"text","content":"测试输入"}]}]')

            # 【注意】此处为模拟数据,仅供测试连通性,实际场景需要从真实的响应中提取参数
            time.sleep(0.5)

            model_span.set_attribute("gen_ai.response.model", "deepseek-v4.1-flash")
            model_span.set_attribute("gen_ai.response.finish_reasons", '["stop"]')
            model_span.set_attribute("gen_ai.response.time_to_first_token", 128)
            model_span.set_attribute("gen_ai.output.messages", '[{"role":"assistant","parts":[{"type":"text","content":"测试输出"}]}]')
            model_span.set_attribute("gen_ai.usage.input_tokens", 100)
            model_span.set_attribute("gen_ai.usage.output_tokens", 200)
            model_span.set_attribute("gen_ai.usage.total_tokens", 300)

            # 将本次 LLM Span 的 Token 消耗累加至总计
            total_input_tokens += 100
            total_output_tokens += 200
            total_tokens += 300

        root.set_attribute("gen_ai.output.messages", '[{"role":"assistant","parts":[{"type":"text","content":"测试输出"}]}]')
        # 将所有 LLM Span 的 Token 消耗累加后统一写入 AGENT Span
        # 若请求中存在多个 LLM Span,AGENT Span 上的值为所有节点的 Token 消耗总和
        root.set_attribute("gen_ai.usage.input_tokens", total_input_tokens)
        root.set_attribute("gen_ai.usage.output_tokens", total_output_tokens)
        root.set_attribute("gen_ai.usage.total_tokens", total_tokens)

if __name__ == "__main__":
    test_connection()
    tracer_provider.shutdown() # 刷新数据至服务端
print("测试 Trace 数据已发送,请前往 AgentArts 控制台查看。") 为了保证您的第三方Trace数据能够被AgentArts观测控制台正确识别、解析并展示在各种分析图表中,您在手动埋点上报时,必须严格遵守以下字段命名与数据类型规范。关于所有可设置的Attribute字段及含义,请参考OpenTelemetry协议字段映射。
| Attribute | 是否必填 | 说明 |
|---|---|---|
| gen_ai.span.kind | 是 | Span类型。AGENT Span填写"AGENT",LLM Span填写"LLM",TOOL Span填写"TOOL",STEP Span填写"STEP"。 |
| gen_ai.operation.name | 否 | 操作名称。AGENT填"invoke_agent",LLM填"chat",TOOL填"execute_tool"。 |
| gen_ai.resource.id | 是 | 智能体ID,直接作为字符串写入。每个Span(含子Span)都必须设置,否则平台页面路由拼接会出错。 |
| gen_ai.resource.type | 是 | 资源类型,默认填写"agent"。 |
| gen_ai.conversation.id | 是 | 用户本次对话的唯一会话ID。用于在平台"会话分析"中串联并还原上下文。 |
| gen_ai.user.id | 推荐 | 用户ID,智能体应用的C端用户标识。 |
| gen_ai.agent.name | 是 | 智能体名称。 |
| domain.id | 推荐 | 账号ID,用于租户之间的数据安全隔离。 |
| gen_ai.request.model | 否 | 调用的模型名称(如“deepseek-v4.1-flash”)。仅LLM Span需要上报。 |
| gen_ai.response.model | 否 | 响应模型名称(如“deepseek-v4.1-flash”)。仅LLM Span需要上报。 |
| gen_ai.response.finish_reasons | 否 | 模型返回的结束原因,如["stop"]。仅LLM Span需要上报。 |
| gen_ai.usage.input_tokens | 是 | 输入Token消耗量。需在LLM Span和AGENT Span上同时设置,否则平台"会话分析"和"调用链分析"中的Tokens统计将显示为0。AGENT Span上的值应为本次请求中所有LLM Span输入Token消耗的累加总和;若只有一个LLM Span,则直接取该节点的值。 |
| gen_ai.usage.output_tokens | 是 | 输出Token消耗量。需在LLM Span和AGENT Span上同时设置,否则平台"会话分析"和"调用链分析"中的Tokens统计将显示为0。AGENT Span上的值应为本次请求中所有LLM Span输出Token消耗的累加总和;若只有一个LLM Span,则直接取该节点的值。 |
| gen_ai.usage.total_tokens | 是 | Token总数(输入+输出)。需在LLM Span和AGENT Span上同时设置。 |
| gen_ai.usage.cache_read.input_tokens | 否 | 缓存命中的输入Token数。仅LLM Span需要上报。 |
| gen_ai.usage.cache_creation.input_tokens | 否 | 缓存写入的输入Token数。仅LLM Span需要上报。 |
| gen_ai.response.time_to_first_token | 否 | 流式输出时的首Token耗时(ms)。仅LLM Span需要上报。 |
| gen_ai.input.messages | 推荐 | 当前节点的输入消息(JSON格式)。AGENT节点为用户提问,LLM节点为模型输入。示例:[{"role":"user","parts":[{"type":"text","content":"你好"}]}] |
| gen_ai.output.messages | 推荐 | 当前节点的输出消息(JSON格式)。AGENT节点为智能体回答,LLM节点为模型生成文本。示例:[{"role":"assistant","parts":[{"type":"text","content":"你好!"}]}] |
| gen_ai.tool.name | 否 | 工具名称。仅TOOL Span需要上报。 |
| gen_ai.tool.call.arguments | 否 | 工具调用参数(JSON格式)。仅TOOL Span需要上报。 |
| gen_ai.tool.call.result | 否 | 工具返回结果。仅TOOL Span需要上报。 |
| gen_ai.skill.name | 否 | Skill名称。当TOOL Span表示Skill调用时上报。 |
| gen_ai.skill.id | 否 | Skill唯一标识ID。当TOOL Span表示Skill调用时上报。 |
| gen_ai.skill.version | 否 | Skill版本。当TOOL Span表示Skill调用时上报。 |
查看上报数据
数据上报后,在“观测与优化 > 观测 > 智能体列表”页面,单击对应的智能体名称,在“调用链分析”中可以看到调用链数据。

示例:真实对话中的Trace(调用链)数据上报
本示例中的脚本会启动一个本地交互式终端,您可以像聊天一样在终端输入问题跟智能体对话。在对话过程中,代码会自动创建AGENT Span(根节点)、TOOL Span(工具调用)和LLM Span(大模型调用)三层Span,并在调用模型成功后,动态提取真实的提问、回复、Token消耗以及网络耗时上报给AgentArts。
本地环境准备与依赖安装:
请在您的电脑终端(Windows的CMD或macOS/Linux的Terminal)中执行以下命令,安装所需的Python依赖库:
pip install opentelemetry-api==1.45.1
pip install opentelemetry-sdk==1.45.1
pip install opentelemetry-exporter-otlp==1.45.1
pip install openai==1.55.3
pip install "httpx<0.28"
pip install python-dotenv==1.0.0
配置环境变量:
安装完成后,在您的代码文件夹下创建一个名为.env的文本文件。填写华为云MaaS服务的模型API Key和AgentArts平台上获取的真实凭证:
# ==========================================
# 1. 智能体大模型的 API 凭证(以接入 MaaS 的 OpenAI 兼容接口为例)
# ==========================================
MODEL_NAME=deepseek-v4.1-flash
MODEL_URL=https://api.modelarts-maas.com/openai/v1
MODEL_API_KEY=换成在MaaS上申请的模型API_Key

# ==========================================
# 2. 华为云 AgentArts 观测接入凭证
# ==========================================
AGENT_NAME=换成智能体名称
AGENT_ID=换成智能体ID
DOMAIN_ID=换成华为云账号ID(在控制台右上角“我的凭证”中复制,不要填假数据,否则会被平台隔离过滤)
USER_ID=换成华为云IAM用户ID(在控制台右上角“我的凭证”中复制,不要填假数据,否则会被平台隔离过滤)

# Trace 上报通道配置
TRACE_ENDPOINT=换成Trace数据接入地址(示例:https://apm-access.cn-southwest-2.myhuaweicloud.com)
TRACE_TOKEN=换成Trace上报鉴权Token
| 参数 | 说明 |
|---|---|
| MODEL_NAME | 华为云MaaS服务的模型名称。取值为OpenAI兼容接口中的model参数。 图4 模型名称 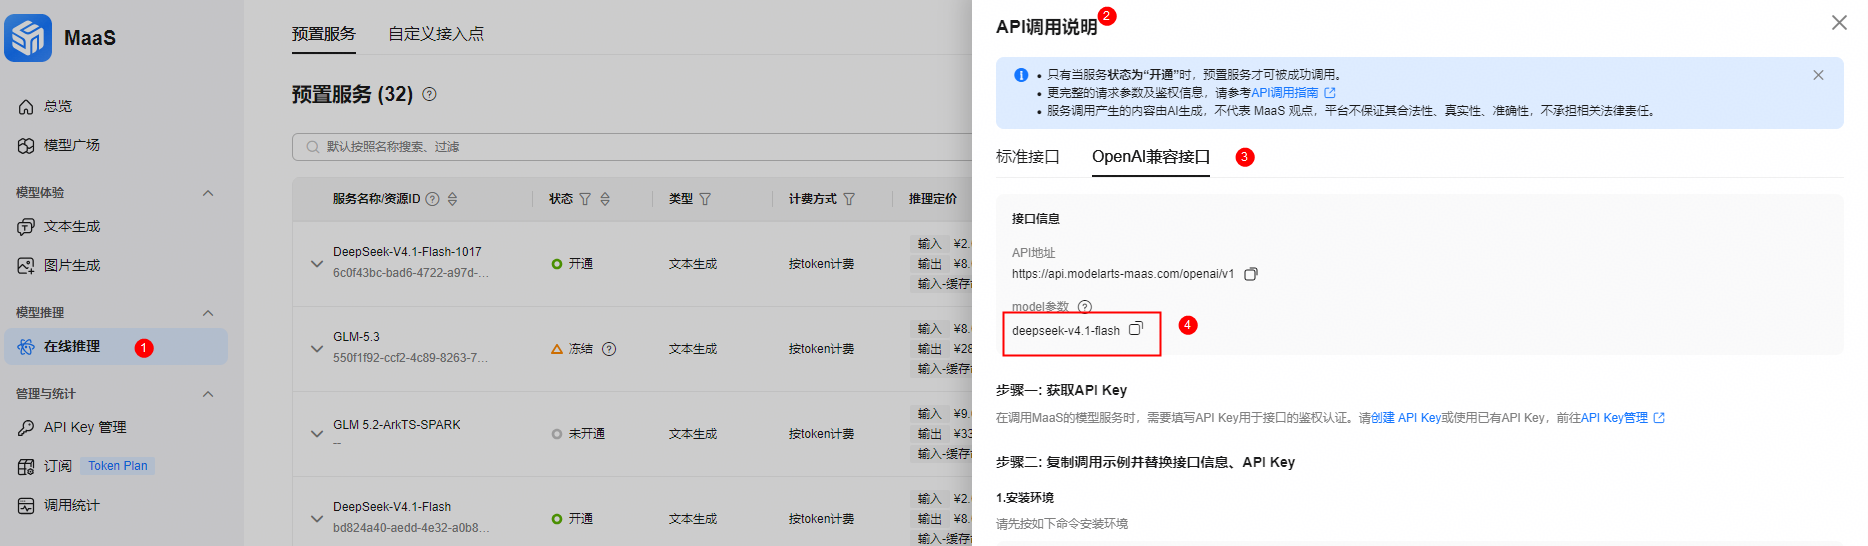 |
| MODEL_URL | 华为云MaaS服务的模型URL,采用OpenAI兼容接口。取值为:https://api.modelarts-maas.com/openai/v1。 |
| MODEL_API_KEY | 华为云MaaS服务的模型API Key,请登录MaaS服务获取。 图5 模型API Key  |
| TRACE_ENDPOINT TRACE_TOKEN AGENT_ID AGENT_NAME | Trace数据接入地址、Trace上报鉴权Token、智能体ID、智能体名称,从接入指南中获取。 图6 获取接入地址、鉴权信息、智能体ID等信息  |
| DOMAIN_ID USER_ID | 华为云账号ID、华为云IAM用户ID, 请登录“我的凭证 > API凭证”页面获取。 图7 获取domain id、user id  |
编写智能体调用及数据上报脚本:
创建一个名为agent_trace.py的代码文件,并填写如下内容:
import os
import time
import uuid
from openai import OpenAI
from dotenv import load_dotenv
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.sdk.trace.export import BatchSpanProcessor

# 自动加载同目录下的 .env 文件
load_dotenv()

# 读取配置参数
AGENT_ID = os.getenv("AGENT_ID")
AGENT_NAME = os.getenv("AGENT_NAME")
DOMAIN_ID = os.getenv("DOMAIN_ID")
TRACE_ENDPOINT = os.getenv("TRACE_ENDPOINT")
TRACE_TOKEN = os.getenv("TRACE_TOKEN")
USER_ID = os.getenv("USER_ID")

# 配置标准 OTel 环境变量
os.environ["OTEL_SERVICE_NAME"] = f"AgentArts.{AGENT_ID}.default"
os.environ["OTEL_EXPORTER_OTLP_TRACES_HEADERS"] = f"Authentication={TRACE_TOKEN}"
os.environ["OTEL_EXPORTER_OTLP_TRACES_ENDPOINT"] = TRACE_ENDPOINT
os.environ["OTEL_EXPORTER_OTLP_TRACES_INSECURE"] = "true"

# 初始化 OTel Tracer 提供者
tracer_provider = TracerProvider()
tracer_provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(tracer_provider)
tracer = trace.get_tracer(__name__)

# 模拟工具函数:搜索产品信息
def search_product(keyword: str) -> str:
    """模拟工具调用,返回产品信息"""
    products = {
        "ECS": "弹性云服务器,提供安全可靠、弹性伸缩的云服务器。",
        "RDS": "关系型数据库服务,支持MySQL/PostgreSQL/SQL Server。",
        "OBS": "对象存储服务,海量、安全、高可靠的云存储。",
    }
    return products.get(keyword.upper(), f"未找到 '{keyword}' 相关产品")

def chat_with_agent(user_query: str, session_id: str):
    """模拟与智能体对话,并在执行过程中自动上报 Trace 链路数据"""
    client = OpenAI(
        api_key=os.getenv("MODEL_API_KEY"),
        base_url=os.getenv("MODEL_URL")
    )

    # 初始化 Token 累加器,用于汇总本次请求中所有 LLM Span 的 Token 消耗
    total_input_tokens = 0
    total_output_tokens = 0
    total_tokens = 0

    # 1. 启动 AGENT Span(根节点),记录整个交互会话的生命周期
    with tracer.start_as_current_span("agent_dialogue_session") as root_span:
        root_span.set_attribute("gen_ai.span.kind", "AGENT")
        root_span.set_attribute("gen_ai.operation.name", "invoke_agent")
        root_span.set_attribute("gen_ai.resource.id", AGENT_ID)
        root_span.set_attribute("gen_ai.resource.type", "agent")
        root_span.set_attribute("gen_ai.agent.name", AGENT_NAME)
        root_span.set_attribute("gen_ai.conversation.id", session_id)
        root_span.set_attribute("gen_ai.user.id", USER_ID)
        root_span.set_attribute("domain.id", DOMAIN_ID)
        root_span.set_attribute("gen_ai.input.messages", f'[{{"role":"user","parts":[{{"type":"text","content":"{user_query}"}}]}}]')

        # 2. 启动 TOOL Span,记录工具调用(本例模拟一个Skill工具调用)
        tool_result = search_product(user_query)
        with tracer.start_as_current_span("execute_search_tool") as tool_span:
            tool_span.set_attribute("gen_ai.span.kind", "TOOL")
            tool_span.set_attribute("gen_ai.operation.name", "execute_tool")
            tool_span.set_attribute("gen_ai.resource.id", AGENT_ID)
            tool_span.set_attribute("gen_ai.resource.type", "agent")
            tool_span.set_attribute("gen_ai.conversation.id", session_id)
            tool_span.set_attribute("gen_ai.user.id", USER_ID)
            tool_span.set_attribute("gen_ai.tool.name", "search_product")
            tool_span.set_attribute("gen_ai.tool.call.arguments", f'{{"keyword":"{user_query}"}}')
            tool_span.set_attribute("gen_ai.tool.call.result", tool_result)
            tool_span.set_attribute("gen_ai.tool.type", "function")
            # 当工具调用涉及Skill时,上报gen_ai.skill.*属性
            tool_span.set_attribute("gen_ai.skill.id", "skill_search_001")
            tool_span.set_attribute("gen_ai.skill.name", "product_search")
            tool_span.set_attribute("gen_ai.skill.version", "0.1.0")

        # 3. 启动 LLM Span,记录大模型推理过程
        with tracer.start_as_current_span("llm_inference_call") as model_span:
            model_span.set_attribute("gen_ai.span.kind", "LLM")
            model_span.set_attribute("gen_ai.operation.name", "chat")
            # 子节点上也必须携带资源 ID 与类型,防止 URN 路径拼接错乱
            model_span.set_attribute("gen_ai.resource.id", AGENT_ID)
            model_span.set_attribute("gen_ai.resource.type", "agent")
            model_span.set_attribute("gen_ai.agent.name", AGENT_NAME)
            model_span.set_attribute("gen_ai.conversation.id", session_id)
            model_span.set_attribute("gen_ai.user.id", USER_ID)
            model_span.set_attribute("gen_ai.request.model", os.getenv("MODEL_NAME"))
            model_span.set_attribute("gen_ai.input.messages", f'[{{"role":"user","parts":[{{"type":"text","content":"{user_query}"}}]}}]')

            # 记录大模型 API 网络调用开始时间
            start_time = time.time()

            # 构造带工具结果的上下文消息,发起真实的大模型对话调用(流式模式以捕获首Token时延)
            context_messages = [
                {"role": "user", "content": user_query},
                {"role": "tool", "content": tool_result}
            ]
            stream = client.chat.completions.create(
                model=os.getenv("MODEL_NAME"),
                messages=context_messages,
                stream=True,
                stream_options={"include_usage": True}
            )

            # 捕获首Token时延(从请求发出到收到第一个chunk的时间,单位毫秒)
            first_chunk = next(stream)
            ttft = int((time.time() - start_time) * 1000)
            response_content = first_chunk.choices[0].delta.content or ""

            # 拼接完整响应内容,并从最后一个chunk提取finish_reason和usage
            finish_reason = "stop"
            usage = None
            for chunk in stream:
                if chunk.choices:
                    delta = chunk.choices[0].delta
                    if delta and delta.content:
                        response_content += delta.content
                    if chunk.choices[0].finish_reason:
                        finish_reason = chunk.choices[0].finish_reason
                if hasattr(chunk, "usage") and chunk.usage is not None:
                    usage = chunk.usage

            # 计算大模型请求总时延
            duration = time.time() - start_time

            # 将真实捕获的运行时参数动态注入 LLM Span 属性中
            model_span.set_attribute("gen_ai.response.model", os.getenv("MODEL_NAME"))
            model_span.set_attribute("gen_ai.response.finish_reasons", f'["{finish_reason}"]')
            model_span.set_attribute("gen_ai.response.time_to_first_token", ttft)
            model_span.set_attribute("gen_ai.output.messages", f'[{{"role":"assistant","parts":[{{"type":"text","content":"{response_content}"}}]}}]')
            model_span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens if usage else 0)
            model_span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens if usage else 0)
            model_span.set_attribute("gen_ai.usage.total_tokens", usage.total_tokens if usage else 0)

            # 将本次 LLM Span 的 Token 消耗累加至总计
            total_input_tokens += usage.prompt_tokens
            total_output_tokens += usage.completion_tokens
            total_tokens += usage.total_tokens

        # 在 AGENT Span 上记录最终输出答案,保证调用链树根节点的输入/输出展示完整
        root_span.set_attribute("gen_ai.output.messages", f'[{{"role":"assistant","parts":[{{"type":"text","content":"{response_content}"}}]}}]')
        # 将所有 LLM Span 的 Token 消耗累加后统一写入 AGENT Span
        # 若请求中存在多个 LLM Span,AGENT Span 上的值为所有节点的 Token 消耗总和
        root_span.set_attribute("gen_ai.usage.input_tokens", total_input_tokens)
        root_span.set_attribute("gen_ai.usage.output_tokens", total_output_tokens)
        root_span.set_attribute("gen_ai.usage.total_tokens", total_tokens)

        return response_content

if __name__ == "__main__":
    # 动态生成本轮对话的唯一会话 ID,保证在平台"会话分析"中能聚合在一起
    current_session_id = f"sess-{uuid.uuid4().hex[:12]}"
    print(f"==================================================")
    print(f" 智能体运行时已启动!会话 ID: {current_session_id}")
    print(f"==================================================")

    while True:
        user_input = input("\nUser: ")
        if user_input.strip().lower() in ["exit", "quit", "q"]:
            print("正在退出并刷新数据上报...")
            break

        print("智能体正在思考并上报调用链...")
        reply = chat_with_agent(user_input, current_session_id)
        print(f"Agent: {reply}")

    # 刷新 Trace 缓冲并一键上传
    tracer_provider.shutdown()
    print("数据刷新上报完成!")
执行测试,验证上报数据:
在您的代码文件夹下,打开终端并运行:
python agent_trace.py
运行后,可与智能体进行会话,可通过Ctrl+C命令退出会话。退出后,登录AgentArts平台,在“观测与优化 > 观测 > 智能体列表”页面,单击对应的智能体名称。在“调用链分析”中可以看到调用链数据。


常见问题
- 运行代码后,观测页面看不到Trace数据怎么办?
请按以下顺序排查:
- 检查接入参数:确认agent_id、trace_endpoint、trace_token是否与数据上报准备中获取的信息一致。
- 检查服务名称格式:确认OTEL_SERVICE_NAME遵循AgentArts.{智能体ID}.default格式。
- 检查网络连通性:确认网络是否能连通Trace接入地址。
- 等待数据同步:数据上报后通常需要几分钟才能在观测页面展示,请稍后再查看。
- 为什么在平台“调用链分析”中,单击模型节点的“指标”页签时报错,或者F12抓包发现后端API路径中出现了双斜杠(如/agent//span/...)
原因:出现该报错是由于您只在最外层的根节点(Root Span)上设置了智能体URN关联属性,而漏掉了在模型节点(Model Span)上设置gen_ai.resource.id和gen_ai.resource.type属性。
在AgentArts观测功能中,当您单击不同的节点查看调用链的Span详情时,页面会实时读取该节点上的属性来拼接查询API路径。如果模型节点缺少了这两个属性,路径就会因为缺省而拼错(出现双斜杠),导致页面请求报错、数据无法展示。
解决方案:在您的代码中,不仅要给最外层的Root Span设参,每一个内部创建的子Span(如大模型调用)也必须强制上报这两个对齐标签:with tracer.start_as_current_span("test_llm_call") as model_span: # 必须给子节点也绑定智能体ID和资源类型,保证页面路由拼接正常 model_span.set_attribute("gen_ai.resource.id", AGENT_ID) model_span.set_attribute("gen_ai.resource.type", "agent") model_span.set_attribute("gen_ai.span.type", "LLM") # ... 后续属性图10 报错样例
- 为什么在平台“会话分析”或“调用链分析”中,Tokens列显示为0?
原因:Token相关字段(gen_ai.usage.input_tokens、gen_ai.usage.output_tokens)仅在Model Span上设置,而未在Root Span上同步设置。平台在统计会话/Trace维度的Token消耗时,读取的是Root Span上的Token字段,若Root Span缺少这些字段,则统计结果将显示为0。
解决方案:需在Root Span关闭前,将本次请求中所有Model Span的Token消耗累加后,统一写入Root Span。若请求中只有一个Model Span,直接取该节点的值;若存在多个Model Span,则需逐一累加后再写入:# 在 Root Span 外层初始化 Token 累加器 total_input_tokens = 0 total_output_tokens = 0 # 每个 Model Span 结束后累加 total_input_tokens += usage.prompt_tokens total_output_tokens += usage.completion_tokens # Root Span 关闭前,将累加结果统一写入 root_span.set_attribute("gen_ai.usage.input_tokens", total_input_tokens) root_span.set_attribute("gen_ai.usage.output_tokens", total_output_tokens) - Trace数据上报失败:Transient error StatusCode.UNAVAILABLE encountered while exporting...
原因:替换TRACE_ENDPOINT环境变量时,接入地址缺少https://协议前缀,系统无法识别目标服务地址格式,导致连接失败。
解决方案:确保TRACE_ENDPOINT配置值包含完整协议前缀,例如TRACE_ENDPOINT=https://apm-access.cn-southwest-2.myhuaweicloud.com,修改后重新上报。


