


模型混淆
在企业将自有模型部署至云端推理时,模型参数在内存中明文存在,存在核心资产泄露风险。华为云数据安全中心(DSC)提供模型混淆功能,通过对模型算子注入混淆因子,在NPU侧独立的混淆环境中部署混淆算子,使模型推理过程以混淆态运行,原始模型权重不以明文暴露于内存中,有效防止模型在云端推理过程中被窃取或逆向还原,保障企业核心AI资产安全。
基本概念
使用模型混淆功能前,先了解以下名词的含义:
- ModelArts / 开源AI平台:顶层AI平台,提供模型训练、部署和推理的运行环境。
- Host(主机):主机层,运行容器、AI软件栈和大模型推理服务。
- 容器:隔离运行环境,承载大模型推理服务。
- AI软件栈:连接上层 AI 框架与底层芯片硬件的计算中间件。
- 大模型推理服务:在容器中运行的大模型推理引擎。
- NPU Device 1:NPU加速卡,支持多机多卡并行推理。
- AI Core:NPU的核心计算单元,执行实际运算。
- 常规算子:NPU上的标准AI计算算子。
- 混淆环境:执行混淆算子的运算环境。
- 混淆算子:经过混淆处理的特殊算子,与常规算子协同完成受保护推理。
- 混淆 SDK:模型混淆和推理数据混淆的SDK,负责将模型转换为混淆模型,以及推理请求的混淆和推理结果的解混淆。
- 混淆因子:混淆参数(如Seed),驱动混淆算子的行为。不同模型不建议使用相同混淆因子。
应用场景
- 企业大模型上云:企业将自研或微调的大模型部署到行业云推理服务,需防止模型权重在云端被窃取。
- 敏感数据推理服务:金融、政务、医疗等行业用户使用云端大模型处理敏感数据,需确保提示词与推理结果不被云端获取。
- 多租户 AI 平台:AI平台为多租户提供共享推理服务,需在租户间实现数据与模型隔离,防止跨租户泄露。
方案架构
DSC模型混淆功能通过对AI模型注入混淆因子,在NPU侧的混淆环境中部署混淆算子,实现模型推理过程中的权重、输入输出数据的保护。
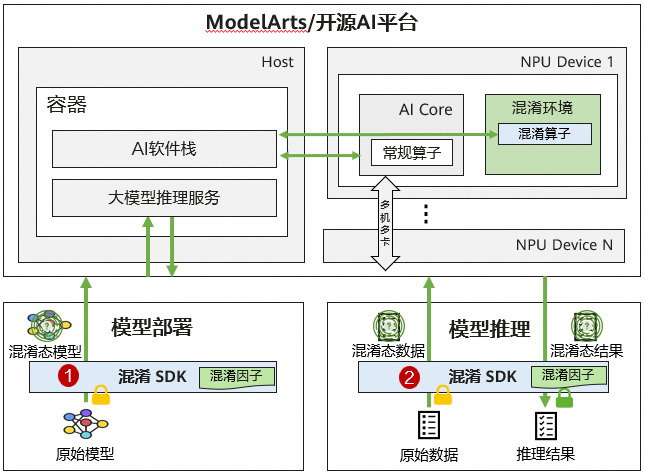
模型混淆的两大流程:
- 模型部署:原始模型 → 混淆SDK(加载混淆因子,执行混淆)→ 混淆模型 → 部署到推理环境。
- 模型推理:原始推理数据 → 混淆SDK → 混淆态推理数据 → 云上推理环境 → 混淆态推理结果 → 混淆SDK → 原始推理结果。
方案优势
- 高安全:模型和数据(文本/图片/视频)端到端混淆,全链路无明文流转。
- 易改造:原生适配现有推理框架MindIE和vLLM,支持DeepSeek、Qwen。
- 高能效:不依赖TEE等机密计算硬件,推理性能和精度很高。
前提条件
已购买数据安全屋。
执行模型混淆
对模型权重进行混淆保护,支持多种模型类型和自定义配置。
支持的模型类型
| 模型类型 | 模型名称 |
|---|---|
| DeepSeek | DeepSeek-V3、DeepSeek-R1 |
| Qwen2.5 | Qwen2.5-0.5B、Qwen2.5-1.5B、Qwen2.5-3B、Qwen2.5-7B、Qwen2.5-14B、Qwen2.5-32B、Qwen2.5-72B |
| Qwen3 | Qwen3-0.6B、Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B、Qwen3-32B、Qwen3-30B-A3B、Qwen3-235B-A22B、 |
| Qwen3-VL | Qwen3-VL-2B、Qwen3-VL-4B、Qwen3-VL-8B、Qwen3-VL-32B、Qwen3-VL-30B-A3B、Qwen3-VL-235B-A22B |
模型混淆示例
from ai_asset_obfuscate import ModelAssetObfuscation, ErrorCode, ModelType

# 创建模型混淆实例
model = ModelAssetObfuscation.create_model_obfuscation(
     model_path="/path/to/model",
     model_type=ModelType.Qwen3,
     tp_num=4
)

# 设置混淆因子,不同模型不建议使用相同混淆因子
result = model.set_seed_content(
     seed_type=1,

# 模型混淆因子
    seed_content="your_seed_content_32_chars_min"
)
 if result != ErrorCode.SUCCESS.value:
     print(f"设置混淆因子失败: {result}")

# 执行模型混淆
result = model.model_weight_obf(
     obf_type=1,  #1:仅使用模型混淆因子, 2:仅使用数据混淆因子
    model_save_path="/path/to/model_save_path",
     device_type = "cpu",
     device_id=[0, 1, 2, 3]
 )
 if result == ErrorCode.SUCCESS.value:
     print("模型混淆成功")
执行数据混淆
对推理数据进行混淆保护,支持一维和二维数据。
数据混淆示例
from ai_asset_obfuscate import DataAssetObfuscation, ErrorCode, ModelType

# 创建数据混淆实例
data_obf = DataAssetObfuscation(
     vocab_size=32000,
     token_white_list=[0, 1]  # 不做混淆的token白名单
)

# 设置混淆因子,不同模型不建议使用相同混淆因子
result = data_obf.set_seed_content(
     seed_content="your_seed_content_32_chars_min",
     is_local_save=False,
     seed_ciphertext_dir=None
)

# 混淆二维数据
tokens = [[1, 2, 3], [4, 5, 6]]
obf_tokens = data_obf.data_2d_obf(tokens)

# 解混淆二维数据
deobf_tokens = data_obf.data_2d_deobf(obf_tokens)
查看模型混淆操作记录
- 登录DSC服务控制台。
- 在左侧导航栏中,选择“数据安全屋”,进入“数据安全屋”控制台。
- 在左侧导航栏中,选择“模型混淆”,查看模型混淆列表,参数说明如表1所示。 图1 模型混淆

- 单击客户端个数,可查看混淆模型中分发的客户端节点的客户端IP和上报时间。
相关文档
数据胶囊:数据胶囊是一种标准化二进制容器格式(文件后缀 .dcap),采用文件头 + 文件体两段式结构,将原始数据、访问策略、加密密钥、权属信息、防篡改签名封装为单一独立文件。文件脱离原系统后仍可独立完成完整性校验、策略鉴权与受控解密,实现数据走到哪里,安全策略跟到哪里


