


更新时间:2026-09-14 GMT+08:00
长期记忆检索机制
长期记忆提供独立的检索能力,支持应用按需查询与复用。提交查询内容和过滤条件后,系统从长期记忆中召回相关候选,依次经过相关性过滤、融合排序,并按配置决定是否精排,最终返回按相关度排序的结果。
图1 长期记忆检索链路
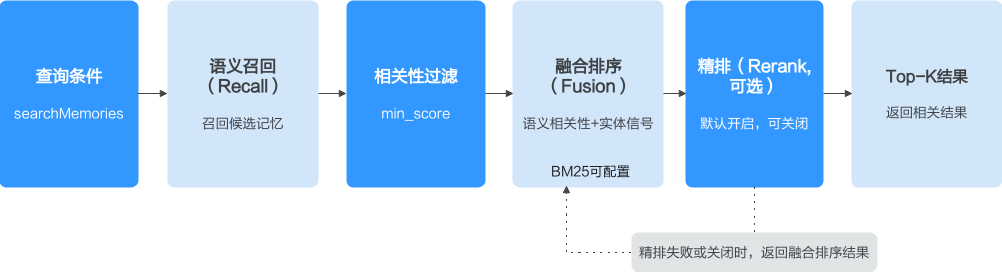
检索流程
- 召回(Recall):系统首先基于查询文本进行语义召回,从长期记忆中获取语义相关的候选记忆。
- 相关性过滤系统:根据min_score过滤低相关候选。min_score取值范围为 0~1,默认值为0.75。
- 融合排序(Fusion):系统综合语义相关性以及已启用的辅助相关性信号,对候选记忆计算综合得分并排序。当前支持实体关联信号,并可配置启用 BM25 词法匹配信号。
- 精排(Rerank,可选):系统支持使用精排模型对候选结果重新打分和排序。精排默认开启,也可以通过全局配置或单次检索请求关闭。精排未开启时,系统回退至融合排序结果。
- 结果返回:系统按照top_k截取排序后的结果并返回。top_k支持配置1~100条,默认返回10条。
检索特点
- 语义召回:长期记忆候选集合由语义检索产生。
- 多信号排序:可结合实体关联、BM25词法匹配等信号优化候选排序。
- 可选精排:支持按需开启或关闭Rerank,以进一步提升结果排序精度。
- 多维过滤:支持按策略、用户、助手、会话、记忆类型和时间范围等条件限制检索范围。
返回结果中的score表示最终相关性得分。开启精排时返回精排得分;未开启精排时返回融合排序得分。
父主题: 工作原理


