


模型介绍
模型管理为用户提供自定义模型服务的统一接入与全生命周期管理能力,实现模型提供商、模型服务和模型代理的一站式配置与运维。
通过模型管理,可以将外部模型提供商(如OpenAI、Anthropic 等)的LLM推理服务接入AgentArts平台,由网关统一管理推理请求的路由、认证和负载均衡,使智能体、记忆库等组件按需调用已配置的模型服务。
核心概念
模型管理包含三个核心概念:模型提供商、模型服务和模型代理。
| 概念 | 说明 |
|---|---|
| 模型提供商 | 模型服务的管理实体,定义统一的访问端点(base_url)、出站身份认证和网络配置。一个模型提供商下可配置多个模型服务,也可关联多个模型代理。 |
| 模型服务 | 具体的模型配置,从属于模型提供商,包含模型名称、API 接口协议和模型类型。 |
| 模型代理 | 连接模型提供商与网关的桥梁,提供统一的推理服务入口。模型代理配置入站身份认证和入站网关,将推理请求路由到关联的模型提供商。 |
三者之间的关系如下:
- 创建模型提供商,配置访问端点和出站认证。
- 在模型提供商下添加模型服务,定义具体的模型名称、协议和类型。
- 关联模型代理,将模型提供商与网关关联,由模型代理提供统一的推理服务访问入口。
工作原理
模型管理支持两种访问方式:私网访问(通过模型代理)和公网访问(直接访问),根据模型提供商的网络配置决定。
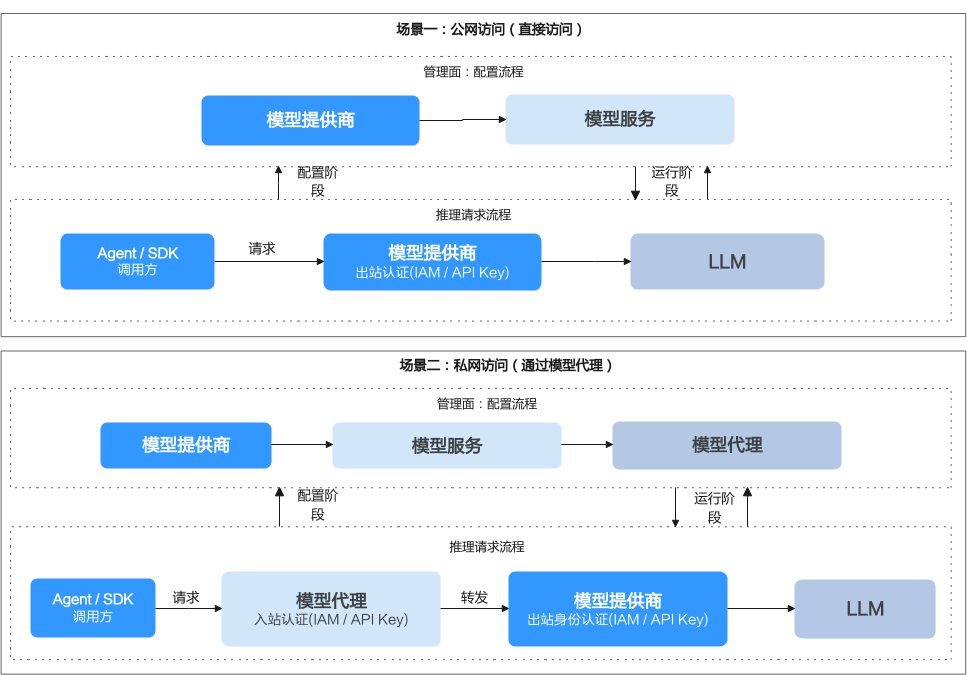
公网访问(直接访问)
- 调用方发起请求:Agent或SDK直接向模型提供商的base_url发起推理请求。
- 出站身份认证:模型供应商下的模型服务的鉴权方式。
- 访问后端:请求被转发到模型提供商后端(如OpenAI、Anthropic等),返回推理结果。
私网访问(通过模型代理)
- 调用方发起请求:Agent或SDK通过 /inference/{path} 向模型代理发起推理请求。
- 入站认证:模型代理验证调用方身份,确保只有授权的调用方才能访问后端模型,防止未授权访问。入站认证在创建模型代理时配置。
- 转发到模型提供商:模型代理将请求转发到关联的模型提供商。
- 出站身份认证:模型供应商下的模型服务的鉴权方式。
- 访问后端:请求被转发到模型提供商后端(如OpenAI、Anthropic等),返回推理结果。
使用流程
支持的API接口协议
模型服务支持三种API接口协议,不同协议对应不同的模型类型和请求路径。
| API接口协议 | 说明 | 支持的模型类型 |
|---|---|---|
| 标准OpenAI协议 | 兼容OpenAI API标准的协议,适用于OpenAI、DeepSeek等模型提供商。 | 文本对话/图像理解、多模态对话、文本向量化、文本排序、实时语音对话 |
| Anthropic协议 | 兼容Anthropic API标准的协议,适用于Anthropic等模型提供商。 | 文本对话/图像理解、Token计数 |
| 华为云MaaS标准API V1 | 华为云Model as a Service标准协议,适用于华为云 MaaS 服务。 | 文本对话/图像理解、文本向量化、文本排序 |
支持的模型类型
每种模型类型对应一个标准请求路径,网关根据模型类型自动路由推理请求。
| 模型类型 | 说明 | 请求路径 | 对应API协议 |
|---|---|---|---|
| 文本对话/图像理解(completions) | 文本生成和图像理解对话 | /v1/chat/completions | 标准OpenAI协议 |
| 多模态对话(responses) | 多模态对话交互 | /v1/responses | 标准OpenAI协议 |
| 文本向量化(embeddings) | 将文本转换为向量表示 | /v1/embeddings | 标准OpenAI协议 |
| 文本排序(rerank) | 对文本进行相关性排序 | /v1/rerank | 标准OpenAI协议 |
| 文本对话/图像理解(messages) | 基于 Anthropic 协议的文本对话 | /v1/messages | Anthropic协议 |
| 实时语音对话(realtime) | 实时语音交互 | /v1/realtime | 标准OpenAI协议 |
| Token计数(token_count) | 计算输入Token数量 | /v1/messages/count_tokens | Anthropic协议 |


