


超节点亲和组实例数配置
场景描述
大模型训练中通常会采取多种并行策略(如模型并行和MoE专家并行),通过分布式计算来提高模型的训练效率和扩展性。其中模型并行中的allreduce通信以及MoE专家并行中的alltoall通信对卡间的互联带宽要求非常高,受限于硬件组网的限制,这些通信密集的阶段常成为训练性能的瓶颈。
昇腾新一代硬件(如Snt9b23和Snt9e)将多个计算节点的NPU进行大带宽互联组成“超节点”。超节点内的这种互联的组网形态称为“超平面”,可以显著提升AI任务的通信效率。基于超节点硬件,模型可以更大范围地调整模型并行策略的参数(如并行或MoE专家并行),从而利用更大的带宽加速训练。
ModelArts在这个基础上,推出了超节点亲和特性,它是一种调度策略,通过对AI训练任务进行编排分组来匹配计算资源的硬件组网形态,以充分利用超节点的高带宽和低延迟特性,提升模型训练执行效率。算法工程师只需通过简单配置即可轻松使用超节点硬件。
原理介绍
如图所示,在训练作业中一个task称为一个实例。为了将训练作业合理地调度到超节点上,并能够充分利用超节点的超高带宽,ModelArts引入了“亲和组”的概念,亲和组是训练任务中期望通过超平面连接的一组实例,同一个亲和组的所有实例会被确保调度到同一超平面内。

如何配置亲和组来提高训练的效率?核心思想是将训练过程中对带宽要求高的卡放到同一个亲和组内。
以TP(Tensor Parallel,张量并行)为例,在Snt9b硬件中,TP通常被设置为8,对应单机8卡的HCCS高速互联。而在超节点中,高速互联的设备数增多了,显然,对应的TP域也可扩大。
- 前提:分布式训练需要每个实例需完全占用节点的所有卡。
假设TP=32,即训练过程中,每32张卡组成一个TP域,而每个节点有16张卡,那么每2个实例需要确保调度到同一个超平面内,这样的2个实例称为一个亲和组。
- 配置:如果TP=32(每32卡为一个TP域),需将2个实例(16卡/实例)调度到同一超平面,因此需设置“超节点亲和组实例数=2”
- 资源调度条件:上述的这个训练作业要实际能够调度执行,还需资源池的可用超节点同时满足如下条件:
- 硬件差异与调度策略。
以下针对不同芯片类型介绍相应的调度策略:
- Snt9b23亲和调度
在Snt9b23硬件的资源池中,每个超节点都有独立的超平面,不同超节点之间的超平面必定不相同,此时超节点的边界等价于超平面的边界。同一个亲和组的所有实例会被确保调度到同一超平面内,等价于同一个亲和组的所有实例会被确保调度到同一超节点内。Snt9b23的亲和组之间默认通过参数面通信。
图2 Snt9b23超节点和超平面示意图
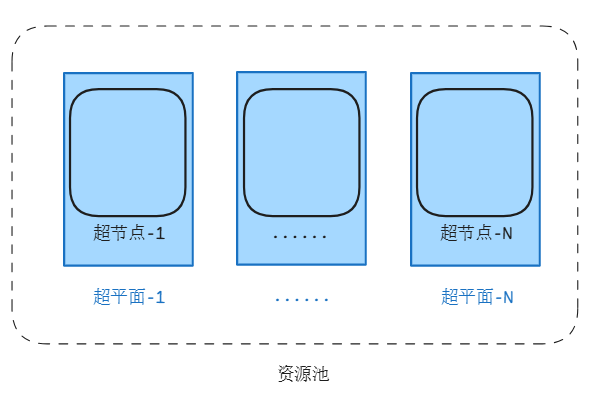 图3 Snt9b23训练作业超节点亲和调度示意图
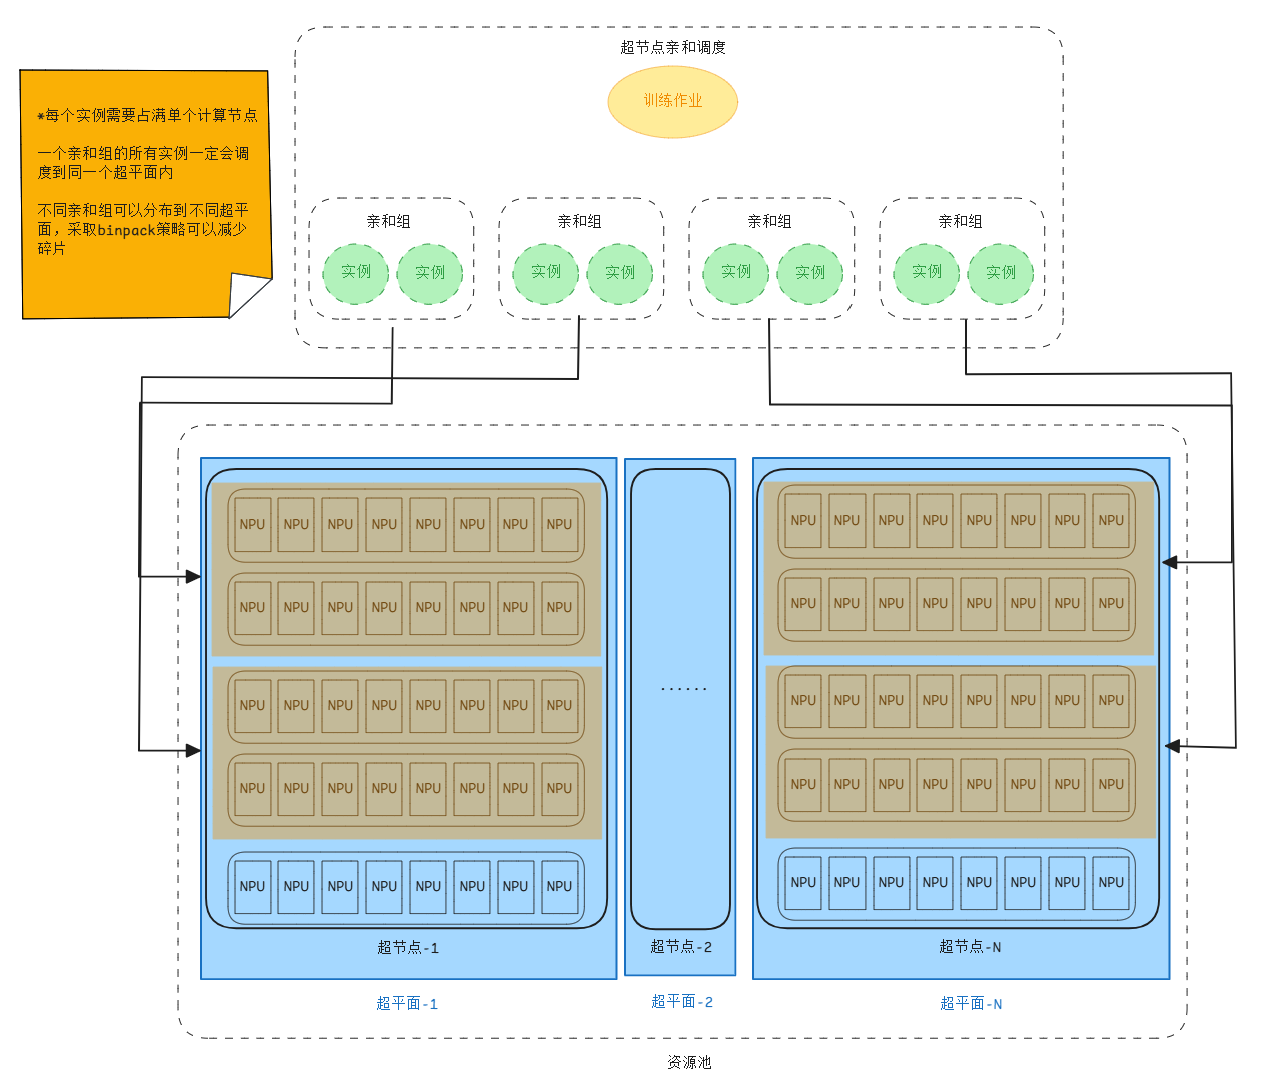
假设该训练作业总共需要8个实例,超节点亲和组实例数设置为2,当前可选的资源情况如下:
资源池A和B可用节点数都为8,条件3.a都满足,但资源池B的超节点3可分配3个亲和组,超节点4只有1个可用节点,可分配0个亲和组,不满足条件3.b,因此只有资源池A可以调度执行该训练作业。如果该训练作业下发到资源池B,会由于当前可用资源不足排队。
- Snt9b/Snt9e亲和调度
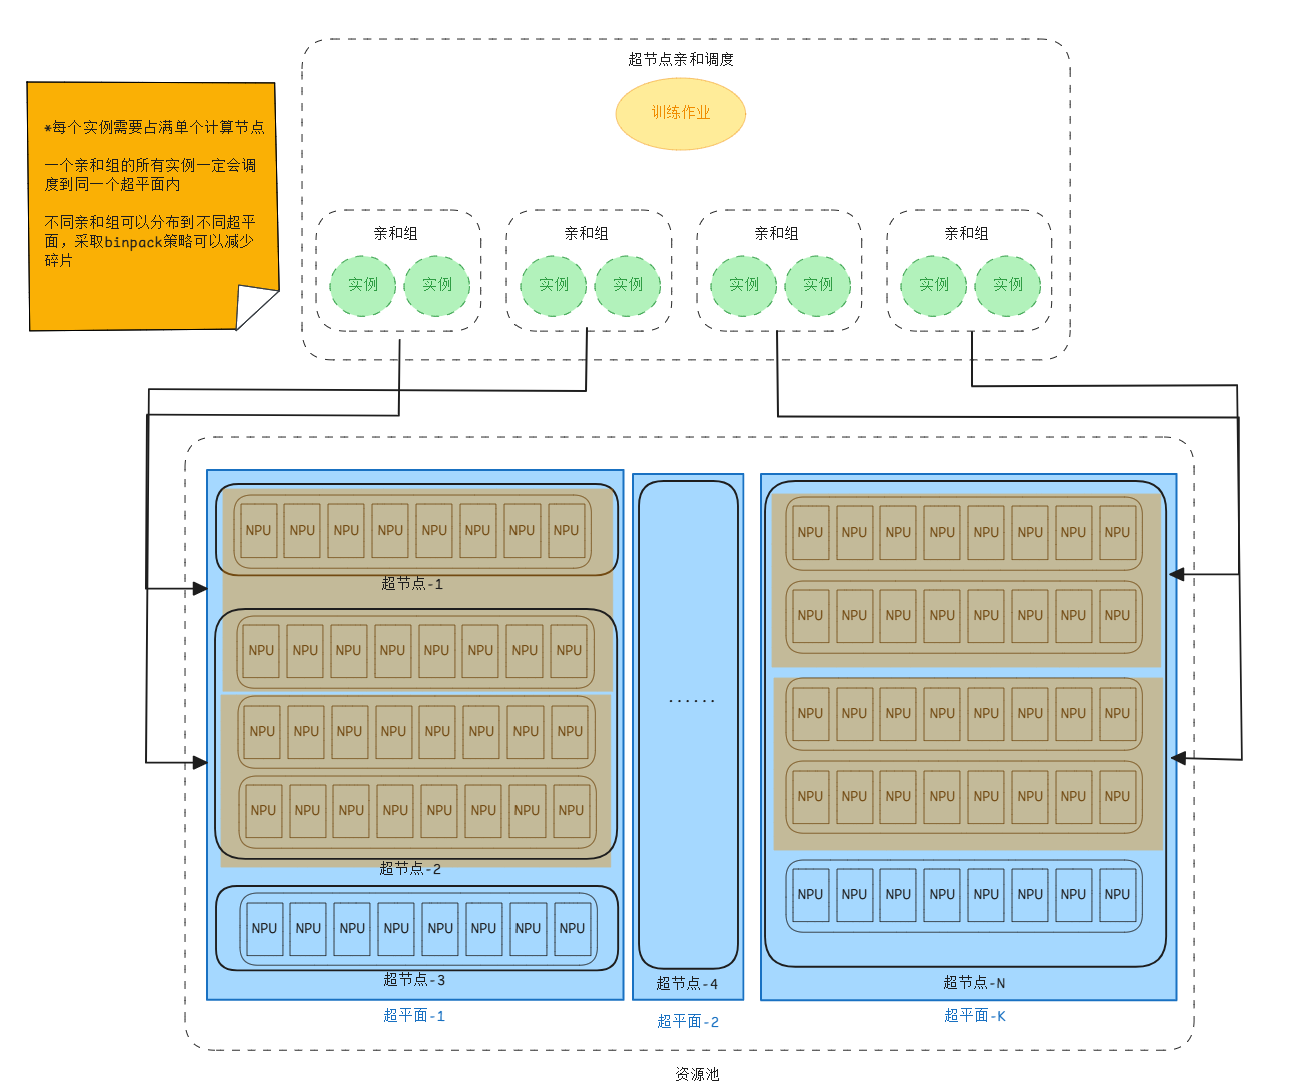
在Snt9e硬件的资源池中,超节点在创建时可以选择相同的超平面,因此同一超平面下会存在多个超节点,并且这些超节点上的NPU高速互联。同一个亲和组的所有实例会被确保调度到同一超平面内,但此时可能会跨超节点。
图4 指定超平面网络
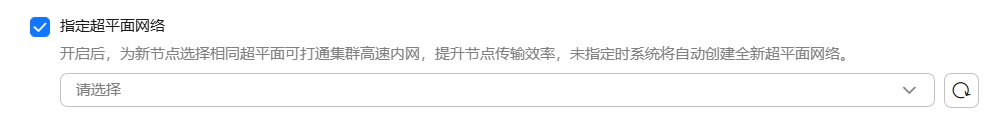 图5 Snt9e超节点和超平面示意图
 图6 Snt9e训练作业超节点亲和调度示意图
- Snt9b23亲和调度
约束限制
- 亲和组特性仅支持昇腾Snt9b23和Snt9e超节点专属资源池。
- 分布式训练需要每个实例占满节点的所有卡。
配置方法
在ModelArts管理控制台界面创建训练作业时配置,“资源池”选择“专属资源池”,且“节点规格”为Snt9b23和Snt9e系列情况下,支持在步骤五:资源配置的阶段配置超节点亲和组实例数。
超节点亲和组实例数参数设置要求如下:
- 超节点亲和组实例数默认为1,最大不超过单个超节点的最大节点数。
- 如果配置了“超节点亲和组实例数”,则“实例数”必须设置为超节点亲和组实例数的整数倍,否则无法创建训练作业。例如,超节点亲和组实例数为n,则实例数为n或2n。
- 在选择专属资源池时,可以查看超节点规格,包括总节点数、总卡数、可用节点数和可用卡数,从而确定超节点亲和组实例数设置。
- 在选择资源队列时,超节点亲和组实例数不能超过资源队列的单实例节点规模。


