


配置Superset连接AI DataLake Spark进行数据查询和分析
Superset是一个开源的数据探索和可视化平台,支持对数据进行快速、直观的探索,同时支持创建丰富的数据可视化和交互式仪表板。
通过将Superset与AI DataLake对接,用户可以访问AI DataLake进行数据查询和分析,简化了数据访问流程,提供了数据的统一管理和分析能力,使得用户能够更深入地洞察数据。
本节操作介绍Superset连接AI DataLake服务的操作步骤。
操作前准备
- 获取Superset安装包
详细安装操作指导请参考安装Superset。
- 获取AI DataLake的SDK
单击aidatalake-python-sdk-x.x.x.tar.gz下载SDK包。
步骤1:安装Superset并配置数据连接驱动
- 下载并安装Superset。
详细安装操作指导请参考安装Superset。
以Docker安装Superset为例:
- 在Superset中安装和配置AI DataLake驱动以连接数据库。
驱动需要放置在Superset的类路径中,例如superset-classpath目录。
解压安装包后,在Superset中安装AI DataLake驱动。
执行Python setup.py install,把aidatalake-spark-python-sdk安装到本地环境。
- 完成驱动安装和配置后,需要重启Superset以确保安装的驱动生效。
步骤2:配置Superset连接AI DataLake
在Superset中,通过以下步骤添加新的数据库连接。
- 打开并登录Superset。
- 单击“Settings > Database Connections”。 图1 Settings中单击Database Connections

- 在弹出的Database窗口中,SUPPORTED DATABASES选择AIDataLake Spark。 图2 SUPPORTED DATABASES选择AIDataLake Spark

- 配置数据连接的信息。
表1 参数说明 参数
说明
DISPLAY NAME
自定义数据连接名称。
SQL ALCHEMY URI
配置数据连接的URI。数据连接URI的格式:
aidatalake_spark://<accesskey_id>:<accesskey_secret>@<region_id>/?projectid=<project_id>&workspaceid=<aidatalake workspaceid>&endpoint_name=<aidatalake_endpoint_name>&databasename=<aidatalake_default_database_name>&catalog=<lakeformation_catalog_name>&endpoint=<aidatalake url>&lakeformation_instance_id=<lakehouse instance id>
其中数据连接的URL的格式中涉及的参数说明如下。表2 Superset连接AI DataLake参数说明 参数
说明
配置样例
accesskey_id和accesskey_secret
华为云账号的AK和SK。
获取AK和SK信息,请参见获取AKSK 。
-
region_id
AI DataLake的区域名称和服务名称。
cn-north-7
projectid
AI DataLake资源所在的项目ID。
鼠标悬浮在AI DataLake管理控制台页面右上角账号信息位置,单击“我的凭证”,在“项目列表”区域获取的目标项目ID信息。
0b33ea2a7e******4c009bb05076d
workspaceid
AI DataLake工作空间ID。
登录AI DataLake管理控制台,在“工作空间管理”页面找到目标工作空间ID。
spark
endpoint_name
AI DataLake服务的端点名称。
登录AI DataLake管理控制台,在“引擎端点”下的“批处理引擎Spark”页面找到目标Spark端点名称。
spark-sql-test
databasename
默认访问的数据库。
default
catalog
数据目录名称。
假设使用名称为lfcatalog的LakeFormation catalog时,配置如下:catalog=lfcatalog
endpoint
AI DataLake服务的Url。
终端节点即调用API的请求地址,不同服务不同区域的终端节点不同,您可以从地区和终端节点中查询服务的终端节点。
https://aidatalake-test.cn-north-7.myhuaweicloud.com
lakeformation_instance_id
LakeFormation实例ID。
获取方法请参见如何获取LakeFormation实例ID。
ae6dd098-***-*****-c02***def36d
- 单击“TEST CONNECTION”测试数据源连接是否成功。
- 单击“CONNECT”保存连接。

步骤3:使用Superset查询及分析数据
- 查看表信息
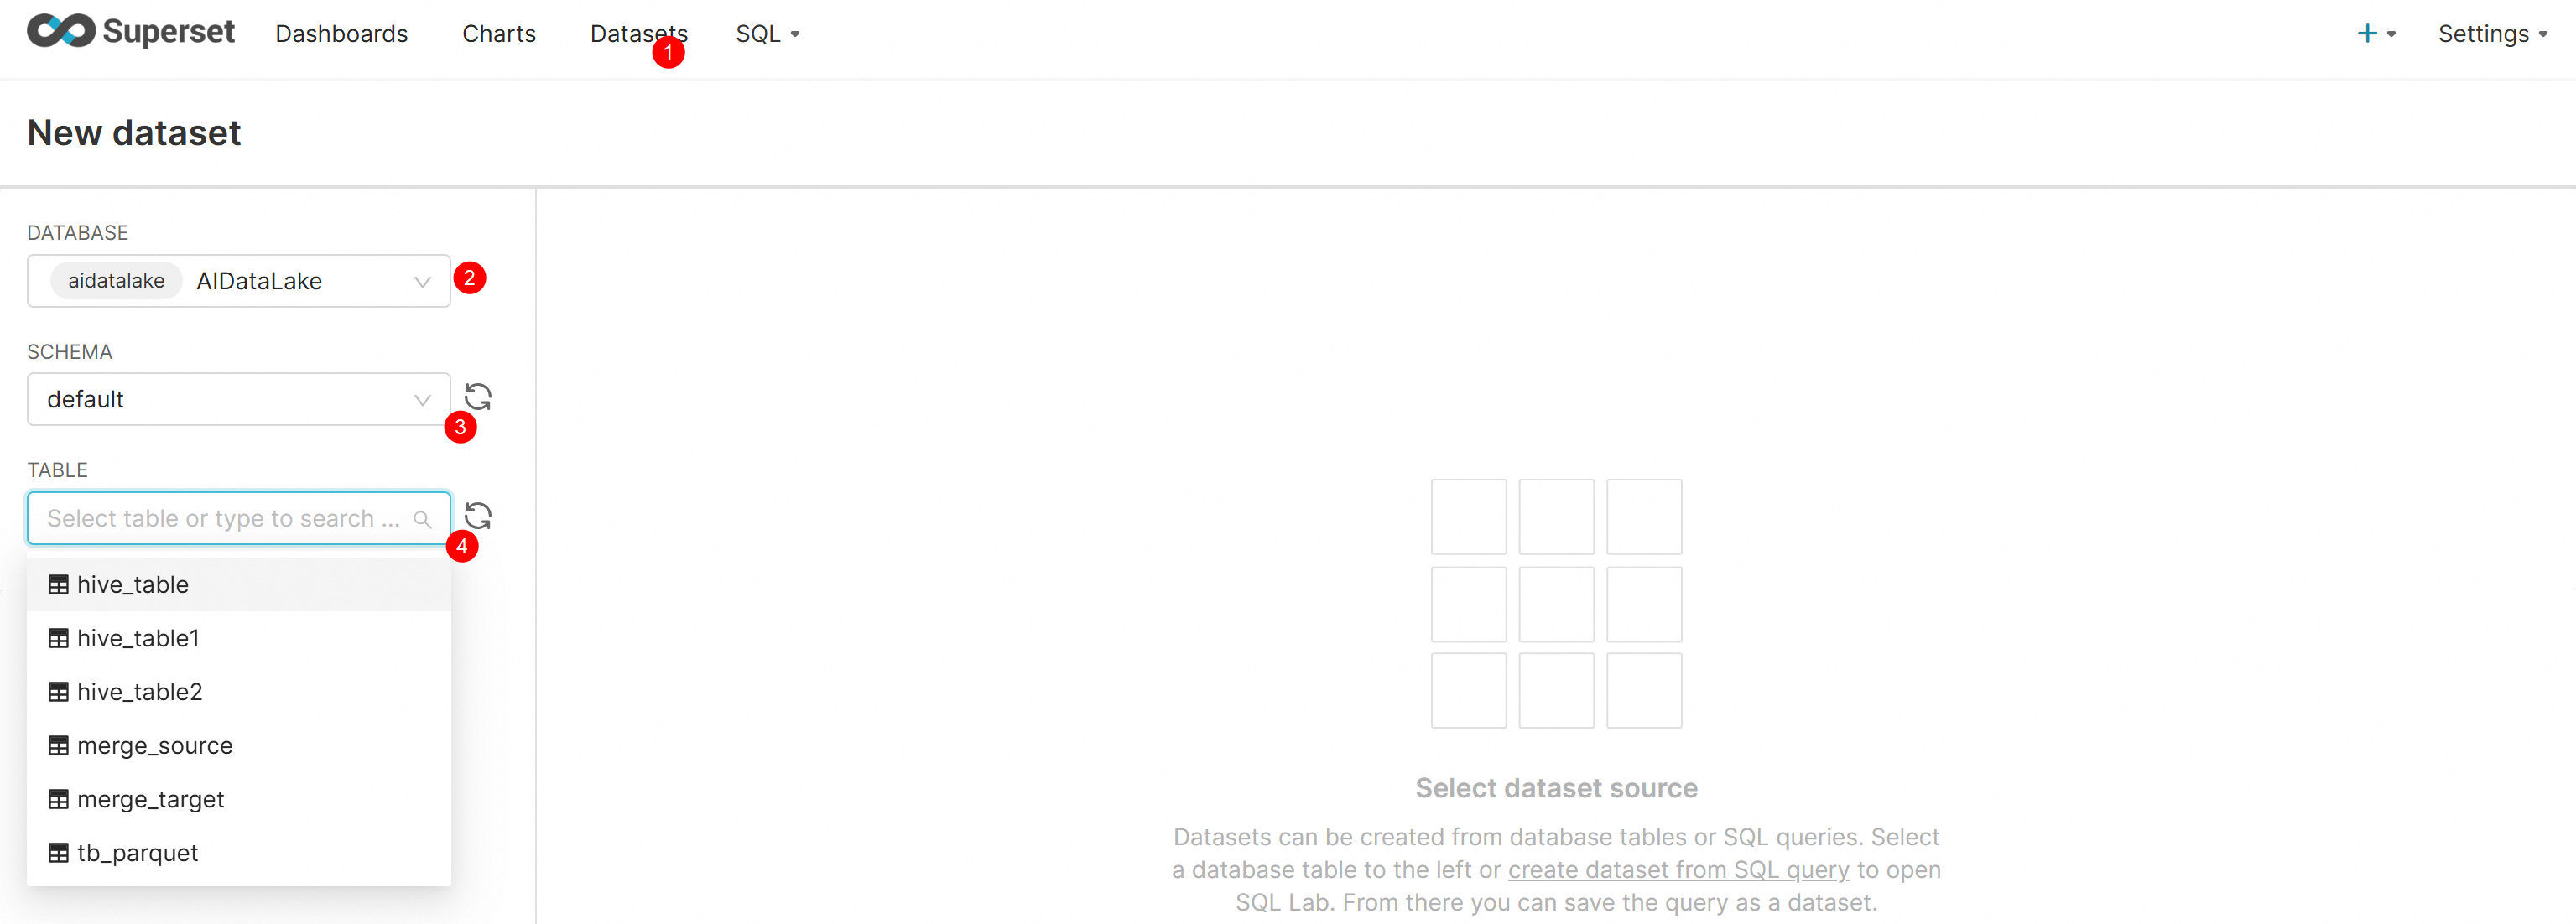
在Superset界面的顶部菜单DataSets,在右侧单击+DATASET,选择数据连接 >数据库 >表,即可预览表信息。
图3 在Superset预览表信息
- 单击右下角“CREATE DATASET AND CREATE CHART”,创建Dataset。 图4 单击CREATE DATASET AND CREATE CHART

- 可视化分析数据
在Dataset界面选中目标表,并配置图表类型+维度,即可展示数据业务分析图。
- 选择库表。 图5 选择库表

- 执行SQL查询 图6 执行SQL查询

- 查看分析结果 图7 Superset可视化分析数据

- 选择库表。


