


本体问答
前提条件
- 已成功创建知识湖,且知识湖内已完成文档的导入与解析。
- 若需启用图谱增强检索功能,必须确保在文档解析任务时完成图谱配置。
本体问答配置
- 登录数据智能平台。
- 在左侧的导航栏选择,进入本体问答页面。
- 选择知识湖。
- 单击左下角的
 ,在“知识湖”下拉菜单中,选择对应的目标知识湖及相应的文档。
勾选本次问答需要大模型学习并作为回答依据的非结构化文档。
图1 添加知识湖

- 单击
 ,上传文件,支持“选择已有文档”或“上传文档”。 图2 添加文件

- 单击“确定”。
- 单击左下角的
- 问答策略配置。
- 单击右上角的
 ,进入策略配置面板。
- 根据具体的业务检索精度与模型生成风格,切换“检索配置”与“问答配置”页签进行参数调优,参数说明请参见表1。
图3 策略配置面板
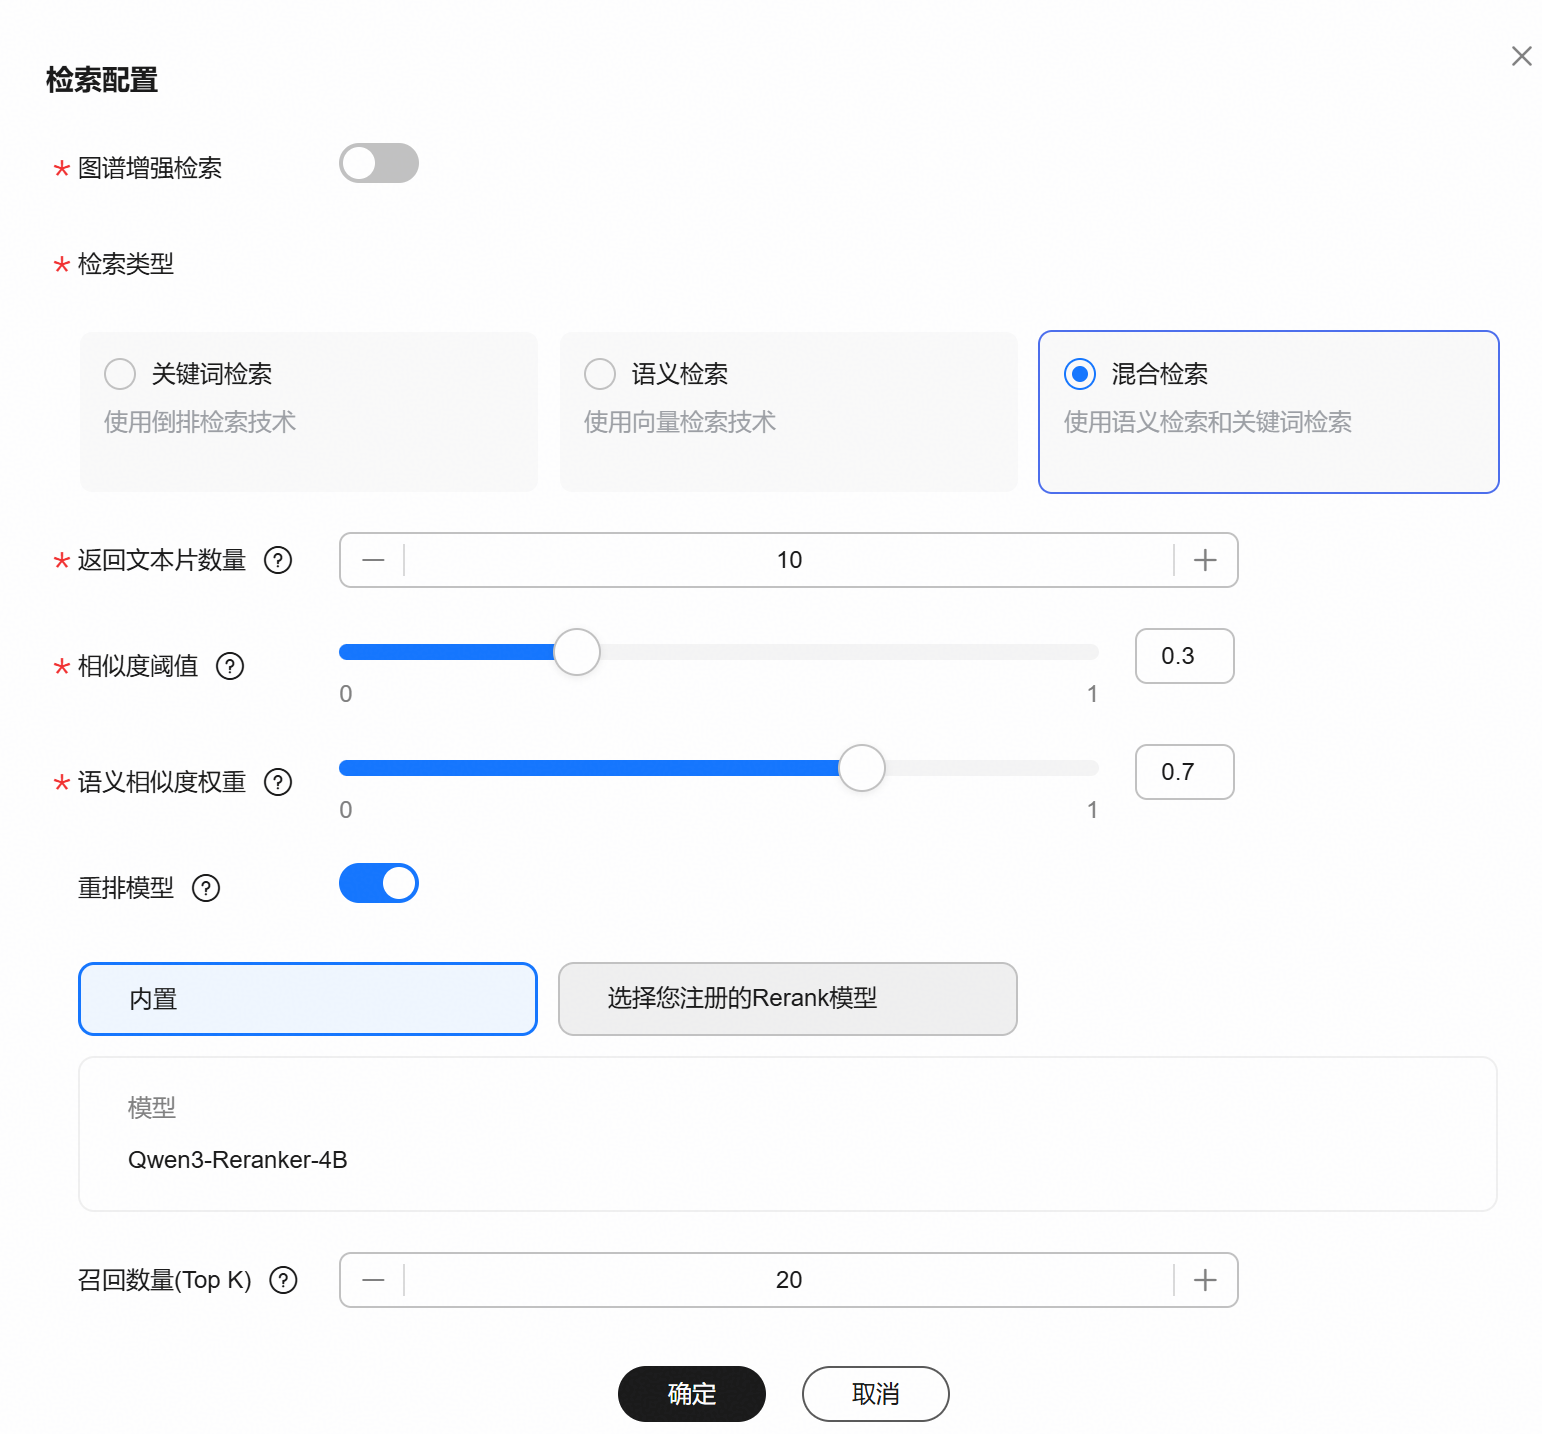
表1 基本信息 参数
说明
检索配置
图谱增强检索
是否开启知识图谱增强检索(GraphRAG)。开启后,系统将联动底层图谱进行实体和关系的拓扑增强,以扩充上下文背景。
说明:开启此开关后,“检索类型”、“相似度阈值”及“语义相似度权重”参数将被系统自动隐藏。
检索类型
设置知识文档在初筛阶段的检索机制(未开启“图谱增强检索”时可见):
- 关键词检索:基于关键词完全匹配。
- 语义检索:基于向量稠密检索,捕捉上下文深层语义。
- 混合检索:结合上述两者进行融合排序。(开启混合检索才能配置“语义相似度权重”)
返回文本片数量
设置单次检索允许喂给大模型的最大文档切片(Chunk)数量。
默认值为“10”(0-1000之间),数量越多答案信息越全,但会增加Token消耗。
相似度阈值
设置向量检索过滤的最低相似度分数(未开启“图谱增强检索”时可见)。使用混合相似度得分来评估两行文本之间的距离。
它是加权关键词相似度和向量余弦相似度。如果查询和块之间的相似度小于此阈值,则该块将被过滤掉。
语义相似度权重
在混合检索模式下,调整语义检索结果在综合评分中所占的分数权重(未开启“图谱增强检索”时并使用混合检索时可见)。取值范围为0-1。它是加权关键词相似度和向量余弦相似度或rerank得分(0-1),两个权重的总和为1.0。
重排模型
可以使用默认的内置重排模型,或者选择您注册的重排模型。
对检索结果进行排序,提升检索效率、保持信息精确性、增强内容多样性,确保最终检索结果的满意度。
召回数量(Top K)
从海量的候选文本片中找出与问题最相关的K个文本片的过程。仅在打开了重排模型的时候可设置此项,推荐设为返回文本片数量的两到三倍。
问答配置
问题改写
是否开启多轮对话历史的问题重构。开启后,大模型将结合上下文对话,将用户当前简短、指代不明的提问改写为独立完整的检索式问题,以提升检索召回率。
生成模型
下拉选择负责执行最终文本理解、整合并输出骨干回答的大语言模型(LLM)。
文本多样性
通过限制词汇的选择来控制生成文本的多样性。值越高,候选单词越多,文本多样性越高。
模型多样性
控制模型生成文本的随机性,值越高,文本随机性、多样性和创造性越高。
- 参数配置完成后,单击“确定”,保存当前的检索与问答配置策略。
- 单击右上角的
- 在页面下方的对话输入框中,输入您需要问询的业务问题,单击
 或按下Enter键提交问题。 图4 问答示例

当大模型成功输出结构化应答,且用户能够通过单击答案中右上角的标签,准确追溯至已勾选知识湖文档的具体段落(或图谱中的实体节点)时。
本体问答配置成功。


