


步骤二:配置优化方法和奖惩机制
强化学习的核心是通过奖励信号引导模型优化输出质量。本章节将围绕奖励机制配置展开,帮助您根据智能体的输出类型选择合适的训练策略。
本章节内容导航:
配置优化方法
为了降低模型的训练门槛并提升训练效果,平台预置了GRPO(群组相对策略优化)算法,与传统的强化学习算法(如PPO)相比,GRPO具有显著的工程优势:
- 去除庞大的评论模型:传统算法需要同时运行两个大模型(一个负责生成的模型,一个负责打分的评论模型)。GRPO算法通过独特的数学设计,彻底砍掉了庞大的评论模型,让训练变得极其轻量、高效。
- 群组对比优化:在训练过程中,模型对同一道题同时生成多个回答,并根据您配置的奖励规则对这几个回答打分排序。得分最高的回答会被强化,得分最低的回答会被抑制。通过这种“组内对比”的方式,模型逐步学会输出更高质量的回答。
配置奖惩机制
GRPO算法的核心是“通过对比学习优劣”,而奖惩机制定义了“什么是好,什么是坏”。平台为您提供三套打分标尺:
关于如何根据智能体的输出形态选择奖惩机制,请参考如何为智能体匹配最佳奖惩机制。
| 类型 | 适用场景 | 核心特点 |
|---|---|---|
| 结构化输出(JSON)、数值计算、严格意图路由等有明确标准、易于量化比对的场景。 | 基于规则匹配,匹配成功得分,匹配失败扣分。包含两大类原子能力:
| |
| 客服对话、文章生成、代码生成与解释等开放式问答场景。 | 像人类一样理解语义与逻辑,支持0.0-1.0的精细化评分。 | |
| 上述两种奖励方式无法满足的复杂场景,例如需要引入外部业务逻辑、自定义计算规则或调用第三方依赖库的场景。需校验 Agent 运行的中间轨迹(如工具调用参数)、需结合外部业务逻辑进行复杂判定,或其他正则/大模型打分均无法精确覆盖的确定性场景。 | 基于代码开发生成奖励规则。平台将Agent运行产生的完整轨迹数据以标准格式传入用户编写的Python代码,由代码返回最终奖励分数,适合确定性奖励任务。 |
对于包含插件、MCP工具调用能力的单智能体:
- 如果业务只关心最终输出是否正确,可继续使用规则奖励或生成式奖励。
- 如果业务还需要检查是否调用了指定工具、调用顺序是否合理、参数是否正确、步骤是否执行成功,推荐使用自适应奖励,通过读取trajectory.steps中的工具调用轨迹进行打分。
规则奖励配置说明
规则奖励适用于输出有明确标准、易于量化比对的场景。在界面中,规则奖励被细分为“格式奖励”与“正确性奖励”两大类使用时,可以二选一或者均使用,共包含三种原子能力。您可以按需组合使用,平台支持通过AI自动生成正则表达式,您也可以通过正则表达式写作示例进行了解:
| 规则奖励类型 | 功能说明 | 打分机制 | 界面配置要点 |
|---|---|---|---|
| 格式奖励(思维链格式校验) | 强制要求模型的回复必须符合特定的结构规范(例如强制包含<think>思考过程标签,或回答中必须包含特定信息)。 | 格式匹配成功+1.0分,匹配失败给0分。 | 启用此项时,您必须填写正则表达式,系统将依据此正则对模型的“完整输出”进行格式校验。 权重建议:同时开启正确性奖励时,权重建议设置为0.2、0.3,作为正确性奖励的辅助格式约束项。 |
| 正确性奖励(精确匹配) | 检查模型的回答是否与您数据集中的标准答案完全一致。 | 匹配成功给+1.0分,匹配失败给0分。 | 不填正则表达式:系统会将模型生成的完整回复与标准答案进行全文比对。只要模型多说了一句废话(如“好的”),就会被判为错误。 强烈建议:填写正则表达式:系统会先利用正则从模型的回复中精准提取关键信息,仅对比提取出的内容与标准答案是否一致。极大提升了校验的容错率。 权重建议:如果配合格式奖励启用,权重设置建议0.7、0.8。 |
| 正确性奖励(数学准确性) | 专为数学与工程计算设计。底层调用专业的符号计算引擎,检查回答在“数值上”是否与标准答案相等。它能聪明地识别0.5等于1/2,1.0等于1,并默认容忍1%的浮点数相对误差。 | 不倒扣分的宽容机制。正确给+1.0分,错误给0.0分。因为数学推导本身就较难,不倒扣分可以鼓励模型大胆试错探索。 | 不填正则表达式:系统将尝试把模型的完整回复强制解析为数字。 强烈建议:填写正则表达式:系统会利用正则从回复中“抠出”特定数值部分,再将该数值交给符号引擎进行等价性比对。 权重建议:如果配合格式奖励启用,权重设置建议0.7、0.8。 |
规则奖励组合选择建议:
- 仅需校验答案正确性(标签/数字ID输出):单独使用精确匹配。
- 仅需校验答案正确性(数值输出):单独使用数学准确性。
- 需同时约束思考过程和答案正确性(数学/逻辑推导):思维链格式奖励 + 数学准确性。
- 需同时约束输出格式和答案正确性(结构化输出):思维链格式奖励 + 精确匹配。

当同时配置“思维链格式奖励”与“正确性奖励”时,各项权重的总和无需严格等于1。为起辅助约束作用的“思维链格式奖励”设置较低权重(如0.2~0.3),确保模型将重点聚焦于答案本身的准确性,防止模型投机取巧凑格式而答错题。
生成式奖励配置说明
当需要对开放式问答场景的Agent进行强化学习时,需要使用生成式奖励,即由大模型作为裁判对Agent的输出结果进行理解和打分。裁判大模型最终会返回一个0.0到1.0的绝对分数。为了防止裁判“主观乱打分”,您必须在配置界面的“评分标准”输入框中,撰写一份逻辑严密的评分规则。
撰写一份评分标准,请遵循以下法则:
第一步:确立核心评分原则和权重划分
一开始就要向裁判模型讲清楚,本次评判最看重什么。是正确性、还是语气态度,或者是代码的可执行性。
参考示例:核心原则:正确性是基础(权重90%),效率和清晰度是加分项(权重10%)。
第二步:精准量化分数段
绝对不能只写“根据质量打 0-1 分”,必须明确告诉裁判模型,什么表现对应什么分数段。
参考示例:
1.0分:答案完全正确,格式完全符合预期,无废话。
0.7 - 0.9分:答案正确,但存在轻微的格式问题或语气不够自然。
0.4 - 0.6分:部分正确,缺失次要信息,但有明显的解题进展。
0.0 - 0.3分:答案错误,或完全偏离主题。
第三步:设立“一票否决”的底线红线
强化学习需要对致命错误进行严厉打击。您必须单独列出哪些情况直接判定为0分,防止模型通过其他维度的表现骗取及格分。
参考示例:
扣分情形:存在事实性错误、缺失关键信息、出现严重幻觉,请直接记为0分。
生成式奖励需要填写“API密钥凭证提供者”以获取评判模型的调用权限。裁判模型的API调用将产生费用,费用由您在MaaS平台配置的API Key对应账户承担。
自适应奖励配置说明
当规则奖励的正则匹配过于死板,而生成式奖励的大模型打分不够精准可控时,您可以使用“自适应奖励”。该模式允许您编写一段Python代码,在代码解释器中执行该代码来计算奖励得分。
与前规则奖励、生成式奖励方式相比,自适应奖励的最大优势在于:平台会将Agent运行的完整轨迹数据(Trajectory)传入您的代码,而不仅仅是最终的回复文本。这意味着您不仅能校验Agent“回答得对不对”,还能像“白盒测试”一样深入审查它的“解题过程”,了解Agent是否调用了正确的工具、工具参数是否正确、大模型的中间推理是否合理等。
适用场景:
- 多步工具调用校验:不仅关心Agent最终回答是否正确,更要验证它是否调用了正确的工具、工具的入参是否符合预期。例如:要求Agent必须通过查询数据库工具获取考勤记录,而不是靠幻觉编造结果。
- Agent运行轨迹合规性检查:验证Agent的中间推理步骤是否符合业务规则。例如:在审批流程中,Agent必须先调用权限校验工具,再执行审批操作。
- 组合评分逻辑:需要同时考量多个维度(如最终答案正确性 + 工具调用正确性 + 响应时长),并用加权公式计算综合分数的场景。
- 外部依赖验证:需要调用第三方Python库(如numpy、re等)进行结果校验的场景。
选择“自适应奖励”后,需要完成以下两项配置:
1. 选择代码解释器
代码解释器是运行自适应奖励代码的沙箱环境。您需要提前在平台中创建并初始化代码解释器(包括安装所需的pip依赖、上传自定义Python文件等),完成后在此处选择对应的代码解释器。
代码解释器创建方法请参考创建代码解释器。
2. 编写执行函数
在代码输入框中,填写用于计算奖励的Python代码片段。编写要求如下,payload完整字段说明请参考附录:自适应奖励payload数据格式说明。
- 必须包含{{payload}}占位符:训练时平台会将Agent运行产生的完整轨迹数据(JSON字符串)替换到{{payload}}的位置,您在代码中通过json.loads()进行解析后使用。
- 必须通过print()输出一个数值作为奖励分数:平台读取代码标准输出的数值作为本次的奖励得分,建议返回范围在0.0 ~ 1.0之间。
代码示例:
平台已为您预置了一段默认代码,您可以直接在此基础上修改。
import json

def cal_reward(payload_str):
    # 1. 解析系统传入的 payload 数据
    data = json.loads(payload_str)

    # 2. 获取标准答案与 Agent 的实际最终输出
    reference_output = data.get("reference_output")
    actual_output = data.get("trajectory", {}).get("root", {}).get("output")

    # 3. 编写您的自定义校验逻辑
    return 1 if reference_output == actual_output else 0

# {{payload}} 为必要引用变量,系统会将其替换为真实的 JSON 字符串
print(cal_reward({{payload}})) - {{payload}}是平台的数据注入占位符。训练时,平台会把本次 Agent 运行产生的轨迹数据(JSON字符串)替换到这里,传给cal_reward函数。
- data = json.loads(payload)把平台传入的JSON字符串解析成Python字典,方便后续读取字段。
- reference_output = data.get("reference_output")从payload中取出数据集里的标准答案,也就是您在准备数据集时填写的reference_output字段。
{"input": "我家宽带断了", "reference_output": "故障报修"}那么这里取到的reference_output就是 "故障报修"。
- actual_output = data.get("trajectory").get("root").get("output")从轨迹数据中取出Agent本次运行的最终回复。可以把这个路径理解为:
- trajectory:本次Agent运行的完整轨迹数据。
- root:本次运行的整体汇总,记录了Agent从收到用户问题到给出最终回复的结果。
- output:Agent最终返回给用户的回复文本。
- return 1 if reference_output == actual_output else 0把标准答案和 Agent 实际输出做对比:相同则返回 1(满分,模型回答正确);不同则返回 0(零分,模型回答错误)。
默认代码说明
默认代码做的是完整字符串精确匹配:只要Agent的输出和标准答案有任何一个字符不同,就给0分。
这在某些场景下会过于严格,例如:
- Agent 输出 "故障报修\n",标准答案是 "故障报修",因末尾多了换行符导致匹配失败。
- Agent 输出 " 故障报修 ",标准答案是 "故障报修",因首尾有空格导致匹配失败。
另外,默认代码只校验最终答案,无法检查Agent的执行过程,例如是否调用了正确的工具、工具参数是否正确。
当遇到上述情况时,可以在默认代码的基础上进行扩展。
代码常用写法与脚本示例
- 示例一:去除首尾空格,避免误判
适用场景:意图分类、标签输出、状态码输出。
在默认代码基础上加 .strip(),去除首尾的空格和换行符:import json def cal_reward(payload): data = json.loads(payload) reference_output = data.get("reference_output", "").strip() actual_output = data.get("trajectory").get("root").get("output", "").strip() return 1 if reference_output == actual_output else 0 print(cal_reward({{payload}})) - 示例二:加入异常保护
适用场景:所有生产环境中的脚本。
建议在所有脚本中加入 try-except,避免因为单条样本数据异常导致训练中断:import json def cal_reward(payload): try: data = json.loads(payload) reference_output = data.get("reference_output", "").strip() actual_output = data.get("trajectory").get("root").get("output", "").strip() return 1 if reference_output == actual_output else 0 except Exception: return 0 print(cal_reward({{payload}})) - 示例三:必须调用指定工具才给分
适用场景:防止模型跳过工具调用、直接编造答案。
如果只校验最终答案,模型可能靠猜测得到正确结果,而没有真正调用工具。这时可以检查trajectory.steps,验证Agent在执行过程中是否真的调用了指定工具。
trajectory.steps是Agent运行过程中所有执行步骤的列表,按执行顺序排列,每个步骤包含以下常用字段:表3 参数说明 字段
说明
type
步骤类型,llm为大模型调用,tool为工具调用。
name
步骤名称,工具步骤中可用于识别调用的是哪个工具。
input
步骤输入内容,工具步骤中可用于检查传入的参数。
output
步骤输出结果。
status
执行状态,success为成功,failed为失败。
import json def cal_reward(payload): try: data = json.loads(payload) steps = data.get("trajectory").get("steps", []) for step in steps: if step.get("type") == "tool" and step.get("name") == "query_attendance_db": return 1 return 0 except Exception: return 0 print(cal_reward({{payload}})) - 示例四:工具调用正确,参数也提取正确
适用场景:工具参数提取、工号/订单号/设备号等关键参数校验。
工具名对了,但参数填错了,同样应该扣分。step.input通常是一个JSON字符串,需要先用json.loads()解析成字典,再读取具体参数字段。
在此类场景中,reference_output可以用作校验基准值而非最终回复文本。数据集可以这样构造:表4 数据集示例 input
reference_output
帮我查一下张三(工号1001)上个月的考勤记录
1001
查一下李四(工号2058)上周的考勤情况
2058
import json

def cal_reward(payload):
    try:
        data = json.loads(payload)
        expected_emp_id = data.get("reference_output", "")
        steps = data.get("trajectory").get("steps", [])

        for step in steps:
            if step.get("type") == "tool" and step.get("name") == "query_attendance_db":
                try:
                    tool_params = json.loads(step.get("input", "{}"))
                except Exception:
                    tool_params = {}
                if tool_params.get("emp_id") == expected_emp_id:
                    return 1

        return 0
    except Exception:
        return 0

print(cal_reward({{payload}}))
step.input是JSON字符串而不是字典,需要先解析再读取字段。直接做字符串包含判断虽然也能工作,但在参数值存在嵌套或特殊字符时容易误判,建议优先使用解析后读取字段的方式。
- 示例五:结果与过程都纳入评分 适用场景:既要最终答案正确,也要执行过程正确。
import json

def cal_reward(payload):
    try:
        data = json.loads(payload)
        reference_output = data.get("reference_output", "").strip()
        actual_output = data.get("trajectory").get("root").get("output", "").strip()
        steps = data.get("trajectory").get("steps", [])

        # 维度1:最终答案是否正确(权重 0.7)
        answer_score = 1 if reference_output == actual_output else 0

        # 维度2:是否调用了指定工具(权重 0.3)
        tool_score = 0
        for step in steps:
            if step.get("type") == "tool" and step.get("name") == "query_attendance_db":
                tool_score = 1
                break

        return 0.7 * answer_score + 0.3 * tool_score
    except Exception:
        return 0

print(cal_reward({{payload}}))
操作步骤
- 步骤一:配置优化对象与模型配置完成后,单击“下一步”。进入配置优化方法和奖罚机制页面。
- 平台默认使用强化学习和GRPO(群组相对策略优化)算法对智能体中的模型进行优化。优化方法为默认配置,不可修改。 图1 配置优化方法

- 参考配置奖惩机制、规则奖励配置说明、生成式奖励配置说明、正则表达式写作示例、自适应奖励配置说明选择合适的奖罚机制,并进行配置。
当同时配置“思维链格式奖励”与“正确性奖励”时,各项权重的总和无需严格等于1,为起辅助约束作用的“思维链格式奖励”设置较低权重(如0.2~0.3),以此确保模型在规范输出结构的同时,将重点聚焦于答案本身的准确性,防止模型投机取巧“凑格式而答错题”。
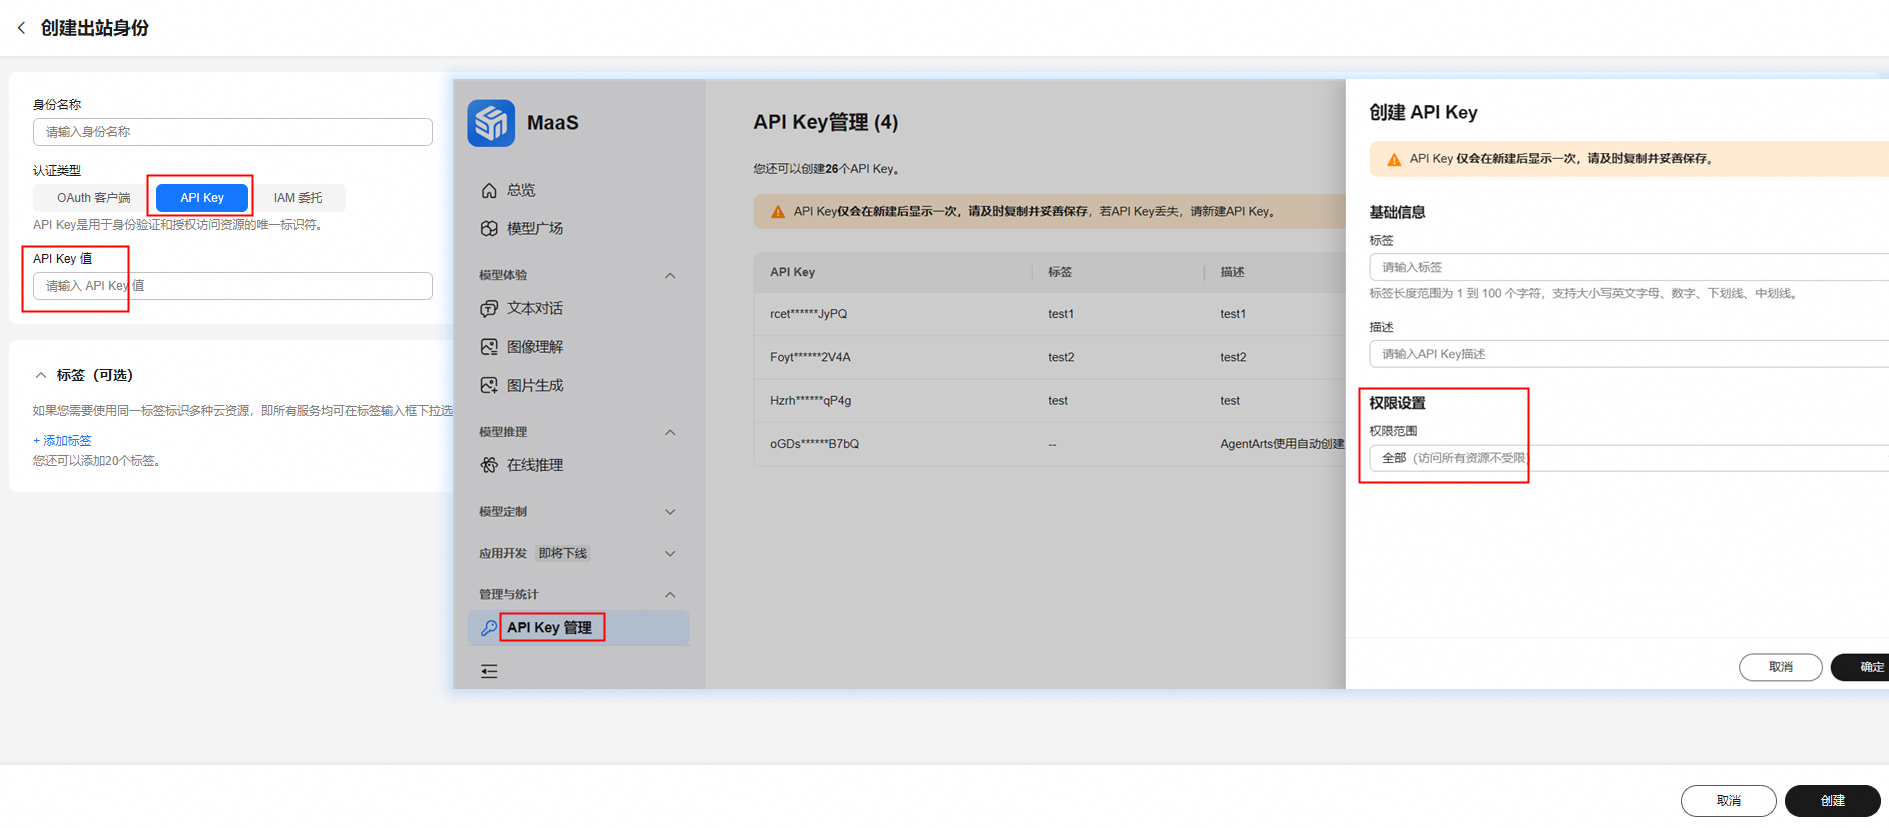
注意,生成式奖励需要填写“API密钥凭证提供者”。填写该参数后可以获取评判模型的调用权限。在页面单击“前往创建”,配置如下:
- 身份名称:可自定义。
- 认证类型:选择“API Key”。
- API Key值:需登录MaaS模型即服务平台,在API Key管理页面创建,创建时权限范围选择全部即可。
- 标签:可选,用于分类标记配置信息。
图2 配置API密钥凭证提供者
 图3 创建出站身份
- 奖罚机制配置完成后,参考步骤三:配置超参数配置模型训练超参数。
奖惩机制配置是训练成功的关键。如果训练后奖励值异常,请优先检查正则表达式和评分标准是否正确,详见常见问题。
正则表达式写作示例
在配置规则奖励时,正则表达式的作用就是切除模型输出的废话,只提取核心答案交给系统进行打分。
您可以通过下方的示例了解正则表达式的构造方法:
示例一:JSON数字提取(适用于输出为状态码、数字ID场景)
假设您的Agent需要输出{"status": 200},而您数据集的答案字段填的是200。
- 正则写法:\{\s*"status"\s*:\s*(\d+)\s*\}
- 正则解释:
- \{ 和 \}:匹配 JSON 的左右大括号。
- \s*:极其重要!包容大模型生成时随机加入的多余空格或换行。
- "status":您定义的 JSON 键名(根据业务自行替换)。
- (\d+):进行数字提取。括号 () 代表提取内容,\d+ 代表精准提取纯数字。系统最终只会拿括号里的数字去和标准答案比对。
示例二:JSON文字标签提取(适用于意图分类场景)
假设您的 Agent 需要输出具体的意图标签,如 {"intent": "故障报修"},而您数据集的答案字段填的是故障报修。
- 正则写法:\{\s*"intent"\s*:\s*"(.*?)"\s*\}
- 正则解释:
- 由于输出的是中文字符串,通常被双引号包裹。因此写成 "(.*?)"。
- (.*?):进行文本提取。它会提取双引号内部的任何字符(包含中文、英文、符号),直到遇到下一个双引号为止。系统只会拿提取出的文字去和标准答案比对。
示例三:思维链格式校验(适用于强制推理场景)
在使用“思维链格式奖励”时,我们需要验证模型的“完整回复”是否严格按照“先思考,后输出”的结构进行。
假设您在 Prompt 中规定:“请必须先以‘分析过程:’开头进行推理,最后以‘最终答案:’给出结果。”
- 正则写法:^分析过程:[\s\S]+?最终答案:\s*[\s\S]+$
- 正则解释:
- ^分析过程::^ 代表必须以其后的内容开头。强制模型一上来必须进入分析状态,绝不允许在前面输出任何废话(防止模型“脱口而出”错误答案,破坏思维链)。
- [\s\S]+?:万能匹配符,包容分析过程中的所有推理文字和换行符(使用 +? 确保思考过程不能为空)。
- 最终答案::匹配思考结束、答案开始的边界词。
- \s*[\s\S]+$:代表在“最终答案:”之后,必须有实质性的内容输出。$ 代表文本到此结束。
示例四:特性锚点的数值提取(适用于数学推导)
假设在数学计算中,要求模型最终以ANSWER: 113.04格式输出最终的计算结果。
- 正则写法:ANSWER:\s*(\d+\.?\d*)
- 正则解释:
- ANSWER:\s*:检索“ANSWER:”关键字,并自动忽略冒号后多余的空格。
- (\d+\.?\d*):匹配并提取紧跟“ANSWER:”后面的整数或浮点数(如将提取113.04)。
如果配置正则表达式后训练奖励值始终为0,可能是正则写错,请参考常见问题。


