


示例:创建模型优化任务
模型优化功能通过强化学习能力,可以让智能体在实际业务中输出结果更为精准、稳定。本示例以最典型的“客服工作流意图分类”场景为例,演示如何从零完成工作流的搭建、训练数据的准备、创建模型优化任务、挑选合适的模型快照、部署评估环节。
场景说明:电信客服意图分类工作流
- 用户输入:“我家的宽带突然断了,上不了网”
- 期望输出:“故障报修”
- 下游流程:工作流根据意图标签自动路由到故障处理流程
通过模型优化功能训练后,小尺寸模型在意图分类专属场景中表现可媲美大模型,同时针对用户表述模糊(如“宽带有点问题”)或多意图混合(如“查账单顺便报修”)问题可以按照训练要求进行正确分发。
步骤一:搭建意图分类工作流
示例中将创建一个带有意图识别节点的客服路由工作流。
- 登录AgentArts智能体平台。
- 在左侧导航栏中选择“开发中心 > 智能体管理”,在“工作流”页签,单击“创建工作流”。
- 选择“任务型工作流”并填写工作流名称和描述。 图1 创建工作流

- 工作流包含3个节点:开始节点、意图识别节点、结束节点。搭建时请移除默认的大模型节点。按照下图进行搭建。
- 意图识别节点中新增3个意图标签:故障报修、业务咨询、投诉退订,和原有的“其他意图”加起来共计4个标签。
- 意图识别节点选择一个可用的模型,并将输入参数设置为引用开始节点的query参数。
- 将意图识别节点的4个分类标签与结束节点相连。结束节点的输入引用意图识别节点的name参数。其余参数及节点的配置均使用默认值。
图2 搭建工作流
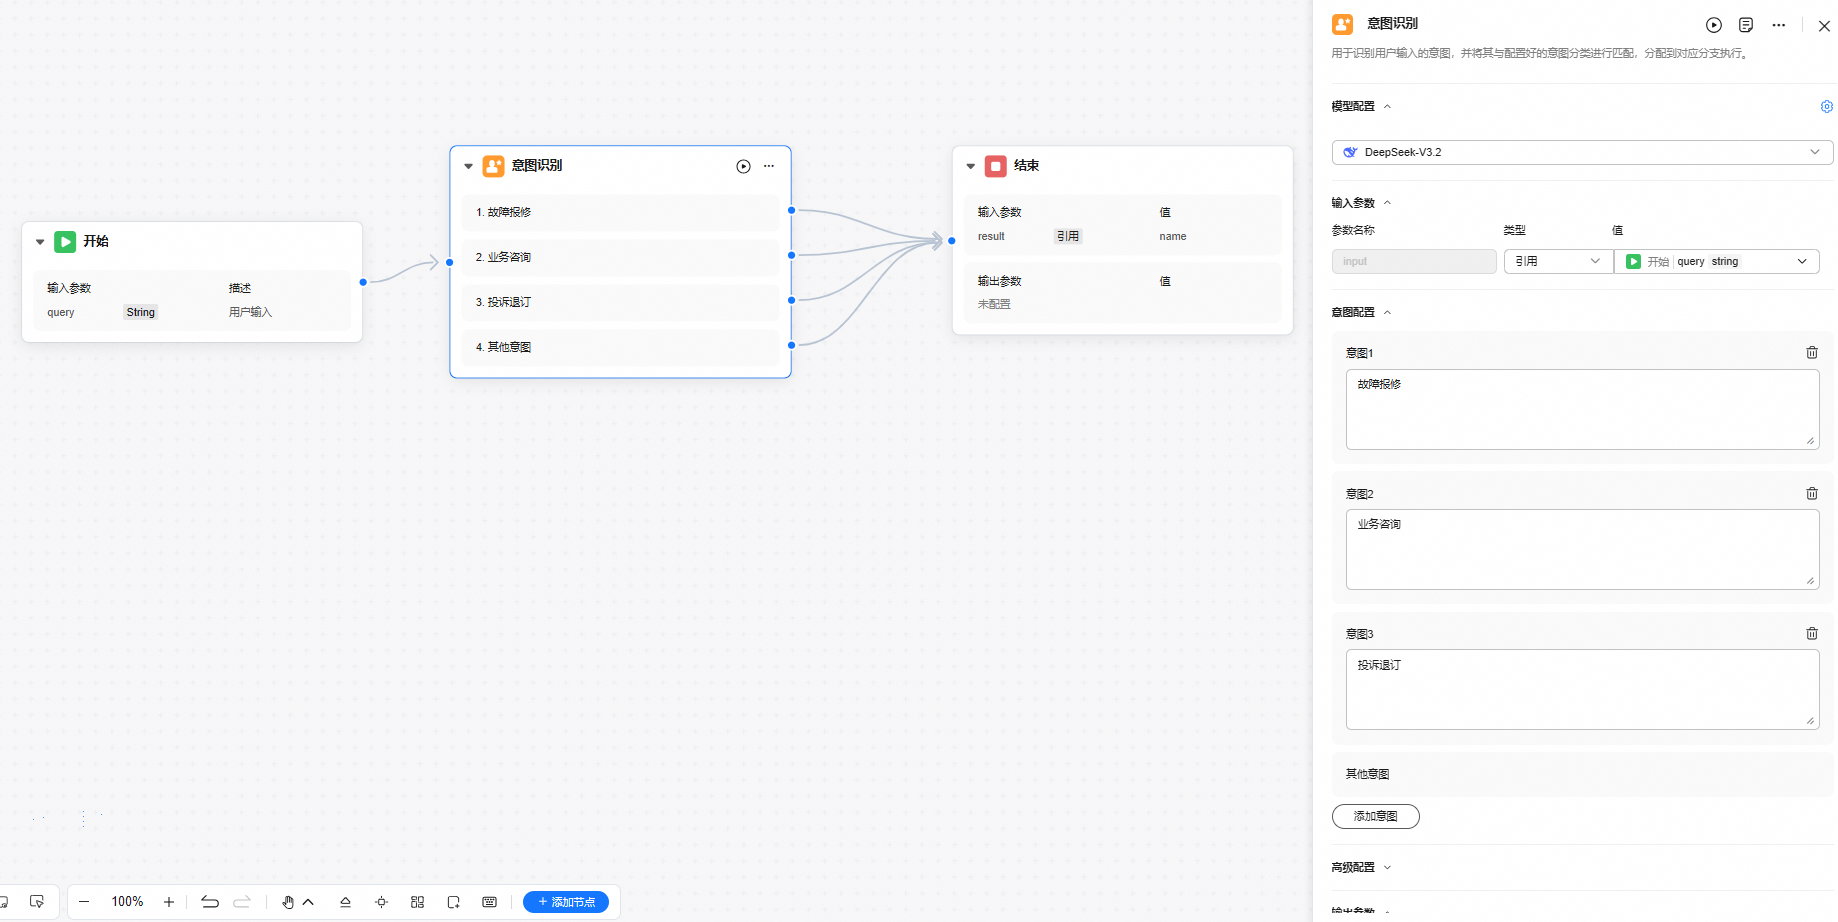 图3 结束节点配置

- 搭建完成后,单击“试运行”,输入测试问题“我家的宽带突然断了,上不了网”检查工作流是否可以正常运行。运行无问题后,单击“提交版本”进行发布。 试运行正常的标准为:工作流输出正确的意图标签(如“故障报修”),且无报错信息。图4 试运行与提交版本

步骤二:准备训练数据集
数据集是强化学习训练的核心,质量直接决定训练效果。本示例需要准备意图分类数据集,包含input(用户输入)和reference_output(期望的意图分类标签)两个字段。
在意图分类场景中,数据集需覆盖以下场景:
标准用例:意图明确的典型问题(如“宽带断了”)
- 模糊表述:意图不明显但能推断的问题(如“宽带有点问题”)
- 多意图混合:包含多个诉求,需识别主意图的问题(如“查账单顺便报修”)
- 边界测试:与业务无关的问题,训练拒识能力(如“今天天气怎么样”)
- 在AgentArts平台左侧导航栏中选择“观测与优化 > 评估”,并进入“评测集”页签。
模型优化与评估,共用一套数据集功能,因此在评估功能中创建数据集。
- 单击“创建评测集”,填写数据集名称和描述,配置列使用默认值。 图5 创建模型优化数据集

- 数据集创建成功后,会自动跳转至添加数据页面,单击“添加数据 > 手动添加”。 图6 添加数据

- 参考下方示例,添加训练数据。
添加多个数据时请使用左侧的“添加数据项”功能,页面下方的“添加对话”功能用于多轮对话场景,不适用模型优化任务(优化需要使用单轮对话数据)。
以下是本场景的数据示例,仅作为演示使用。实际业务中需要构造500 ~ 1000条极具代表性、分类均衡的高质量数据,如果Agent的处理链路非常复杂,可适当增加至1000 - 2000条。
表1 训练数据示例 input用户输入
reference_output期望输出
我家的宽带突然断了,上不了网,光猫一直闪红灯
故障报修
路由器绿灯一直闪,但是连不上WiFi,是怎么回事?
故障报修
我想咨询一下套餐价格
业务咨询
宽带太慢了要退订
投诉退订
话费无缘无故被扣了,给我查查到底怎么回事
投诉退订
宽带有点问题
故障报修
电视盒子报错001,看不了直播了,帮我找个师傅来看看
故障报修
我想把现在的套餐更改为最便宜的基础版套餐,怎么操作
业务咨询
网速很慢,我想问下是不是可以升级套餐
业务咨询
今天天气怎么样
其他意图
图7 数据集构造样例

- 数据集构造完成后,单击“确定”,返回数据集详情页面,单击“提交版本”发布该数据集。只有经过发布的数据集才能用于后续的训练任务。 提交版本成功后,数据集状态将变为“已提交”。图8 提交版本

步骤三:创建模型优化任务
数据集准备完成后,开始创建模型优化任务。在具体操作前,需要先理解模型优化任务的核心流程与关键概念:
模型优化任务的核心流程
- 选择优化对象:指定要优化的工作流节点及其被训练的模型。
- 配置奖惩机制:定义"什么是好的输出",引导模型学习方向。
- 设置超参数:控制训练过程的底层参数(学习率、批大小等)。
- 绑定数据集:提供训练样本,让模型从数据中学习。
- 启动训练:系统自动执行强化学习训练,产出多个模型快照。
奖惩机制是强化学习的核心,定义了“什么输出是正确的、什么是错误的”。系统根据奖惩机制对模型输出打分,高分巩固、低分纠正,逐步优化模型行为。详见模型优化的原理和如何为智能体匹配最佳奖惩机制。
关键概念理解
平台使用强化学习进行训练,强化学习的核心思想是“试错学习”。模型通过不断尝试不同的输出,根据奖励反馈调整行为。奖惩机制定义了“什么输出是正确的”、“什么输出是错误的”。
在模型优化任务中,系统将数据集中的每条问题发送给模型,模型生成回答后,系统根据奖惩机制对输出进行打分。输出正确获得正向奖励,输出错误获得负向惩罚。模型根据奖励反馈调整内部参数,逐步学会输出高分内容,减少低分内容,经过多次迭代优化输出行为。
- 在AgentArts平台左侧导航栏中选择“观测与优化 > 优化”,在“模型优化”页面,单击“创建优化任务”。
- 填写优化任务名称和描述,不添加标签。“优化对象”选择工作流中的意图识别节点。模型选择“Qwen3-NLP-1.7B-4K”。设置完成后单击“下一步”。 图9 优化对象配置

- 在本次的意图分类任务中,期望模型只输出纯净的意图标签文字(如“故障报修”),不输出任何多余的解释、寒暄等内容,因此奖罚机制使用“规则奖励 > 精确匹配奖励”。训练参数保持默认,不做改动。
设置精确匹配奖励权重为1,正则表达式为留空,不填写(正则留空,系统将把模型的完整回复与答案进行比对)。
精确匹配奖励的作用机制:系统利用正则表达式从模型输出中提取核心内容,与数据集reference_output字段进行字面比对。匹配成功获得正向奖励,匹配错误获得负向惩罚。正则留空时,系统将模型的完整回复与标准答案进行全文比对,任何多余字符都会导致匹配失败;填写正则时,系统先用正则从模型回复中提取关键内容,仅比对提取结果,容错性更强。本示例中期望模型输出纯净的标签文字,因此正则留空即可。图10 配置奖罚机制
 图11 配置训练参数
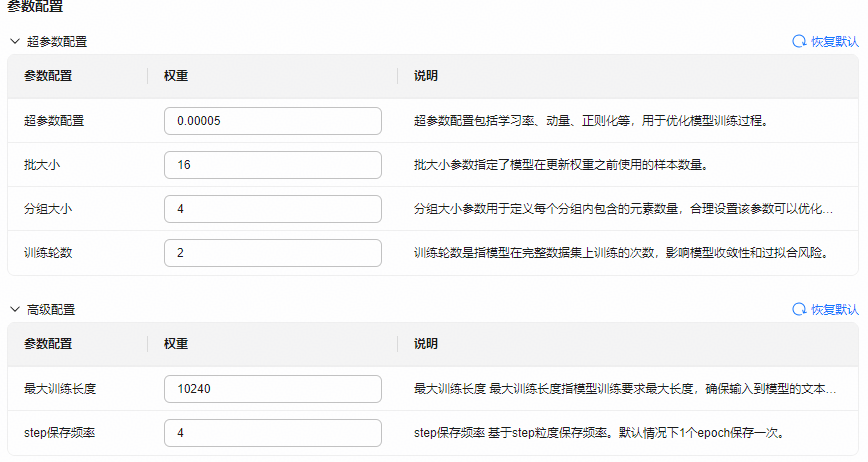
正则表达式配置是训练成功的关键。如果训练后奖励值始终为0,可能是正则写错,请参考常见问题:奖励值始终维持在0。
- 单击“下一步”配置模型训练数据、验证集数据、产物路径与委托。选择创建的训练数据集,并指定一个OBS路径用于存放训练产物。委托创建方法如下:
- 委托名称:由用户自定义
- 信任主体类型:选择“云服务”
- 云服务:填写“智果Agent优化”
- 其他参数:使用默认配置
委托创建完成后,按照页面提示进行授权,授权项选择“AgentArtsRLModelTuningTaskAgencyPolicy”。
图12 配置数据集
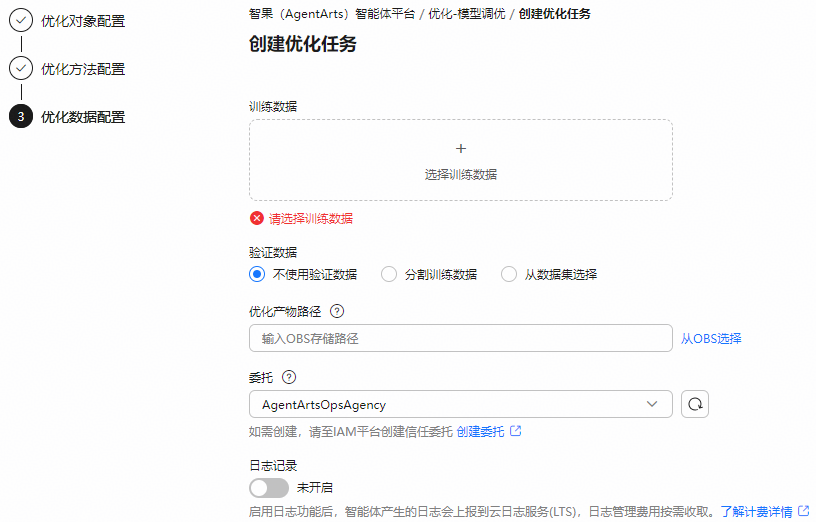 图13 创建委托

- 配置完成后,单击“保存并运行”启动训练任务。
单击“保存并运行”后,“模型优化”页面将新增一条任务,状态变为“训练中”时可单击任务名称进入详情页查看训练曲线。
步骤四:监控指标并挑选模型快照
读懂监控指标:
任务运行中,单击训练任务名称可以进入详情页观察奖励值、响应长度曲线。
- 奖励值(训练):代表模型输出符合您设定的“奖惩机制”的平均得分。分数越高,代表模型表现越接近您的预期。
- 训练成功:曲线从低位逐步爬升,并保持稳定。
- 训练失败:曲线始终在低位徘徊(排查奖罚规则有效性)或剧烈波动(调整学习率)。
- 奖励值(验证):仅在配置验证集时展示,代表模型在验证集上的平均奖励得分,用于辅助观察模型在未参与训练数据上的表现。
- 训练成功:与训练奖励整体同向提升,并逐步趋于稳定。
- 训练异常:长期偏低,或在训练后期明显回落,说明模型可能存在过拟合。
- 响应长度:效率与健康指标。代表模型生成回答的平均字符长度。
- 训练成功:曲线保持平稳,本示例中是做意图分类标签的训练,模型的输出响应为中文标签,响应长度应该数值较低且保持平稳。
- 训练失败:奖励值很高,但响应长度突然呈指数级飙升(排查奖罚规则有效性)。
- 消耗时间:代表模型训练每个Step的总耗时,用于辅助观察推理复杂度和开销变化。
- 训练成功:整体平稳,或随训练小幅波动。
- 训练异常:持续明显升高,且常伴随响应长度增加,需要警惕冗余输出或异常复杂推理。

请注意,由于本示例仅作为入门Demo,训练数据集您可以能只使用了10条左右的训练数据。指标异常为正常现象:
- 入门Demo下的异常:在极小数据量下,模型极大概率会发生“严重过拟合(模型死记硬背记住了训练数据答案)”。您的奖励曲线可能会在极短的时间内瞬间飙升到较高的值,或者因为样本太少导致曲线剧烈震荡。
- 正常训练:在真正的生产环境中,当您投入了500~1000条高质量数据后,您将看到一条平滑上升、健康收敛的奖励曲线。
因此,在本示例中不需要过度关注指标的异常情况。核心目的是通过本示例掌握模型优化的所有环节,指标异常并不影响您后续的评估优化效果操作。
训练完成后,任务状态将从“训练中”变为“成功”,在模型快照列表中可以查看所有保存的模型版本。
挑选最优模型快照:
在曲线图下方,平台根据保存频率为您留存了多个阶段的模型“快照(Checkpoint)”。您可以根据以下方法进行挑选:
- 优先关注Top 3奖励(奖励得分最高)的快照。
- 若任务配置了验证集,建议结合奖励值(验证)曲线,优先选择训练奖励和验证奖励都较高、且二者差距较小的阶段。
- 在Top3中,对比它们的 “响应长度”。坚决抛弃那些长度异常飙升的快照,选择长度最短、最精炼的那一个。
- 结合消耗时间辅助判断:若某阶段奖励较高,但消耗时间持续明显升高,也建议谨慎评估其实际可用性。
- 若训练后期训练奖励继续升高,但验证奖励回落,则通常说明出现过拟合,应优先考虑训练中期验证表现更稳定的快照。
步骤五:评估优化效果
部署模型并发布Agent:
- 在“模型优化”页面单击优化任务名称,在模型快照列表中,选择您需要查看的快照。
- 单击操作列的“部署并接入”,将该模型替换到Agent中。 图14 查看模型产物

- 在“模型部署与接入”页面分别配置模型部署资源、配置接入信息。
- 部署资源配置:
表2 部署资源配置参数说明 参数
说明
资源池类型
资源池分为公共资源池与专属资源池。
- 公共资源池:由AgentArts平台提供的公共部署资源,开箱即用,适合首次验证,无需提前购买资源。按资源规格、使用时长及实例数计费,详见ModelArts计费说明。
- 专属资源池:由用户自己在ModelArts平台创建的专属资源池,独享部署资源,适合生产环境长期使用。
在ModelArts平台创建专属资源池时,需要选择“模型部署”场景的资源池,并选择“NPU+ARM”架构的节点规格。详细指导请参考创建专属资源池。
图15 在ModelArts中购买专属资源池
 图16 在ModelArts中购买专属资源池

实例规格
部署模型时从资源池中申请的计算资源,决定了模型能否正常加载、推理速度、单实例承载的并发量。首次验证建议选择最小规格,确认模型可正常加载后,再根据业务并发和响应速度需求按需提升规格。
实例数
同时启动的推理服务副本数量,实例数越多服务能承载的总并发越高。默认值为1,取值范围为1~20。选择专属资源池方式部署时,实例数不可超过专属池的实例数。首次验证建议设置为1。
认证凭据
认证凭据用于获取挂载存储时所需的访问密钥(AK/SK)信息,确保模型部署实例能够正常访问和读取对象存储中的模型文件等资源。单击“前往创建”进行配置:
- 凭据类型:通用凭据
- 凭据名称:可自定义
- 企业项目:默认default
- 设置凭据值:选择“凭据键/值”方式,新增两个键值对,“键”分别填写“accessKeyId”,“secretAccessKey”,值请登录“我的凭证 > 访问密钥”页面获取,获取到的AK和SK就是accessKeyId和secretAccessKey。 图17 获取AK、SK
 图18 AK、SK示例

- KMS加密:使用默认配置
- 高级配置:使用默认配置
配置完成后,单击“下一步”保持默认配置,直至凭据创建完成。
图19 创建凭据

- 接入配置:
表3 接入配置参数说明 参数
说明
模型服务名称
为本次部署的推理服务实例起的名字。
模型名称
要部署的具体基础模型名称(如qianwen3),指定推理服务加载哪个模型进行推理。可在模型快照列表中查看对应的基础模型名称。
委托
授权模型部署服务访问您云资源的权限凭证,需要选择一个已创建的IAM信任委托,单击“创建委托”进行创建,配置如下:
- 委托名称:由用户自定义
- 信任主体类型:选择“云服务”
- 云服务:填写“智果Agent自优化模型部署”
- 其他参数:使用默认配置
委托创建完成后,按照页面提示进行授权,授权项选择“AgentArtsRLModelDeploymentAgencyPolicy”。
图20 模型部署与接入
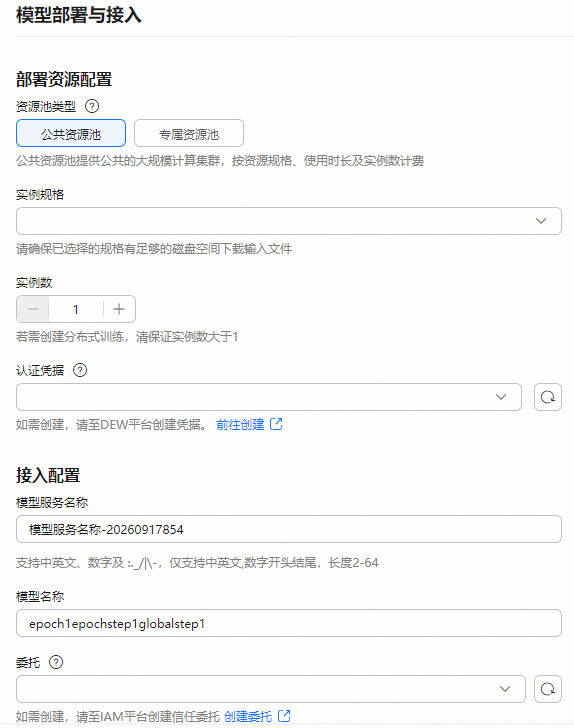
- 部署资源配置:
- 模型部署任务启动后,可以在模型产物列表中查看部署进展。
部署成功显示“运行中”后,单击操作列“应用至智能体”可在对应的智能体中看到,模型已经被替换。
智能体只有经过更新版本重新部署,模型才会被正式应用。
应用模型并更新版本后,智能体中的原模型将被替换。如果智能体已在线上运行,替换可能影响正在进行的业务。建议先在测试环境中验证模型效果,确认无误后再应用到生产环境。如需回滚,可在智能体编辑页面将模型切换回原版本。
图21 应用至智能体
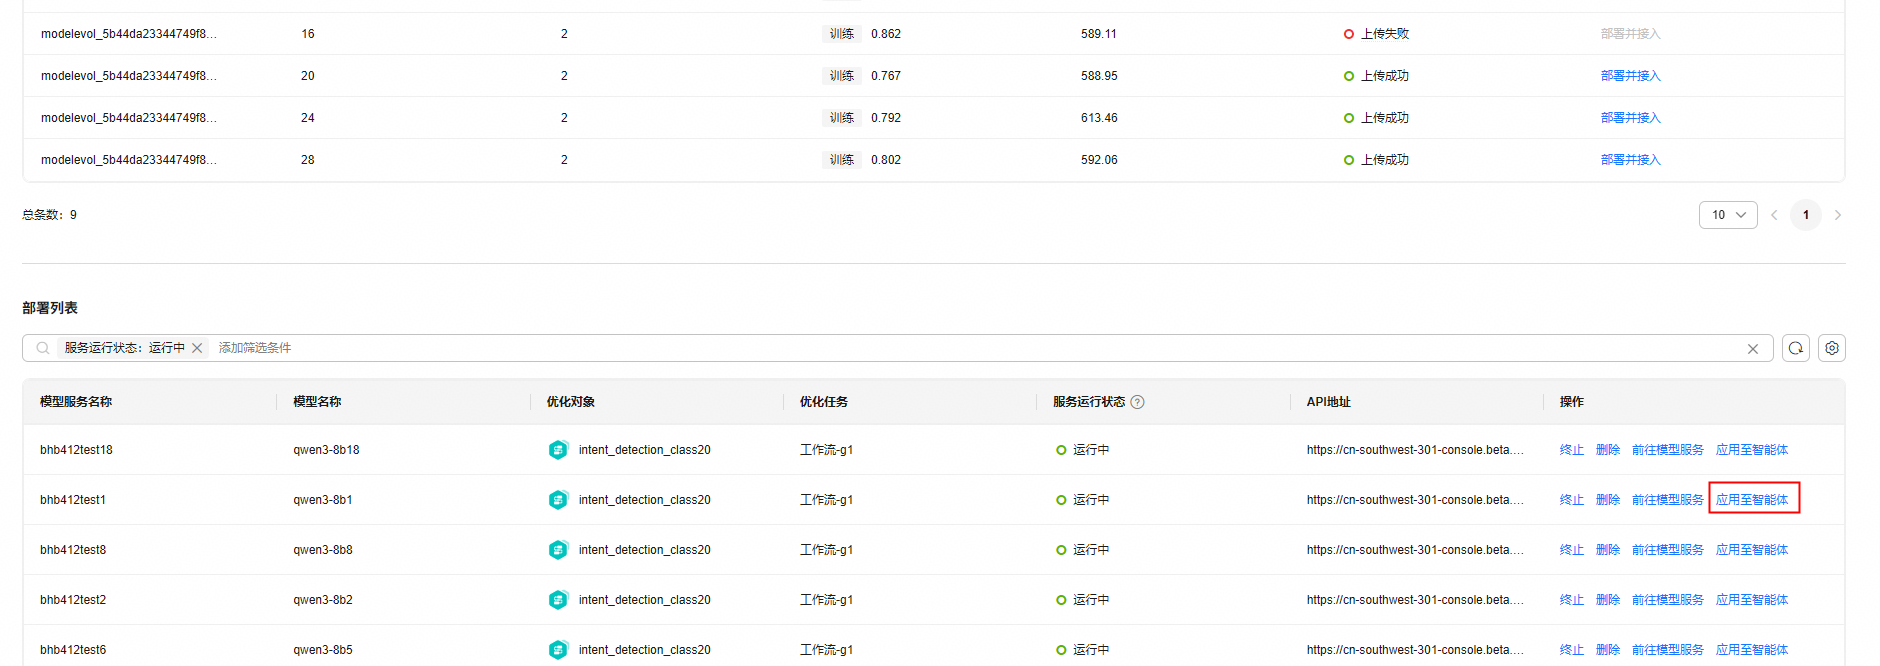 图22 查看智能体中的模型

如果模型部署后效果不如预期,请参考如何挑选最优模型和常见问题。
评估优化效果:
- 准备评测集。 评测数据格式与训练数据集格式一致,需包含input(用户问题)和reference_output(参考答案)字段。
- 在AgentArts平台单击左侧导航栏“观测与优化 > 评估”,进入“评测集”页签。
- 单击“创建评测集”,评测集的名称和描述可以自定义,配置列使用默认值。单击“确定”创建评测集。 图23 创建评测集

- 评测集创建后,会自动跳转至添加数据页面。选择“添加数据 > 手动添加”。 图24 添加数据

- 按照页面指引添加评测数据,完成后单击“提交版本”发布评测集版本。仅已发布版本的评测集可用于评估任务。
建议准备一份从未参与过训练的数据,以此检验模型是否真正学会了业务逻辑,而不是在死记硬背训练数据。
- 选择评估器。
根据模型优化的目标,在创建评估任务时,推荐使用正确性评估器进行打分。
正确性评估器可以评估模型的输出是否正确、准确、真实,并完整覆盖核心要点。通过将智能体的实际输出与预设的参考答案进行对比,评判回答的正确性和完整性。
平台提供多种预置评估器,涵盖正确性、幻觉现象、任务完成度、指令遵从度等维度。如需了解完整的评估器类型及适用场景,请参考预置评估器概览。对于模型优化场景,正确性评估器是推荐的首选。
- 创建评估任务。
- 在AgentArts平台单击左侧导航栏“观测与优化 > 评估”,并进入“评估任务”页签。
- 单击“创建评估任务”并选择“离线评估”(本示例为手动创建的评测数据集,因此选择“离线评估”)。
- 离线评估:基于已创建的评测集进行评估,适用于已有预设评测数据的场景。
- 在线评估:通过调用API产生智能体数据,对实时交互数据进行评测,适用于需要检验智能体在线服务质量的场景。
图26 离线评估

- 选择待评测的智能体、评测集、评估器(选择正确性评估器)后,单击“发起任务”执行评估。
评估任务发起后,可在评估任务列表中查看进度。评估完成后,单击任务名称可进入评估结果页面,查看每条评测数据的原始输入、智能体实际输出、预期输出、评估器得分及评分理由。在“评估报告”页签中,可查看整体评估指标,包括平均分、最高分、最低分和总分,以及评估器指标。


