


更新时间:2026-10-21 GMT+08:00
向量数据库
简介
向量数据库是指任何可以原生存储和管理向量嵌入并且可以处理向量所描述的非结构化数据(如文档、图像、视频、音频等)的数据库。目前,向量数据库已成为推荐引擎(常见于热门零售商和音视频流媒体服务商)、虚拟助手、生物特征模式识别、异常检测等领域的重要基石。此外,向量数据库还开辟了一个新的重要使用场景:存储大规模的非结构化数据,以供生成式AI模型访问并输出更优结果。
原理
向量数据库将当前主流的基于磁盘的向量检索算法融合进GaussDB数据库中,让数据库用户能够使用原生SQL进行向量类型数据的创建、导入和索引构建,查询计划生成以及高效向量检索;在当前版本中,用户可以将向量类型(FloatVector和BoolVector)当做原生类型一样使用,可以通过创建GsIVFFLAT索引或者GsDiskANN索引加速TopK ANN查询。GsIVFFLAT索引通过利用聚类算法将高维向量空间按照距离划分成不同的桶,然后向量检索过程中可以通过查询向量和向量分桶中心点的距离筛选出候选的向量检索集,因此检索代价相比于全量扫描会显著降低,如下图1所示。GsDiskANN索引的原理是对所有的向量点寻找最近邻向量,构建一个稀疏图结构,并且利用松弛系数产生一些捷径边(Shortcut Edge)加速查询,如下图2所示。在此基础上,GaussDB优化了数据删除逻辑,保证性能的基础上能够做到实时删除感知,并且长时间运行不损失精度。GaussDB向量索引支持高并发检索和修改,底层存储支持Astore和Ustore两种,支持MVCC并发控制。GaussDB向量数据库增加了日志类型,支持完整的高可用能力,比如并行回放、极致RTO等能力。


在大模型场景中,向量数据库作为大模型技术栈中的“海马体”,承担着长短期记忆的职责。具体来说分为三种能力,长期记忆、短期记忆和临时缓存,如图3所示。
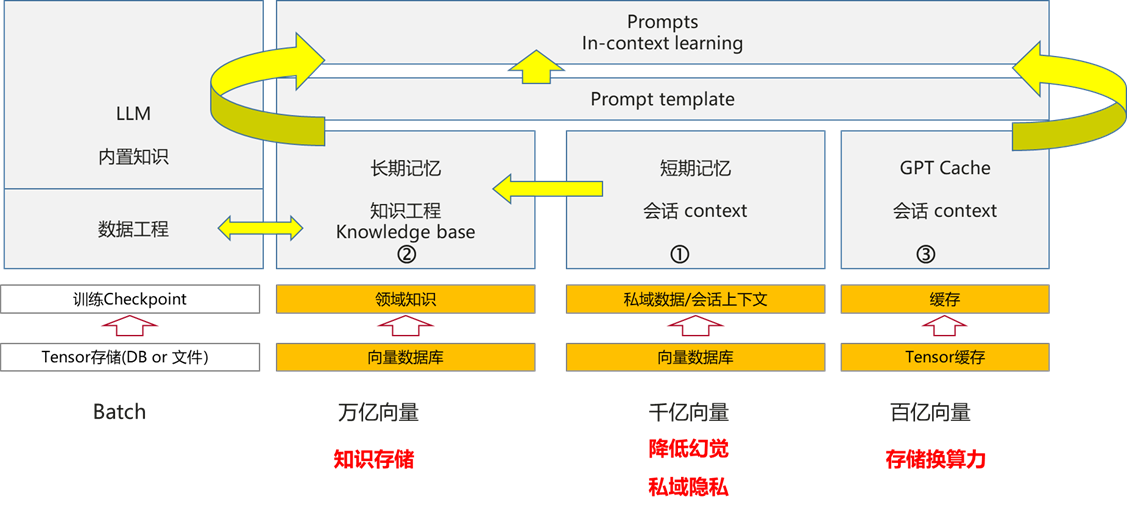
- 长期记忆:主要用于知识库场景。业务特点是万亿级别数据量,对于检索召回率要求很高,向量数据库可以通过相似检索对Prompt做补充,提高回答准确率和效率,解决大模型“幻觉”问题。
- 短期记忆:主要用于会话上下文场景。业务特点是千亿级别数据量,要求高效的数据插入和检索,向量数据库可以通过相似检索补充新问题Prompt,生成新问题答案并且保存在数据库中。
- 临时缓存:主要用于答案生成过程加速场景。业务特点是数据量大,要求高效的数据更新和检索,向量数据库临时保存之前出现过的字符前缀embedding以及需要产生的下一个字符,通过检索可以加速答案生成过程。
示例
在机器学习和自然语言处理中,Embedding是指将高维度的数据(例如文字、图片、音频)映射到低维度空间的过程。Embedding向量通常是一个由实数构成的向量,它将输入的数据表示成一个连续的数值空间中的点。简而言之,Embedding是一个N维的实值向量,可以用来表示任何事情,如文本、音乐、视频等。
本小节介绍向量数据库的基本功能,包括创建向量表、修改向量属性类型、管理向量数据、清空表格等操作。
- 创建含向量类型的表,同时设定数据维度。建表时向量类型必须要指定维度,当插入数据的维度与设置的数据维度不一致时,数据库报错。
gaussdb=# CREATE TABLE t1(id int unique, repr floatvector(4));
gaussdb=# CREATE TABLE t2(id int unique, repr boolvector(3));
- 增加向量列。需指定默认值,否则数据库报错。
gaussdb=# ALTER TABLE t1 ADD COLUMN floatvec floatvector(3) default '[1,1,1]'; - 修改表中的向量数据类型属性。可以通过ALTER TABLE语句修改向量维度。
gaussdb=# ALTER TABLE t1 ALTER COLUMN repr type floatvector(4);注意:如果表中已经插入数据,变换向量维度时需要表中数据符合维度设定,否则数据库报错;当向量属性已创建向量索引,属性的数据类型无法切换到其他数据类型,数据库报错。
- 插入数据。
gaussdb=# INSERT INTO t1 VALUES(0, '[30,12,12,25]');
gaussdb=# INSERT INTO t1 VALUES(1, '{7.5,62,1,235}');
字符型数据隐式转化为向量数据类型。
gaussdb=# INSERT INTO t2 VALUES(2, '[1, 0, 1]');
gaussdb=# INSERT INTO t2 VALUES(3, '[T, T, F]');
gaussdb=# INSERT INTO t2 VALUES(4, '[false, true, true]');
gaussdb=# INSERT INTO t2 VALUES(5, '[Y, N, N]');
gaussdb=# INSERT INTO t2 VALUES(6, '[no, yes, no]');
gaussdb=# INSERT INTO t2 VALUES(7, '[off, off, on]');
gaussdb=# INSERT INTO t2 VALUES(8, '[1, yes, on]');
- 删除数据。
gaussdb=# DELETE t1 where repr <-> '[30,12,12,25]' < 0.2; - 对向量列和非向量列的更新和删除操作,以及VACUUM操作。
gaussdb=# UPDATE t1 SET id = 38;
gaussdb=# UPDATE t1 SET repr = '[1000,152,132,5]';
gaussdb=# DELETE FROM t1 WHERE id=38;
gaussdb=# DELETE FROM t1 WHERE repr='[30,12,12,25]';
gaussdb=# DELETE FROM t1 WHERE repr <-> '[30,12,12,25]' < 0.8;
gaussdb=# VACUUM t1;
父主题: 基础概念


