


更新时间:2026-10-09 GMT+08:00
Lance Late Read调优说明
Late Read(延迟读)是Lance外表针对向量top-k查询的性能优化特性。该特性通过将数据扫描拆分为“早读阶段”和“延迟读”两个阶段,显著减少宽列(如图片、长文本、原始向量)的无效读取量,从而提升查询性能。
在普通计划下,SELECT <宽列> FROM t ORDER BY vec <-> q LIMIT k需要把全表所有候选行的全部投影列读出来,再排序取top-k。宽列(图片、bytea、长文本、原始向量)在排序前被读取,绝大部分随后被丢弃。
Late Read把扫描分为两步:
- 早读阶段:只读_rowid、xc_node_id、_distance三个系统列,加上WHERE谓词列/JOIN key列,走IVF索引产出候选集,排序取top-k。
- 延迟读阶段:把top-k的_rowid按xc_node_id路由回数据所在DN(RESTORE流),只对这k行调用Lance take_rows取回宽列。宽列的读取量从O(候选行数 × 宽列宽度) 降到O(k × 宽列宽度)。
Late Read执行策略
Late Read支持两种执行策略,您可以通过参数指定或由优化器自动选择。
- 一阶段(single_phase) 图1 一阶段Late Read计划示意图
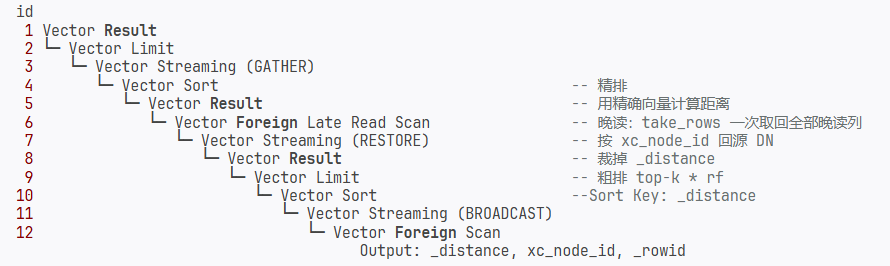
特点:计划层次浅、只有一次RESTORE+一次take_rows,但宽列是为粗排候选集取的,其中会有一部分行在后续精排中被淘汰,这部分宽列IO是浪费的。
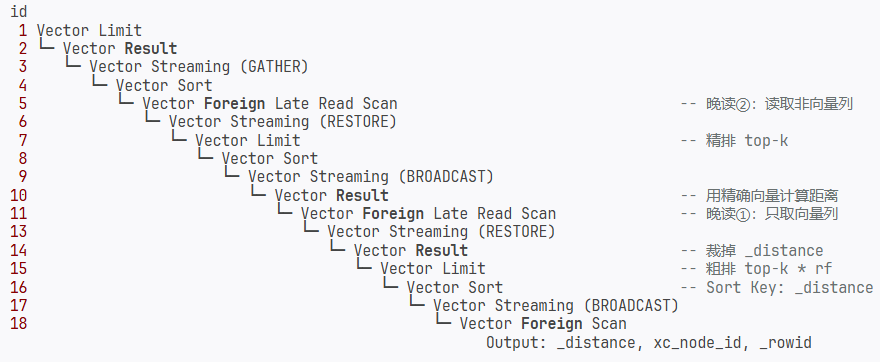
GUC参数说明
late_read_strategy
- 参数说明:设置Lance DFS表top-k查询的Late Read策略。取值为列表,其中none/single_phase/two_phase/auto四个策略选项互斥,nested_late_read和join_late_read分别为独立开关。
- 取值范围:
- none:关闭Late Read。走原始计划,所有投影列在扫描阶段一次读全。
- auto:由优化器按代价与列宽自动在none、single_phase、two_phase之间选择。
- single_phase:规则强制走一阶段,跳过收益检查。
- two_phase:规则强制走二阶段,跳过收益检查。
- nested_late_read:独立开关,允许Late Read在嵌套查询块(子查询、CTE)中生效。
- 未设置时(默认):子查询和CTE内部的查询不走Late Read。
- 设置后:每个查询块独立判定Late Read,子查询和CTE内部的top-k查询可以走Late Read。
- join_late_read:独立开关,允许Late Read跨INNER JOIN生效(仅支持hashjoin)。设置后,Late Read仍需同时满足以下全部条件方可生效:
- 所有连接均为INNER JOIN(存在outer/semi/anti join则回退为普通计划)。
- 查询中有且仅有一个Lance top-k驱动表,且查询中Lance表数量与之相等。
- 驱动表存在等值连接条件。
- 无聚集、GROUP BY、DISTINCT、集合操作。
- 默认值:none。
enable_topk_compensation
- 参数说明:设置是否开启Lance ANN扫描的top-k补偿读。开启后,Lance ANN扫描使用基于filter_ratio的k值计算和while-loop补偿机制,确保WHERE过滤后仍能返回LIMIT n行。
- 取值范围:
- on:开启后,会启动while-loop补偿机制,确保最终输出的行数满足k值要求。
- off:关闭时,当where过滤率比较大时,可能输出远小于k值的行数。
- 默认值:off。
父主题: Lance on Aura


