


更新时间:2026-10-09 GMT+08:00
Spark对接Iceberg Catalog
AI DataLake Spark支持使用LakeFormation管理Paimon和Iceberg表的元数据和鉴权(行、列权限),简化数据湖治理,实现统一元数据管理、细粒度权限控制和事务性保证。Spark对Paimon和Iceberg的读写基于数据目录Catalog,您可以根据业务场景选择数据目录。
约束与限制
- 已创建LakeFormation实例并规划元数据。
LakeFormation Catalog需要和AI DataLake工作空间位于同一地域,否则无法在后续流程中完成关联。
- 配置Paimon或Iceberg数据目录后,生效优先级为:作业级别配置> 端点级别配置,如果在端点配置参数,SparkSQL作业需要重启端点,配置修改才会生效。
配置数据目录
使用默认数据目录
AI DataLake Spark默认数据目录为Iceberg,即系统已默认配置spark.aidatalake.lakehouse.default.format=iceberg,无需您手动配置。
使用自定义数据目录
- Iceberg不支持自定义函数。
- 如果当前选择的非自定义Catalog,则走您配置的默认数据目录(即spark.aidatalake.lakehouse.default.format的参数值)。
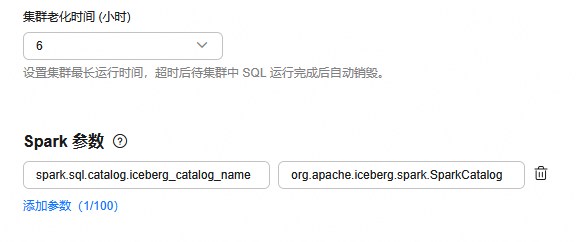
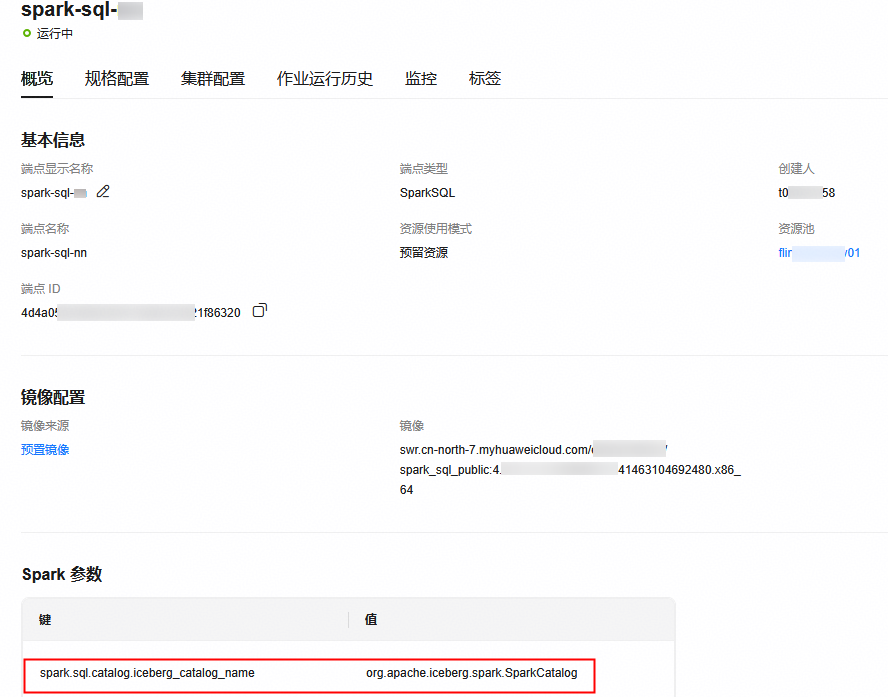
需要配置spark.sql.catalog.{iceberg_catalog_name}=org.apache.iceberg.spark.SparkCatalog,其中iceberg_catalog_name修改为您的目标数据目录名称。
配置方法:
- 在API接口的spark_config中配置参数。 接口详情请参见RunSparkJob或RunSparkSql。API请求示例如下。
"endpoint_name": "spark-sql-test", "catalog_context": { "catalog_name": "iceberg_catalog_name",//和配置中的catalog名字保持一致,此Catalog只能用于iceberg。 "database_name": "default" }, "statement": "SELECT * FROM iceberg_catalog_name.db.your_table LIMIT 10",//支持三段式配置。 "spark_config": { "spark.sql.catalog.iceberg_catalog_name": "org.apache.iceberg.spark.SparkCatalog" } } - 在创建端点或者修改端点页面配置
- 在创建端点页面配置 图1 创建端点页面配置
- 在端点修改页面配置 图2 端点修改页面配置
- 在创建端点页面配置
父主题: Iceberg on Spark


