


开始使用

部署在线服务
- 选择"模型推理 > 在线推理",进入在线服务管理页面。 图1 在线服务管理页面

- 单击右上角的"部署",进入"部署在线服务"页面。
- 在部署在线服务页面,基本信息可参考如下表1 服务信息填写完成后,单击"下一步",进行部署配置。 图2 基本信息配置
 图3 网络信息配置
 图4 高可用配置

表1 服务信息 参数类别
参数名称
参数说明
取值示例
基础信息
服务名称
自定义服务名称,建议加上模型名称。
Qwen3-14B
网络配置
服务接入方式
选择"默认",使用ModelArts平台能力。
默认
网络配置
服务协议
选择"HTTP",请求超时按需修改。
HTTP
网络配置
认证方式
按需选择服务认证方式
API KEY 认证
高可用配置
流控策略
流控策略由“策略类型”与“流控方式”组成,相同的策略不支持重复添加,多个策略将作为规则集组合生效。
保持默认
高可用配置
请求超时时间(秒)
发送请求后等待系统返回首Token结果的最长等待时间,输入值必须在1到1200之间,单位:秒,超过该时间仍未收到回复,请求将被自动终止。流式传输场景下,每次收到请求响应时,会重新刷新该超时时间,但系统端到端响应超时时间固定为 3600 秒。
根据具体使用调节
- 在部署配置页面填写配置参数。
- 资源配置:根据需要选择公共资源池或者专属资源池,本文档以公共资源池为例。 图5 资源配置

- 单元配置:选择基础模型,单元实例规格为部署模型需要的最小卡数,参考表2中的最小卡数(64G显存),镜像类型为选择自定义镜像,镜像源地址为lm_inference文件下的镜像。如果选择专属资源池也可以参考推理单元参数说明的自定义规格分配。 图7 单元配置

- 启动命令,根据实际部署模型替换对应的变量。
- 如果是表2中的模型,启动命令如下:
sh /home/models-file/code/run_vllm_908.sh ${model_name} ${port} ${required_cards} - 如果是表3中的模型,启动命令如下: MinerU模型:
sh /home/models-file/code/run_vllm_mineru.sh ${model_name} ${port} ${required_cards}其他模型:sh /home/models-file/code/run_vllm_open_source.sh ${model_name} ${port} ${required_cards}
变量解释:
- model_name:模型名称,和表2表3 支持的模型及其最小卡数和最大序列中的模型名称一致
- required_cards:NPU卡的数量,参考表2表3 支持的模型及其最小卡数和最大序列中的最小卡数
- port:服务部署的端口
- 如果是表2中的模型,启动命令如下:
- 单击创建凭据,自定义填写凭据名称,企业项目,参考访问密钥获取账号的AK,SK。键为accessKeyId和secretAccessKey,值分别对应用户的AK、SK信息。 图9 创建凭据

- 部署管理配置中容器协议为http,容器端口和图8启动命令中的port变量值保持一致,填写完配置参数单击下一步,启动部署任务。 图10 部署管理配置

- 资源配置:根据需要选择公共资源池或者专属资源池,本文档以公共资源池为例。


测试在线服务
通过API接口在魔坊(ModelArts)模型训推平台的在线推理页面验证推理服务可用性。本文章只是示例,详细可参考测试在线服务。
- 进入在线推理服务列表,选择部署成功的在线推理服务,单击服务调用,复制调用地址。 图11 获取调用地址

- 进入在线推理服务列表,单击API Key管理。 图12 创建API Key
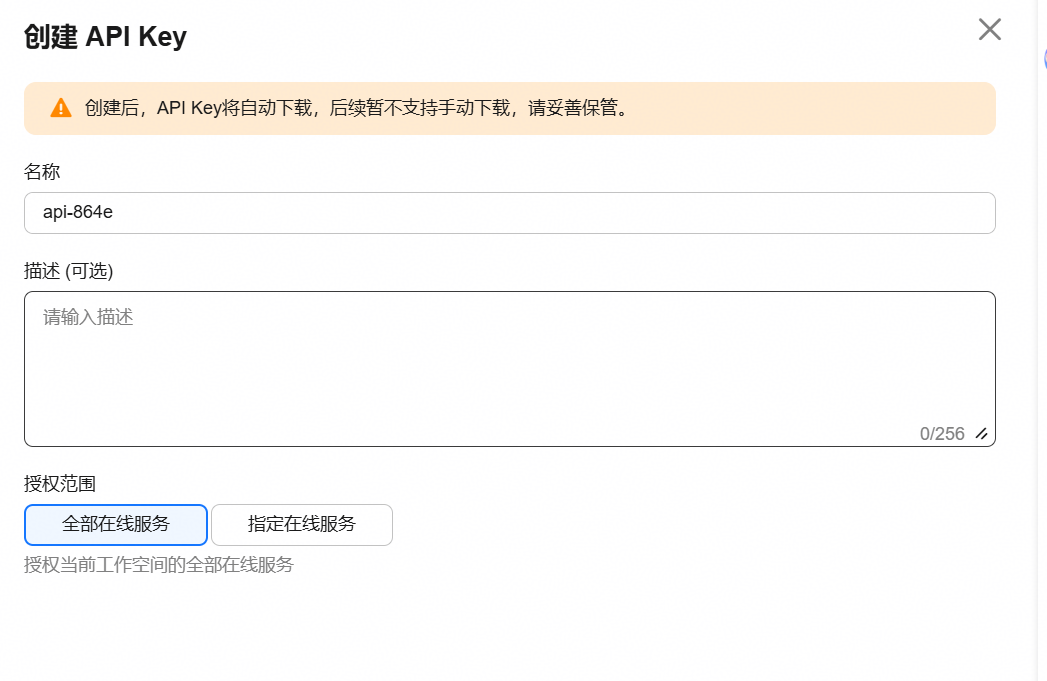
- 单击要预测的服务名称,进入详情页,选择"预测"页签。 图13 预测页签

- 设置请求参数。 示例:
- 请求方法:POST
- 请求URL:步骤1复制的URL+/v1/completions
- Headers:填写Header信息,比如api-key鉴权信息。例如:Authorization:'Bearer ' + api_key
- 数据格式:stream
- 请求Body:模型名称需要和表2表3 支持的模型及其最小卡数和最大序列中模型名称保持一致
{   "model": ${name},
    "prompt": "The future of AI is",
    "max_completion_tokens": 50,
    "temperature": 0
}
- 单击"预测",在预测结果处查看返回结果,服务正常时返回模型名称、模型信息和回答内容。 图14 预测模型

通过curl命令预测
通过OpenAI服务API接口启动服务使用以下推理测试命令。
- ${url}:进入在线推理服务列表,选择部署成功的在线推理服务,单击服务调用,复制调用地址。
- ${container_model_path} :和表2 表3支持的模型及其最小卡数和最大序列模型名称一致。
- ${API-Key}:步骤2创建的API Key,无认证该参数无需填写。
curl -X POST ${url}/v1/completions \
-H "Content-Type: application/json" \
-H 'Authorization: Bearer ${API-Key}' \
-d '{
      "model": "${container_model_path}",
      "prompt": "hello",
      "max_tokens": 32,
      "temperature": 0
}'
OpenAI Chat Completions API with vLLM
curl -X POST ${url}/v1/chat/completions \
-H "Content-Type: application/json" \
-H 'Authorization: Bearer ${API-Key}' \
-d '{
    "model": "${container_model_path}",
    "messages": [
        {
            "role": "user",
            "content": "hello"
        }
    ],
    "max_tokens": 32,
    "temperature": 0
}' 服务的API与vLLM官网相同,此处介绍关键参数。详细参数解释请参见官网https://docs.vllm.ai/en/stable/api/vllm/vllm.sampling_params.html
OpenAI服务相关请求参数说明请参照表2。
| 参数 | 是否必选 | 默认值 | 参数类型 | 描述 |
|---|---|---|---|---|
| model | 是 | 无 | Str | 通过OpenAI服务API接口启动服务时,推理请求必须填写此参数。取值必须和启动推理服务时的model ${container_model_path} 参数保持一致。 通过vLLM服务API接口启动服务时,推理请求不涉及此参数。 |
| prompt | 是 | - | Str | 请求输入的问题。 |
| max_tokens | 否 | 16 | Int | 每个输出序列要生成的最大tokens数量。 |
| top_k | 否 | -1 | Int | 控制要考虑的前几个tokens数量的整数。设置为-1表示考虑所有tokens。 适当降低该值可以减少采样时间。 |
| top_p | 否 | 1.0 | Float | 控制要考虑的前几个tokens的累积概率的浮点数。必须在(0, 1]范围内。设置为1表示考虑所有tokens。 |
| temperature | 否 | 1.0 | Float | 控制采样的随机性的浮点数。较低的值使模型更加确定性,较高的值使模型更加随机。0表示贪婪采样。 |
| stop | 否 | None | None/Str/List | 用于停止生成的字符串列表。返回的输出将不包含停止字符串。 例如:["你", "好"],生成文本时遇到"你"或者"好"将停止文本生成。 |
| stream | 否 | False | Bool | 是否开启流式推理。默认为False,表示不开启流式推理。 |
| n | 否 | 1 | Int | 返回多条正常结果。 约束与限制: 不使用beam_search场景下,n取值建议为1≤n≤10。如果n>1时,必须确保不使用greedy_sample采样。也就是top_k > 1; temperature > 0。 使用beam_search场景下,n取值建议为1<n≤10。如果n=1,会导致推理请求失败。 说明: n建议取值不超过10,n值过大会导致性能劣化,显存不足时,推理请求会失败。 |
| use_beam_search | 否 | False | Bool | 是否使用beam_search替换采样。 约束与限制:使用该参数时,如下参数需按要求设置: n>1 top_p = 1.0 top_k = -1 temperature = 0.0 警告: 使用 beam_search 时,需显式设置 max_tokens,避免请求无法按预期停止。 |
| presence_penalty | 否 | 0.0 | Float | presence_penalty表示会根据当前生成的文本中新出现的词语进行奖惩。取值范围[-2.0,2.0]。 |
| frequency_penalty | 否 | 0.0 | Float | frequency_penalty会根据当前生成的文本中各个词语的出现频率进行奖惩。取值范围[-2.0,2.0]。 |
| length_penalty | 否 | 1.0 | Float | length_penalty表示在beam search过程中,对于较长的序列,模型会给予较大的惩罚。 如果要使用length_penalty,必须添加如下三个参数,并且需将use_beam_search参数设置为true,best_of参数设置大于1,top_k固定为-1。 "top_k": -1 "use_beam_search":true "best_of":2 |
| ignore_eos | 否 | False | Bool | ignore_eos表示是否忽略EOS并且继续生成token。 |
| guided_json | 否 | None | Union[str,dict,BaseModel] | 使用openai启动服务,如果需要使用JSON Schema时要配置guided_json参数。 |
通过OpenAI服务API接口启动服务使用以下推理测试命令。
- ${url}:进入在线推理服务列表,选择部署成功的在线推理服务,单击服务调用,复制调用地址。
- ${container_model_path} :和表2 表3支持的模型及其最小卡数和最大序列模型名称一致。
- ${API-Key}:步骤2创建的API Key,无认证该参数无需填写。
curl -X POST ${url}/v1/rerank \
    -H "Content-Type: application/json" \
    -H 'Authorization: Bearer ${API-Key}' \
    -d '{
        "model": "${container_model_path}",
        "query": "What is the capital of France?",
        "documents": [
            "The capital of France is Paris",
            "Reranking is fun!",
            "vLLM is an open-source framework for fast AI serving"
        ]
}' | 参数 | 是否必选 | 默认值 | 参数类型 | 描述 |
|---|---|---|---|---|
| model | 是 | 无 | Str | ${container_model_path} 的值和表2表3 支持的模型及其最小卡数和最大序列模型名称一致; |
| query | 是 | 无 | Str | 用户查询文本 |
| documents | 是 | 无 | Str | 待排序文档列表(通常为Embedding召回的Top-K结果) |
curl -X POST ${url}/v1/embeddings \
    -H "Content-Type: application/json" \
    -H 'Authorization:Bearer${API-Key}' \
    -d '{
        "model": "${container_model_path}",
        "input":"I love shanghai"
}' | 参数 | 是否必选 | 默认值 | 参数类型 | 描述 |
|---|---|---|---|---|
| model | 是 | 无 | Str | ${container_model_path} 的值和表2表3 支持的模型及其最小卡数和最大序列模型名称一致; |
| input | 是 | 无 | Str | 支持字符串或字符串列表 |
- ${url}:进入在线推理服务列表,选择部署成功的在线推理服务,单击服务调用,复制调用地址。
- ${container_model_path} :和表2 表3支持的模型及其最小卡数和最大序列模型名称一致。
- ${API-Key}:步骤2创建的API Key,无认证该参数无需填写。
- ${image_url}值为图片地址(如https://example.com/cat.jpg)。
curl ${url}/v1/chat/completions \
    -H "Content-Type: application/json" \
    -H 'Authorization: Bearer ${API-Key}' \
    -d '{
    "model": "${container_model_path}",
    "messages": [
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": [
            {"type": "image_url", "image_url": {"url": "${image_url}"}},
            {"type": "text", "text": "图片中内容"}
        ]}
    ],
    "max_tokens": 512,
    "temperature": 0.7
}' 调用MinerU3.4
接口详情
通过API接口使用以下推理测试命令。
- ${url}:进入在线推理服务列表,选择部署成功的在线推理服务,单击服务调用,复制调用地址。
GET /health:健康检查。
无参数。返回服务健康状态,用于探活。
curl ${url}/health POST /file_parse:同步解析
上传文件并等待解析完成,直接在 HTTP 响应中返回结果。适合小文件或即时场景。大文件可能超时,建议使用异步接口。
curl -X POST ${url}/file_parse \
-F 'files=@test.pdf' \
-F 'backend=hybrid-engine' \
-F 'return_md=true' | 方法 | 路径 | 说明 | 模式 |
|---|---|---|---|
| GET | /health | 健康检查 | — |
| POST | /file_parse | 同步解析,阻塞等待结果 | 同步 |
| POST | /tasks | 异步提交,返回 task_id | 异步 |
| GET | /tasks/{task_id} | 查询任务状态 | 异步 |
| GET | /tasks/{task_id}/result | 获取任务结果 | 异步 |
| 参数 | 必填 | 默认值 | 说明 |
|---|---|---|---|
files | 是 | — | 上传文件,支持 PDF / 图片 / DOCX / PPTX / XLSX |
backend | 否 | hybrid-engine | 解析后端:pipeline / vlm-engine / hybrid-engine |
effort | 否 | medium | hybrid 精度:medium 快 / high 准 |
parse_method | 否 | auto | 解析方式:auto / txt / ocr |
lang_list | 否 | ch | 语言:ch / korean / arabic 等 |
formula_enable | 否 | true | 是否启用公式识别 |
table_enable | 否 | true | 是否启用表格识别 |
image_analysis | 否 | true | 是否启用图片/图表分析 |
return_md | 否 | true | 返回 Markdown 结果 |
returnmiddlejson | 否 | false | 返回中间 JSON 结果 |
return_images | 否 | false | 返回提取的图片 |
startpageid | 否 | 0 | 起始页码,从 0 开始 |
endpageid | 否 | 99999 | 结束页码 |
异步流程:
提交任务 → 轮询状态 → 获取结果
POST /tasks:异步提交
上传文件并提交解析任务,立即返回 task_id。后续轮询状态,完成后拉取结果。适合大文件或批量处理。
curl -X POST ${url}/tasks \
-F 'files=@test.pdf' \
-F 'backend=hybrid-engine'
GET /tasks/{task_id}:查询状态
根据 task_id 查询当前状态。典型流程:pending → running → completed / failed。
curl ${url}/tasks/{task_id} GET /tasks/{task_id}/result:获取结果
任务 completed 后调用,获取最终解析结果。返回内容取决于提交时指定的返回参数,可能为 Markdown / JSON / 图片。
curl ${url}/tasks/{task_id}/result 异步完整示例。需提前安装 jq。
# 1. 提交异步任务
TASK_ID=$(curl -s -X POST ${url}/tasks \
-F 'files=@document.pdf' \
-F 'backend=hybrid-engine' \
-F 'effort=high' \
-F 'return_md=true' \
-F 'formula_enable=true' \
-F 'table_enable=true' | jq -r .task_id)
# 2. 轮询状态直到完成
while true; do
  STATUS=$(curl -s ${url}/tasks/$TASK_ID | jq -r .status)
  echo "Status: $STATUS"
  [ "$STATUS" = "completed" ] && break  [ "$STATUS" = "failed" ] && { echo "Task failed!"; exit 1; }
  sleep 3
done
# 3. 获取最终结果
curl -s ${url}/tasks/$TASK_ID/result | jq . | 场景 | backend | effort | 说明 |
|---|---|---|---|
| 快速文本提取 | pipeline | — | 纯规则解析,速度最快,适合纯文本 PDF |
| 高精度解析 | hybrid-engine | high | 混合引擎 + 高精度,适合复杂版面、公式表格 |
| 平衡模式(默认) | hybrid-engine | medium | 速度与精度兼顾,推荐日常使用 |
| 视觉模型解析 | vlm-engine | — | 纯 VLM 引擎,适合扫描件 / 图片 |
模型预热(可选)
- 登录ModelArts管理控制台。
- 预热模型权重按照如下操作:
- 在左侧菜单栏中选择"资源管理 > 专属算力资源 > 资源池"。
- 在资源池列表,选择目标专属资源池,单击名称,进入详情页。
- 选择"预热任务",单击"添加预热任务",在对话框中完成任务配置。此处仅列出关键参数配置说明,详细操作请参见在专属资源池添加模型预热。
- 配置完成后,单击"确定"提交模型预热任务。 当"预热状态"变成"保温中"则表示模型预热已完成。
表4 添加模型预热任务的关键参数说明
参数名称
参数说明
取值示例
权重路径地址
选择待预热的模型权重文件的OBS路径。即步骤一的路径。
obs://xxx/models/
文件占用空间
根据需要预热的模型权重文件大小输入数值。选择完"权重路径地址"后,单击"获取权重文件占用空间"获取到推荐值,一般情况下,该预测值略大于模型实际目录大小。
780
- 返回ModelArts主菜单栏,选择"模型推理 > 在线推理",进入在线服务管理页面。


