# 配置Spark通过IAM委托访问OBS
参考[配置MRS集群通过IAM委托对接OBS](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0768.html)完成存算分离集群配置后,即可在Spark客户端创建Location为OBS路径的表。
#### 使用Spark beeline对接OBS
1. 登录MRS集群Manager界面,具体请参见[访问MRS集群Manager](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0128.html),选择"集群 \> 服务 \> Spark2x \> 配置 \> 全部配置"。
在左侧的导航列表中选择"JDBCServer2x \> 自定义"。在参数"spark.hdfs-site.customized.configs"中添加配置项"dfs.namenode.acls.enabled",值为"false",关闭HDFS ACL功能。
图1添加Spark自定义参数

2. 在搜索框中搜索参数"spark.sql.statistics.fallBackToHdfs",修改该参数值为"false"。
图2修改"spark.sql.statistics.fallBackToHdfs"参数值

3. 保存配置并重启JDBCServer2x实例。
4. 使用安装客户端用户登录客户端安装节点。
下载并安装集群客户端的具体操作,请参考[安装MRS集群客户端](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0089.html)。
5. 配置环境变量。
```
source 客户端安装目录/bigdata_env
```
6. 如果集群启用了Kerberos认证,使用以下命令用户进行用户认证,如果当前集群未启用Kerberos认证,则无需执行此命令。
```
kinit 用户名
```
7. 在spark-beeline中访问OBS,例如在"obs://mrs-word001/table/"目录中创建表"test"。
访问spark-beeline:
```
spark-beeline
```
创建表**test**:
```
create table test(id int) location 'obs://mrs-word001/table/';
```
8. 执行如下命令查询所有表,返回结果中存在表test,即表示访问OBS成功。
```
show tables;
```
图3Spark2x验证返回已创建的表名

9. 使用"Ctrl + C"退出spark beeline。
#### 使用spark sql对接OBS
1. 使用安装客户端用户登录客户端安装节点。
下载并安装集群客户端的具体操作,请参考[安装MRS集群客户端](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0089.html)。
2. 配置环境变量。
```
source 客户端安装目录/bigdata_env
```
3. 修改配置文件:
```
vim 客户端安装目录/Spark2x/spark/conf/hdfs-site.xml
```
修改如下内容,"dfs.namenode.acls.enabled"参数用于设置是否启用HDFS ACL功能:
```
dfs.namenode.acls.enabled
false
```
4. 如果集群启用了Kerberos认证,使用以下命令用户进行用户认证,如果当前集群未启用Kerberos认证,则无需执行此命令。
```
kinit 用户名
```
5. 在spark-sql中访问OBS,例如在"obs://mrs-word001/table/"目录中创建表"test"。
1. 进入spark bin目录:
```
cd 客户端安装目录/Spark2x/spark/bin
```
2. 登录spark-sql命令行:
```
./spark-sql
```
3. 在spark-sql命令行执行以下命令创建表:
```
create table test(id int) location 'obs://mrs-word001/table/';
```
6. 执行以下命令查看表是否存在:
```
show tables;
```
7. 执行**exit** **;** 退出spark-sql命令行。

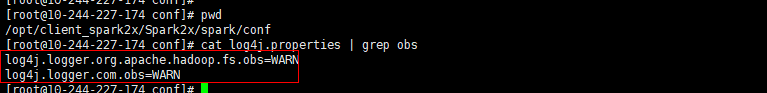
OBS文件系统打印大量日志可能导致读写性能受影响,可通过调整OBS客户端日志级别优化,日志调整方式如下:
1. 切换至"conf"目录下:
```
cd 客户端安装目录/Spark2x/spark/conf
```
2. 编辑"log4j.properties"文件:
```
vi log4j.properties
```
3. 在文件中添加OBS日志级别配置:
```
log4j.logger.org.apache.hadoop.fs.obs=WARN
log4j.logger.com.obs=WARN
```
图4添加OBS日志级别
#### 使用Spark Shell读取OBS文件
1. 使用安装客户端用户登录客户端安装节点。
下载并安装集群客户端的具体操作,请参考[安装MRS集群客户端](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0089.html)。
2. 配置环境变量。
```
source 客户端安装目录/bigdata_env
```
3. 修改配置文件:
```
vim 客户端安装目录/Spark2x/spark/conf/hdfs-site.xml
```
修改如下内容,"dfs.namenode.acls.enabled"参数用于设置是否启用HDFS ACL功能:
```
dfs.namenode.acls.enabled
false
```
4. 如果集群启用了Kerberos认证,使用以下命令用户进行用户认证,如果当前集群未启用Kerberos认证,则无需执行此命令。
```
kinit 用户名
```
5. 执行以下命令登录spark-sql命令行:
切换至"bin"目录下:
```
cd 客户端安装目录/Spark2x/spark/bin
```
登录spark-sql命令行:
```
./spark-sql
```
6. 执行以下命令在OBS中创建表并插入数据:
1. 创建数据库:
```
create database test location "obs://并行文件系统路径/test";
```
2. 切换数据库
```
use test;
```
3. 创建表:
```
create table test1(a int,b int) using parquet;
```
4. 向表中插入数据
```
insert into test1 values(1,2);
```
5. 查看表详情:
```
desc formatted test1;
```
如[图5]所示表的Location为OBS路径。
图5查看表Location

6. 执行**exit** **;**退出spark-sql命令行。
7. 进入spark bin目录:
```
cd 客户端安装目录/Spark2x/spark/bin
```
8. 执行以下命令登录**spark-shell** 命令行:
```
./spark-shell
```
9. 在spark-shell命令行执行以下命令查询[5.c]创建的表数据:
```
spark.read.format("parquet").load("obs://并行文件系统路径/test1").show();
```
查看到的表数据如[图6]所示。
图6查看表数据

10. 执行**:quit**退出spark-shell命令行。