# 运行SparkSql作业
SparkSql是Spark生态中用于结构化数据处理的模块,它将关系型SQL查询与Spark的分布式计算能力结合,支持使用SQL语句或DataFrame/Dataset API操作数据。SparkSql作业可以在批处理、流处理(如Structured Streaming)和交互式查询场景中运行,具备高性能、易用性和扩展性的特点。
用户可将自己开发的程序提交到MRS中,执行程序并获取结果,本章节指导您如何在MRS集群中提交一个SparkSql作业。
SparkSql作业支持SQL语句和Script脚本两种形式,如果SQL语句涉及敏感信息,也可使用脚本文件方式提交。
用户可以在MRS管理控制台在线创建一个作业并提交运行,也可以通过MRS集群客户端来以命令行形式提交作业。
#### 操作视频
本视频以在MRS集群的管理控制台上提交并查看SparkSql作业为例进行说明。
因不同版本操作界面可能存在差异,相关视频供参考,具体以实际环境为准。
#### 前提条件
- 用户已经将作业所需的程序包和数据文件上传至OBS或HDFS文件系统中。
- 如果作业程序需要读取以及分析OBS文件系统中的数据,需要先配置MRS集群的存算分离,请参考[配置MRS集群存算分离](https://support.huaweicloud.com/usermanual-mrs/mrs_01_248987.html)。
#### 约束与限制
- 当IAM用户的用户组的所属策略从MRS ReadOnlyAccess向MRS CommonOperations、MRS FullAccess、MRS Administrator变化时,或者反之从MRS CommonOperations、MRS FullAccess、MRS Administrator向MRS ReadOnlyAccess变化时,由于集群节点的SSSD(System Security Services Daemon)缓存刷新需要时间,因此用户同步完成后,请等待5分钟,待新策略生效之后,再到MRS管理控制台在线提交作业,否则会出现提交作业失败的情况。
- 当前IAM用户名中存在空格时(例如admin 01),不支持通过MRS管理控制台添加作业。
#### 提交作业
用户可通过管理控制台在线创建并运行作业,也可以通过集群客户端命令方式手动提交。
- [通过管理控制台提交作业]
1. 开发SQL脚本。
SparkSql作业可以直接执行SQL语句,也可以指定执行开发好的SQL脚本文件。
在本章节示例中,以在Spark中创建Hive数据表并插入数据的脚本为例,将开发好的脚本"spark_basic.sql"文件上传至HDFS、OBS或者MRS集群节点本地的指定目录中,请参考[上传应用数据至MRS集群](https://support.huaweicloud.com/usermanual-mrs/zh-cn_topic_0019489057.html)。
```
-- 创建表
CREATE TABLE IF NOT EXISTS test_table1 (
id INT,
name STRING,
age INT,
gender STRING
)
USING parquet
OPTIONS (
path '/user/hive/warehouse/test_table1',
compression 'snappy'
);
-- 插入单行数据
INSERT INTO test_table1 VALUES (1, 'lisi', 30, 'Male');
```
2. 登录[MRS管理控制台](https://console.huaweicloud.com/mrs/)。
3. 选择"现有集群",选中一个待操作的运行中的集群并单击集群名称,进入集群概览信息页面。
4. 在"概览"页签中,单击"IAM用户同步"右侧的"同步"进行IAM用户同步。
集群开启Kerberos认证时需执行该步骤,若集群未开启Kerberos认证,无需执行本步骤。
**IAM用户同步完成后,请等待5分钟,再进行提交作业,更多IAM用户同步说明请参考[IAM用户同步MRS集群说明](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0495.html)。**
5. 单击"作业管理",在作业列表界面单击"添加"。
6. "作业类型"选择"SparkSql"并参考[表1]配置SparkSql作业信息。
图1添加SparkSql作业

表1作业配置信息
| **参数** | **描述** | **示例** |
|:---|:---|:---|
| 作业名称 | 作业名称,只能由字母、数字、中划线和下划线组成,并且长度为1~64个字符。 | spark_sql_job |
| SQL类型 | SQL查询语句提交类型。 - SQL:直接运行手动输入的SQL语句。 - Script:以加载HDFS或者OBS中的SQL脚本文件运行SQL。 | Script |
| SQL语句 | "SQL类型"参数为"SQL"时参数有效,请输入待运行的SQL语句,然后单击"检查"来检查SQL语句的正确性,确保输入语句正确。 如果同时需要提交多条语句并执行,使用";"分隔不同语句。 | - |
| SQL文件 | "SQL类型"参数为"Script"时参数有效,待执行SQL文件的路径,可直接手动输入地址路径,也可单击"HDFS"或者"OBS"选择文件。 - 路径地址最多为1023字符,不能包含;\|\&\>,\<'$特殊字符,且不可为空或全空格。 - OBS程序路径地址以"obs://"开头,HDFS程序路径地址以"hdfs://hacluster"开头,例如"hdfs://hacluster/user/*XXX*.jar"。 - Script文件需要以".sql"结尾。 | obs://mrs-demotest/program/spark_basic.sql |
| 运行程序参数 | 可选参数,为本次执行的作业配置相关优化参数(例如线程、内存、CPU核数等),用于优化资源使用效率,提升作业的执行性能。 SparkSql作业常用的运行程序参数如[表2]所示,可根据执行程序及集群资源情况进行配置,若不配置将使用集群默认值。 | - |
| 服务配置参数 | 可选参数,用于为本次执行的作业修改服务配置参数。 该参数的修改仅适用于本次执行的作业,如需对集群永久生效,请参考[修改MRS集群组件配置参数](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0204.html)进行集群组件配置参数的修改。 例如在MRS集群未配置存算分离的场景下,作业需要通过AK/SK方式访问OBS,可增加以下服务配置参数: - fs.obs.access.key:访问OBS的密钥ID。 - fs.obs.secret.key:访问OBS与密钥ID对应的密钥。 | - |
| 命令参考 | 用于展示提交作业时提交到后台执行的命令。 | N/A |
表2运行程序参数
| **参数** | **描述** | **示例** |
|:---|:---|:---|
| --conf | 添加Spark任务的配置,格式为"*property* =*value*"。 更多关于Spark作业提交参数的介绍,可参考。 | spark.executor.memory=2G |
| --driver-memory | 设置Spark任务中为Driver分配的运行内存大小。 例如内存分配为2 GB,本参数可配置为2g;内存分配为512 MB,本参数可配置为512m。 | 2g |
| --num-executors | 设置Spark任务中启动的Executor数量。 | 5 |
| --executor-cores | 设置Spark任务中,为每个Executor分配的CPU核心数。 | 2 |
| --executor-memory | 设置Spark任务中,为每个Executor分配的内存大小。 例如内存分配为2 GB,本参数可配置为2g;内存分配为512 MB,本参数可配置为512m。 | 2g |
| --jars | 上传任务额外依赖包,用于给任务添加任务的外部依赖包。 | - |
7. 确认作业配置信息,单击"确定",完成作业的新增。
8. 作业提交成功中,可在作业列表中查看作业运行状态及执行结果,等待作业状态变为"已完成",可查看相关程序分析结果。
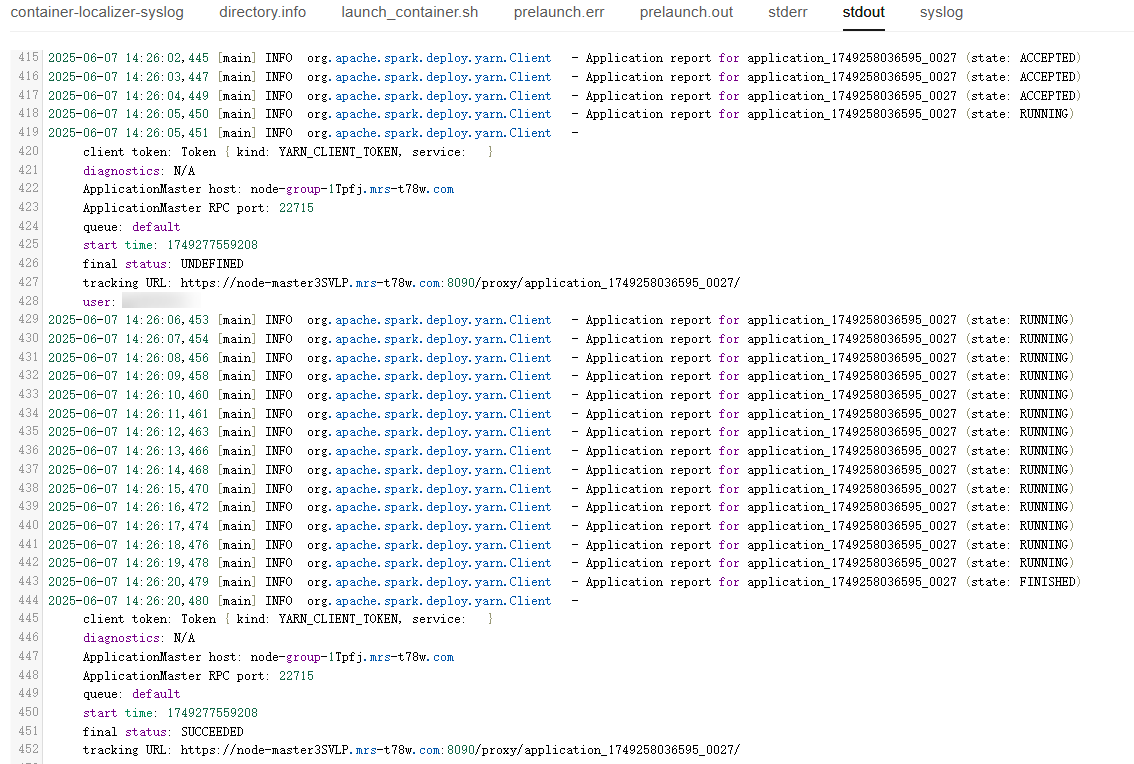
在本示例程序中,单击"查看日志",可查看SparkSql作业的详细执行过程。
图2查看作业执行详情
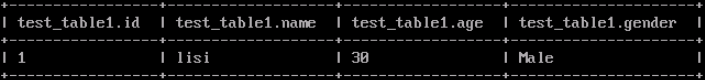
作业运行成功后,通过客户端连接Hive Beeline,可查看相关的Hive表数据。
1. 如果当前集群已开启Kerberos认证,需提前在Manager界面中创建一个具有对应作业提交权限的业务用户,请参考[创建MRS集群用户](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0345.html)。
本示例中,创建一个人机用户testuser,关联用户组"supergroup"及角色"System_administrator"。
2. 安装MRS集群客户端。 具体操作可参考[安装MRS集群客户端](https://support.huaweicloud.com/usermanual-mrs/mrs_01_24212.html)。
MRS集群中默认安装了一个客户端用于作业提交,也可直接使用该客户端。MRS 3.x及之后版本客户端默认安装路径为Master节点上的"/opt/Bigdata/client",MRS 3.x之前版本为Master节点上的"/opt/client"。
3. 执行以下命令进入客户端安装目录。
```
cd /opt/Bigdata/client
```
加载环境变量:
```
source bigdata_env
```
如果当前集群已开启Kerberos认证,执行以下命令进行用户认证,如果当前集群未开启Kerberos认证,则无需执行kinit操作。
```
kinit testuser
```
4. 进入Hive Beeline并查看生成的数据。
```
beeline
```
查看生成的Hive表数据。
```
select * from test_table1;
```
图3查看Hive表数据
- [通过集群客户端提交作业]
1. 开发SQL脚本。
SparkSql作业可以直接执行SQL语句,也可以指定执行开发好的SQL脚本文件。
在本章节示例中,以在Spark中创建Hive数据表并插入数据的脚本为例,将开发好的脚本"spark_basic.sql"文件上传至HDFS、OBS或者MRS集群节点本地的指定目录中,请参考[上传应用数据至MRS集群](https://support.huaweicloud.com/usermanual-mrs/zh-cn_topic_0019489057.html)。
```
-- 创建表
CREATE TABLE IF NOT EXISTS test_table1 (
id INT,
name STRING,
age INT,
gender STRING
)
USING parquet
OPTIONS (
path '/user/hive/warehouse/test_table1',
compression 'snappy'
);
-- 插入单行数据
INSERT INTO test_table1 VALUES (1, 'lisi', 30, 'Male');
```
2. 如果当前集群已开启Kerberos认证,需提前在Manager界面中创建一个具有对应作业提交权限的业务用户,请参考[创建MRS集群用户](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0345.html)。
本示例中,创建一个人机用户testuser,关联用户组"supergroup"及角色"System_administrator"。
3. 安装MRS集群客户端。
具体操作可参考[安装MRS集群客户端](https://support.huaweicloud.com/usermanual-mrs/mrs_01_24212.html)。
MRS集群中默认安装了一个客户端用于作业提交,也可直接使用该客户端。MRS 3.x及之后版本客户端默认安装路径为Master节点上的"/opt/Bigdata/client",MRS 3.x之前版本为Master节点上的"/opt/client"。
4. 使用MRS集群客户端安装用户登录客户端所在的节点。
具体操作可参考[登录MRS集群节点](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0083.html)。
5. 执行以下命令进入客户端安装目录。
```
cd /opt/Bigdata/client
```
加载环境变量:
```
source bigdata_env
```
如果当前集群已开启Kerberos认证,执行以下命令进行用户认证,如果当前集群未开启Kerberos认证,则无需执行kinit操作。
```
kinit testuser
```
6. 执行以下命令进入Spark组件目录。
```
cd $SPARK_HOME
```
7. 通过spark-sql命令执行SQL脚本。
```
./bin/spark-sql -f /opt/spark_basic.sql
```
也可以执行**spark-sql**命令后,直接执行SQL语句。
```
spark-sql
```
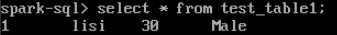
脚本执行完成后,可查看生成的Hive表数据。
```
select * from test_table1;
```
图4查看表数据
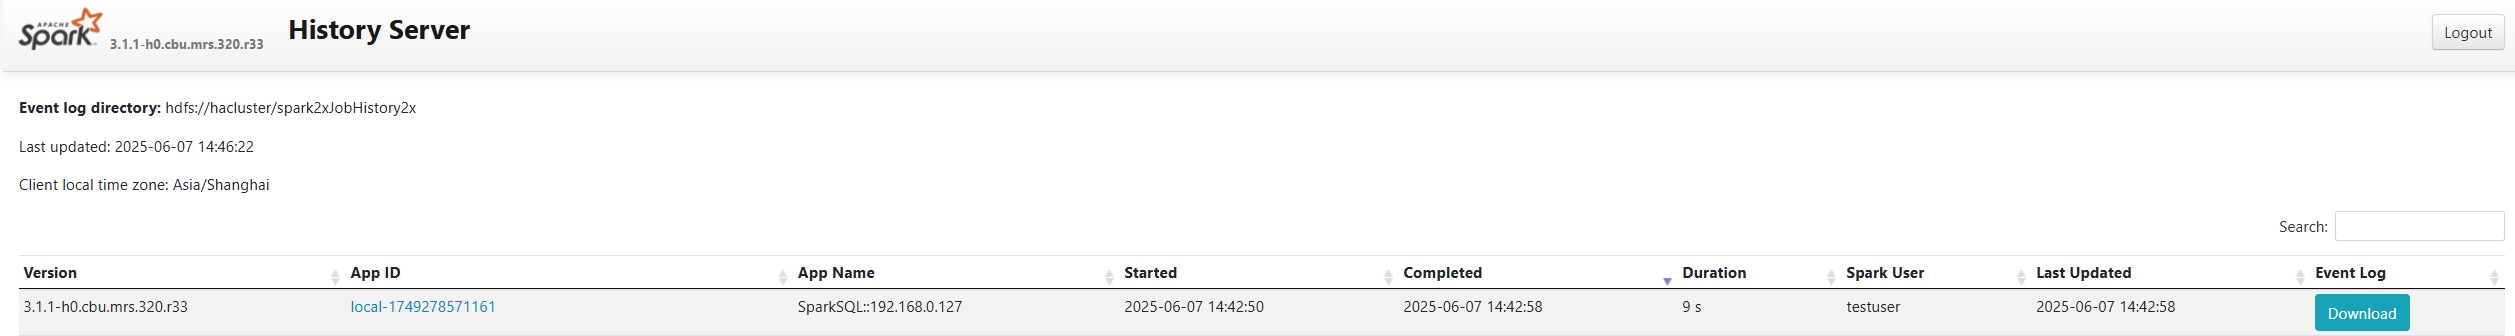
8. 使用testuser用户登录集群Manager页面,选择"集群 \> 服务 \> Spark/Spark2x",单击"Spark WebUI"右侧的超链接进入Spark WebUI页面,可查看Spark作业相关运行情况及Event日志。
图5查看Spark作业详情
#### 相关文档
- 作业添加成功后,不支持进行编辑修改,如果需要再次执行作业,可选择"克隆"快速复制一个已创建的作业并进行参数调整,具体操作请参考[克隆MRS集群作业](https://support.huaweicloud.com/usermanual-mrs/mrs_01_249004.html)。
- Spark作业的Client模式和Cluster模式区别说明请参见[Spark作业的Client模式和Cluster模式有什么区别?](https://support.huaweicloud.com/mrs_faq/mrs_03_1184.html)。
- 开启Kerberos认证的集群在提交作业时,未进行IAM用户同步报错处理方法请参见[提交作业时系统提示当前用户在Manager不存在如何处理?](https://support.huaweicloud.com/mrs_faq/mrs_03_1173.html)。
- 更多Spark作业运行失败故障案例处理方法请参见[作业管理类常见问题](https://support.huaweicloud.com/mrs_faq/mrs_03_2030.html)和[Spark故障排除](https://support.huaweicloud.com/trouble-mrs/mrs_03_0244.html)。
- 如需通过API方式新增并执行作业,具体操作请参见[新增并执行作业](https://support.huaweicloud.com/api-mrs/CreateExecuteJob.html)。
- 更多MRS应用开发样例程序,请参见[MRS应用开发指南](https://support.huaweicloud.com/devg-lts-mrs/mrs_07_010000.html)。