# 在Spark SQL作业中使用UDTF
#### 操作场景
AI DataLake支持用户使用Hive UDTF(User-Defined Table-Generating Functions)自定义表值函数,UDTF用于解决一进多出业务场景,即其输入与输出是一对多的关系,读入一行数据,输出多个值。
#### 约束限制
自定义函数中引用static类或接口时,必须要加上"try catch"异常捕获,否则可能会造成包冲突,导致函数功能异常。
#### 环境准备
在进行UDTF开发前,请准备以下开发环境。
表1UDTF开发环境
| 准备项 | 说明 |
|:---|:---|
| 操作系统 | Windows系统,支持Windows7以上版本。 |
| 安装JDK | JDK使用21及以上版本。 |
| 安装和配置IntelliJ IDEA | IntelliJ IDEA为进行应用开发的工具,版本要求使用2019.1或其他兼容版本。 |
| 安装Maven | 开发环境的基本配置。用于项目管理,贯穿软件开发生命周期。 |
#### 开发流程
UDTF函数开发流程参考如下:
图1UDTF开发流程
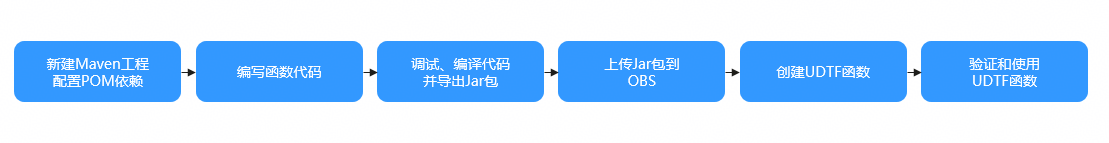
表2开发流程说明
| 序号 | 阶段 | 操作界面 | 说明 |
|:---|:---|:---|:---|
| 1 | 新建Maven工程,配置pom文件 | IntelliJ IDEA | 参考[操作步骤]说明,编写UDTF函数代码。 |
| 2 | 编写UDTF函数代码 | IntelliJ IDEA | 参考[操作步骤]说明,编写UDTF函数代码。 |
| 3 | 调试,编译代码并导出Jar包 | IntelliJ IDEA | 参考[操作步骤]说明,编写UDTF函数代码。 |
| 4 | 上传Jar包到OBS | OBS控制台 | 将生成的UDTF函数Jar包文件上传到OBS目录下。 |
| 5 | 创建UDTF函数 | DataArts Studio控制台 | 在DataArts Studio控制台的"脚本开发"界面,创建UDTF函数。 |
| 6 | 验证和使用UDTF函数 | DataArts Studio控制台 | 在DataArts Studio控制台的"脚本开发"界面,Spark SQL作业中使用创建的UDTF函数。 |
#### 操作步骤
1. 新建Maven工程,配置pom文件。以下通过IntelliJ IDEA 2020.2工具操作演示。
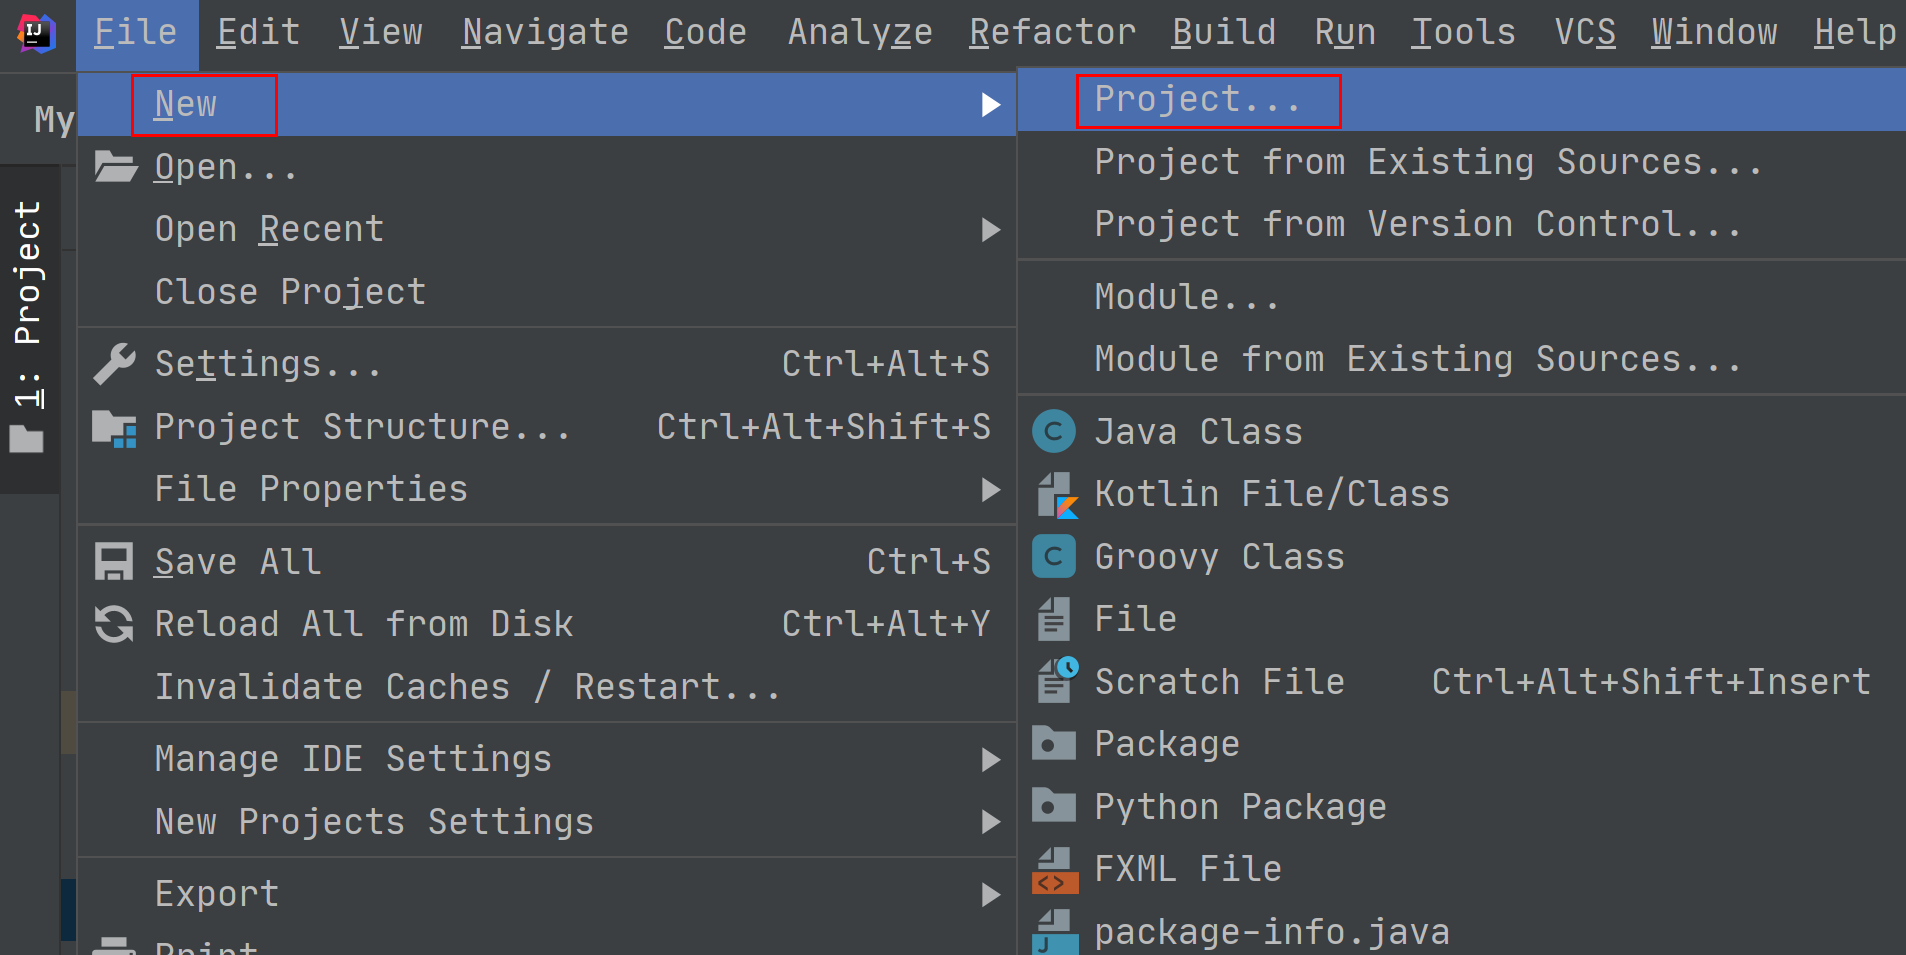
1. 打开IntelliJ IDEA,选择"File \> New \> Project"。
图2新建Project
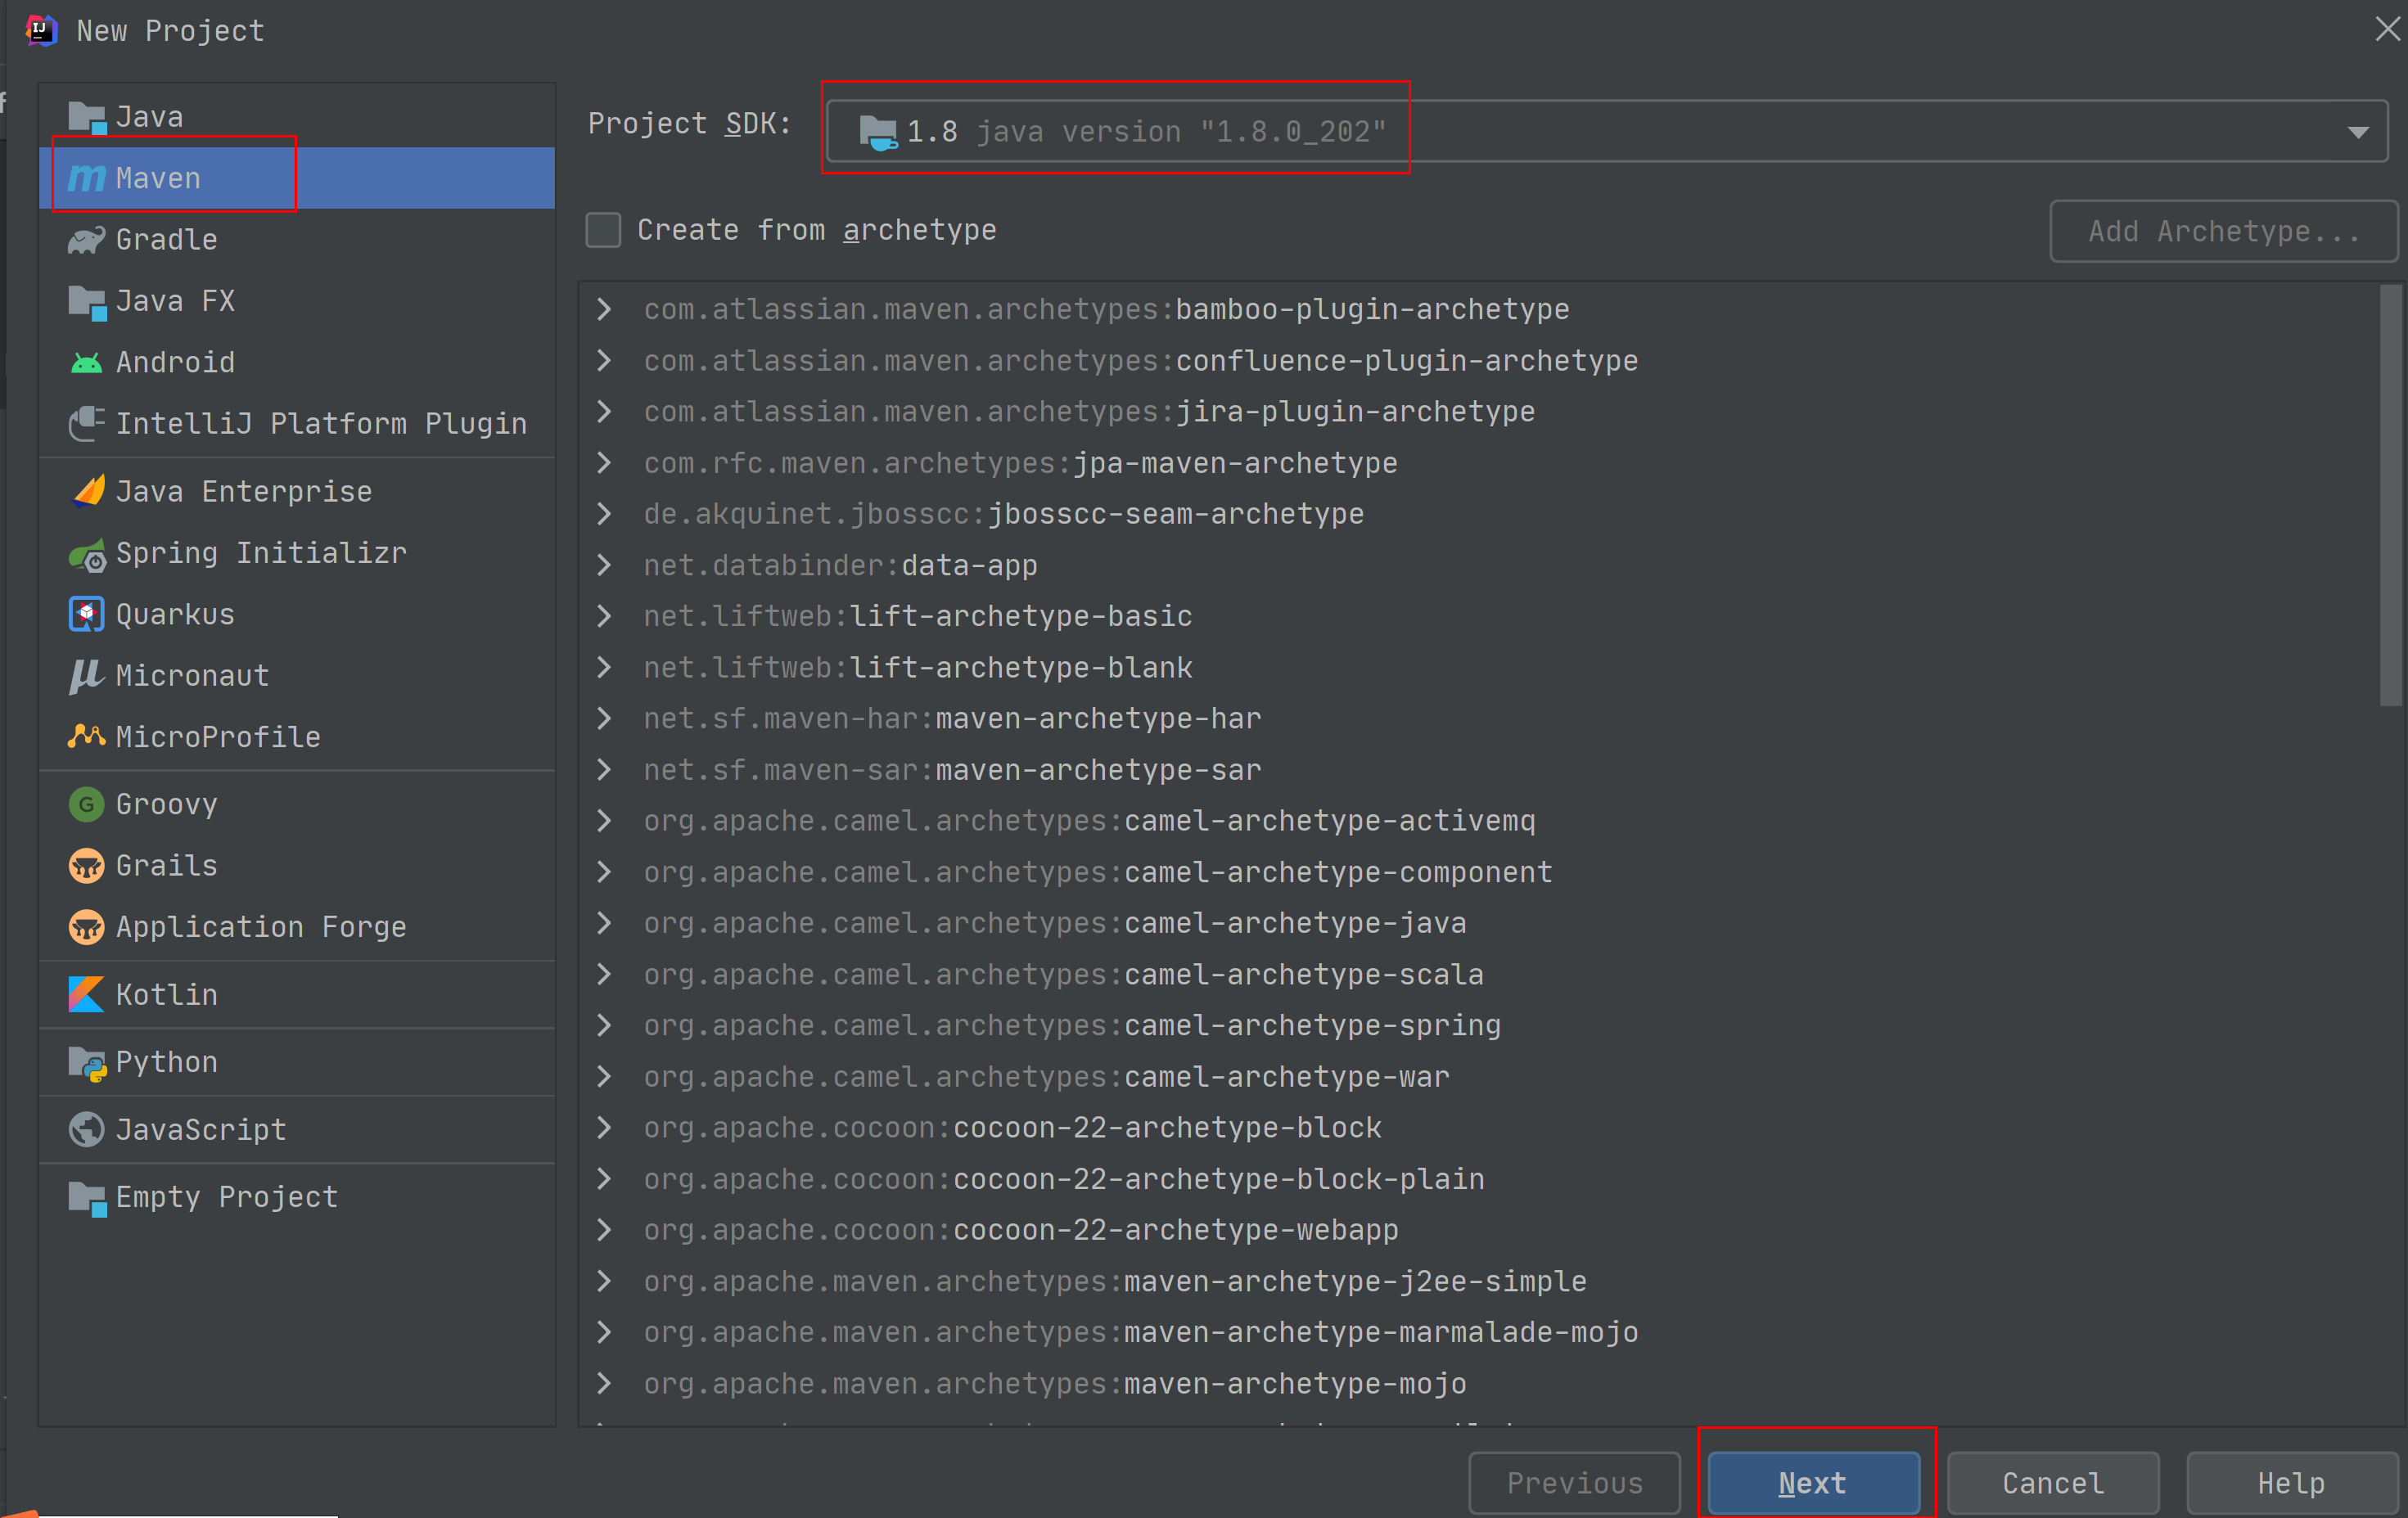
2. 选择Maven,Project SDK选择1.8,单击"Next"。
图3选择Maven
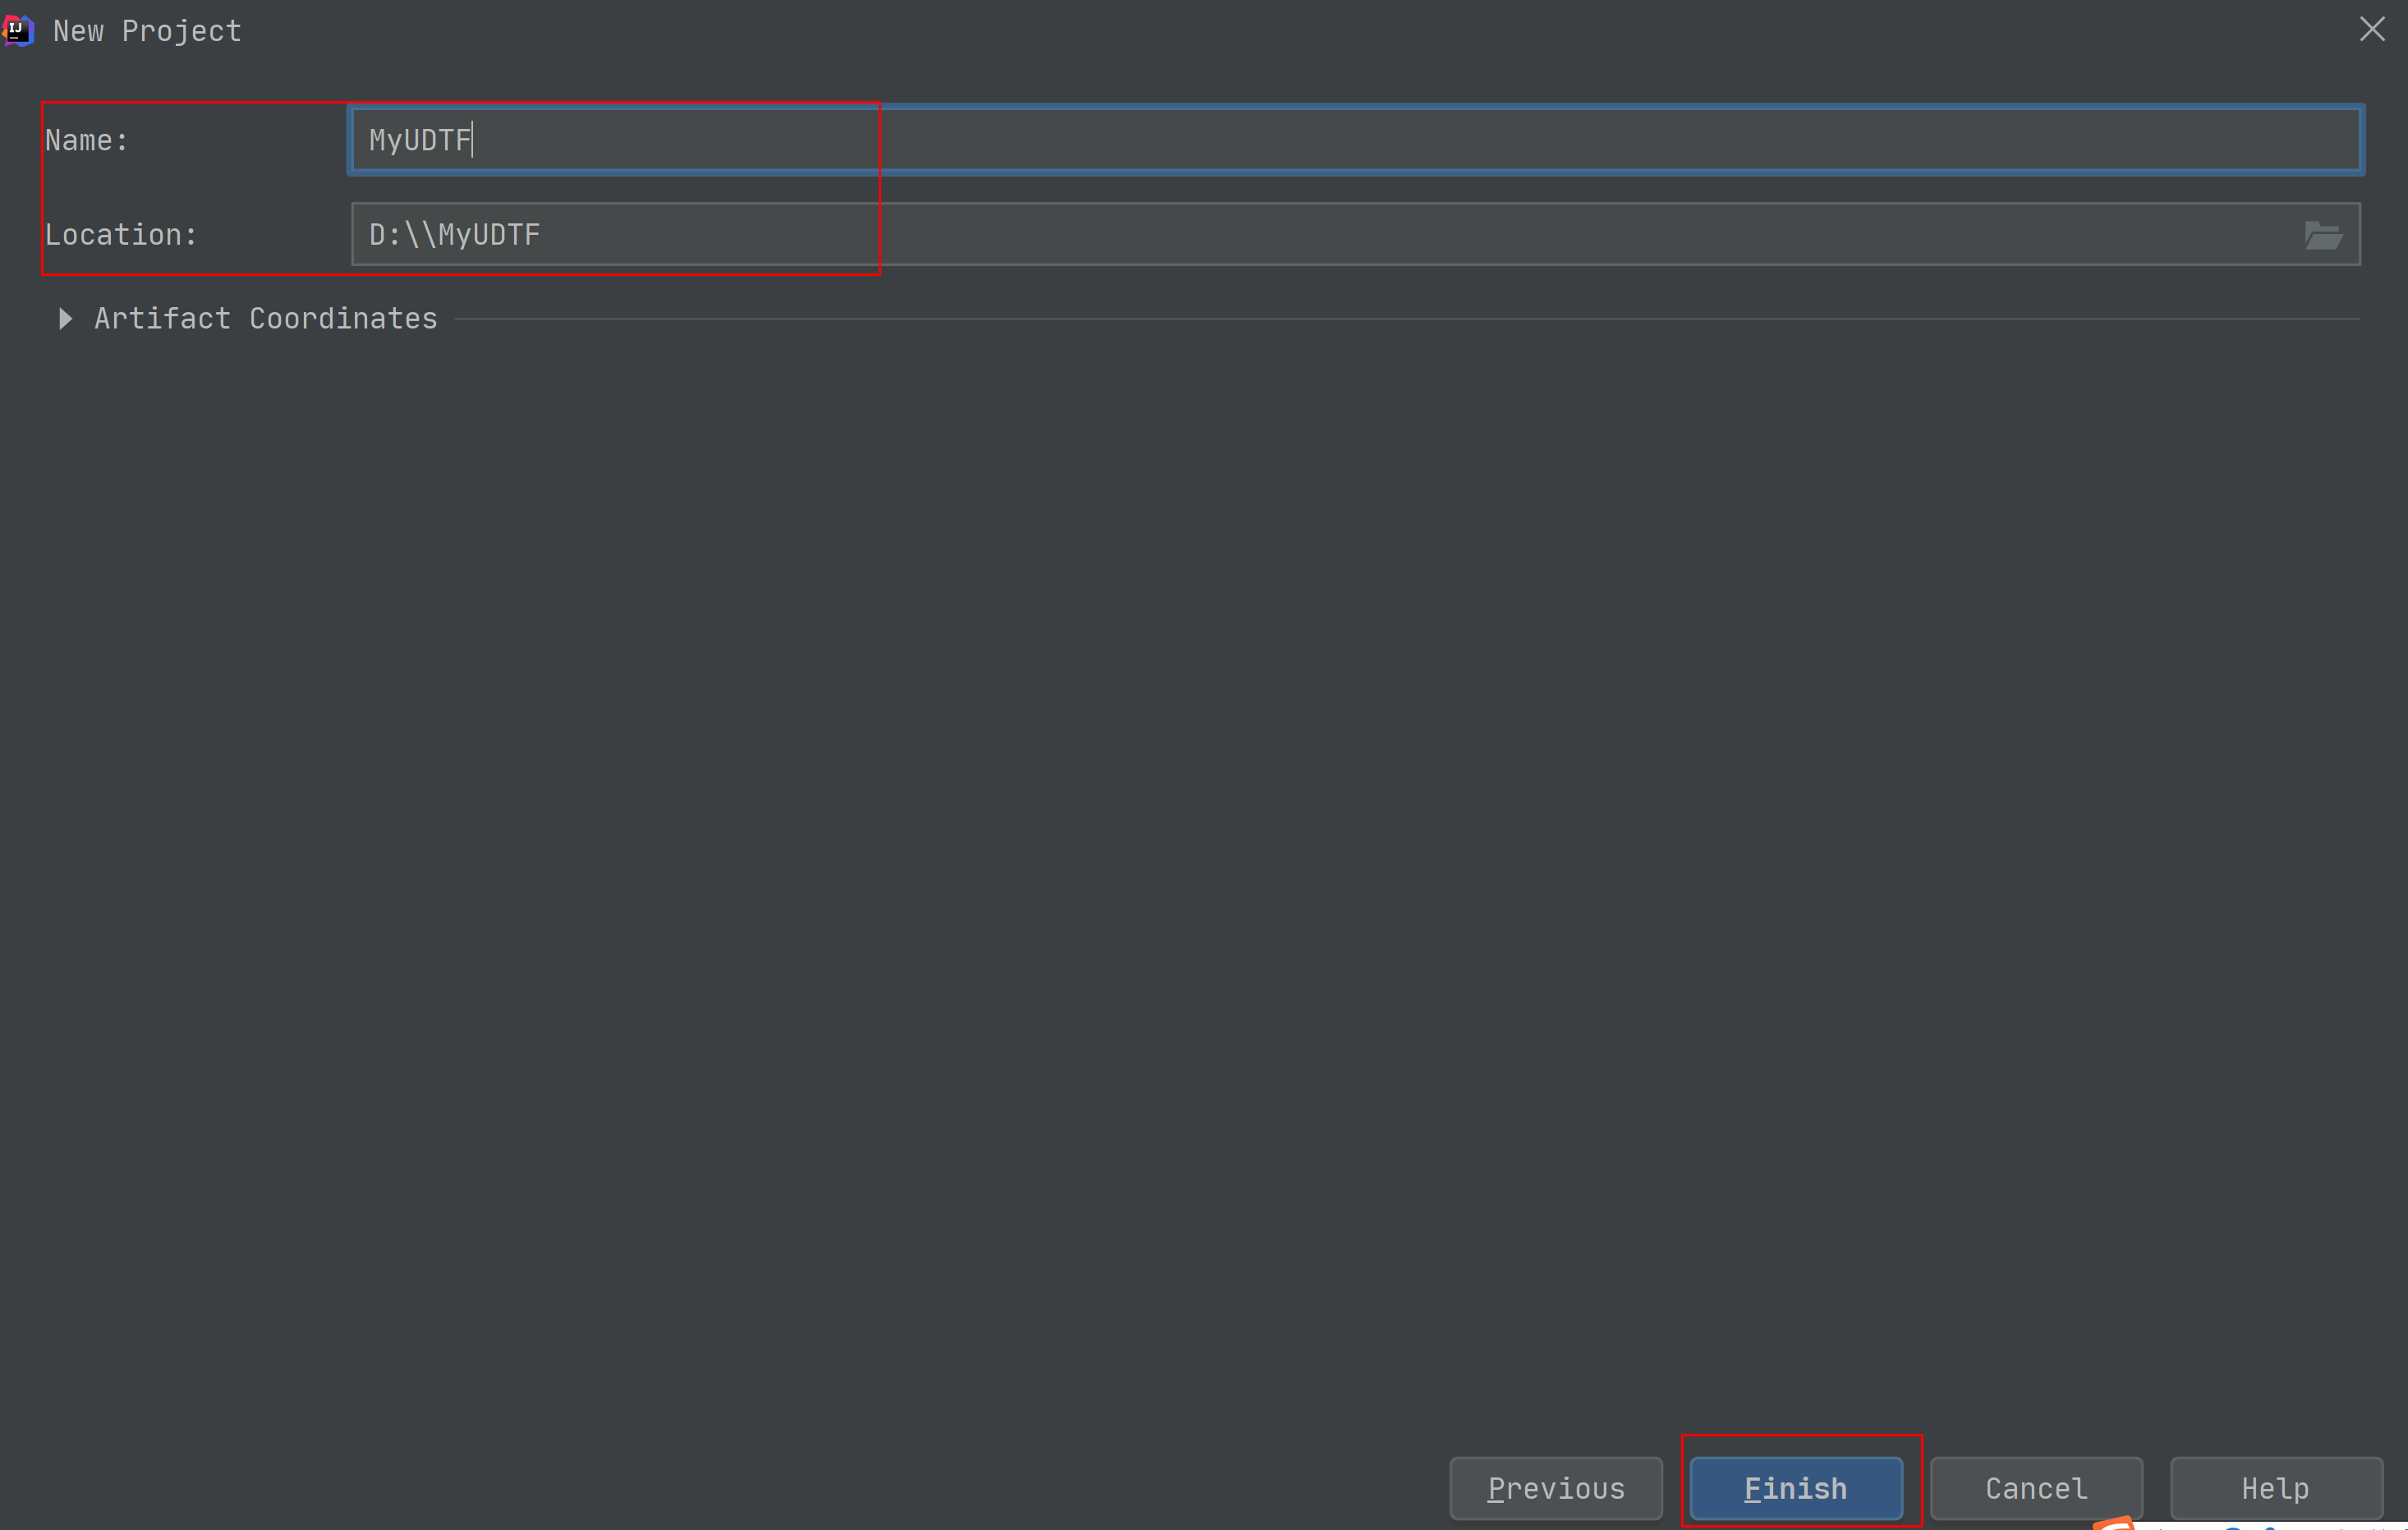
3. 定义样例工程名和配置样例工程存储路径,单击"Finish"完成工程创建。
图4创建工程
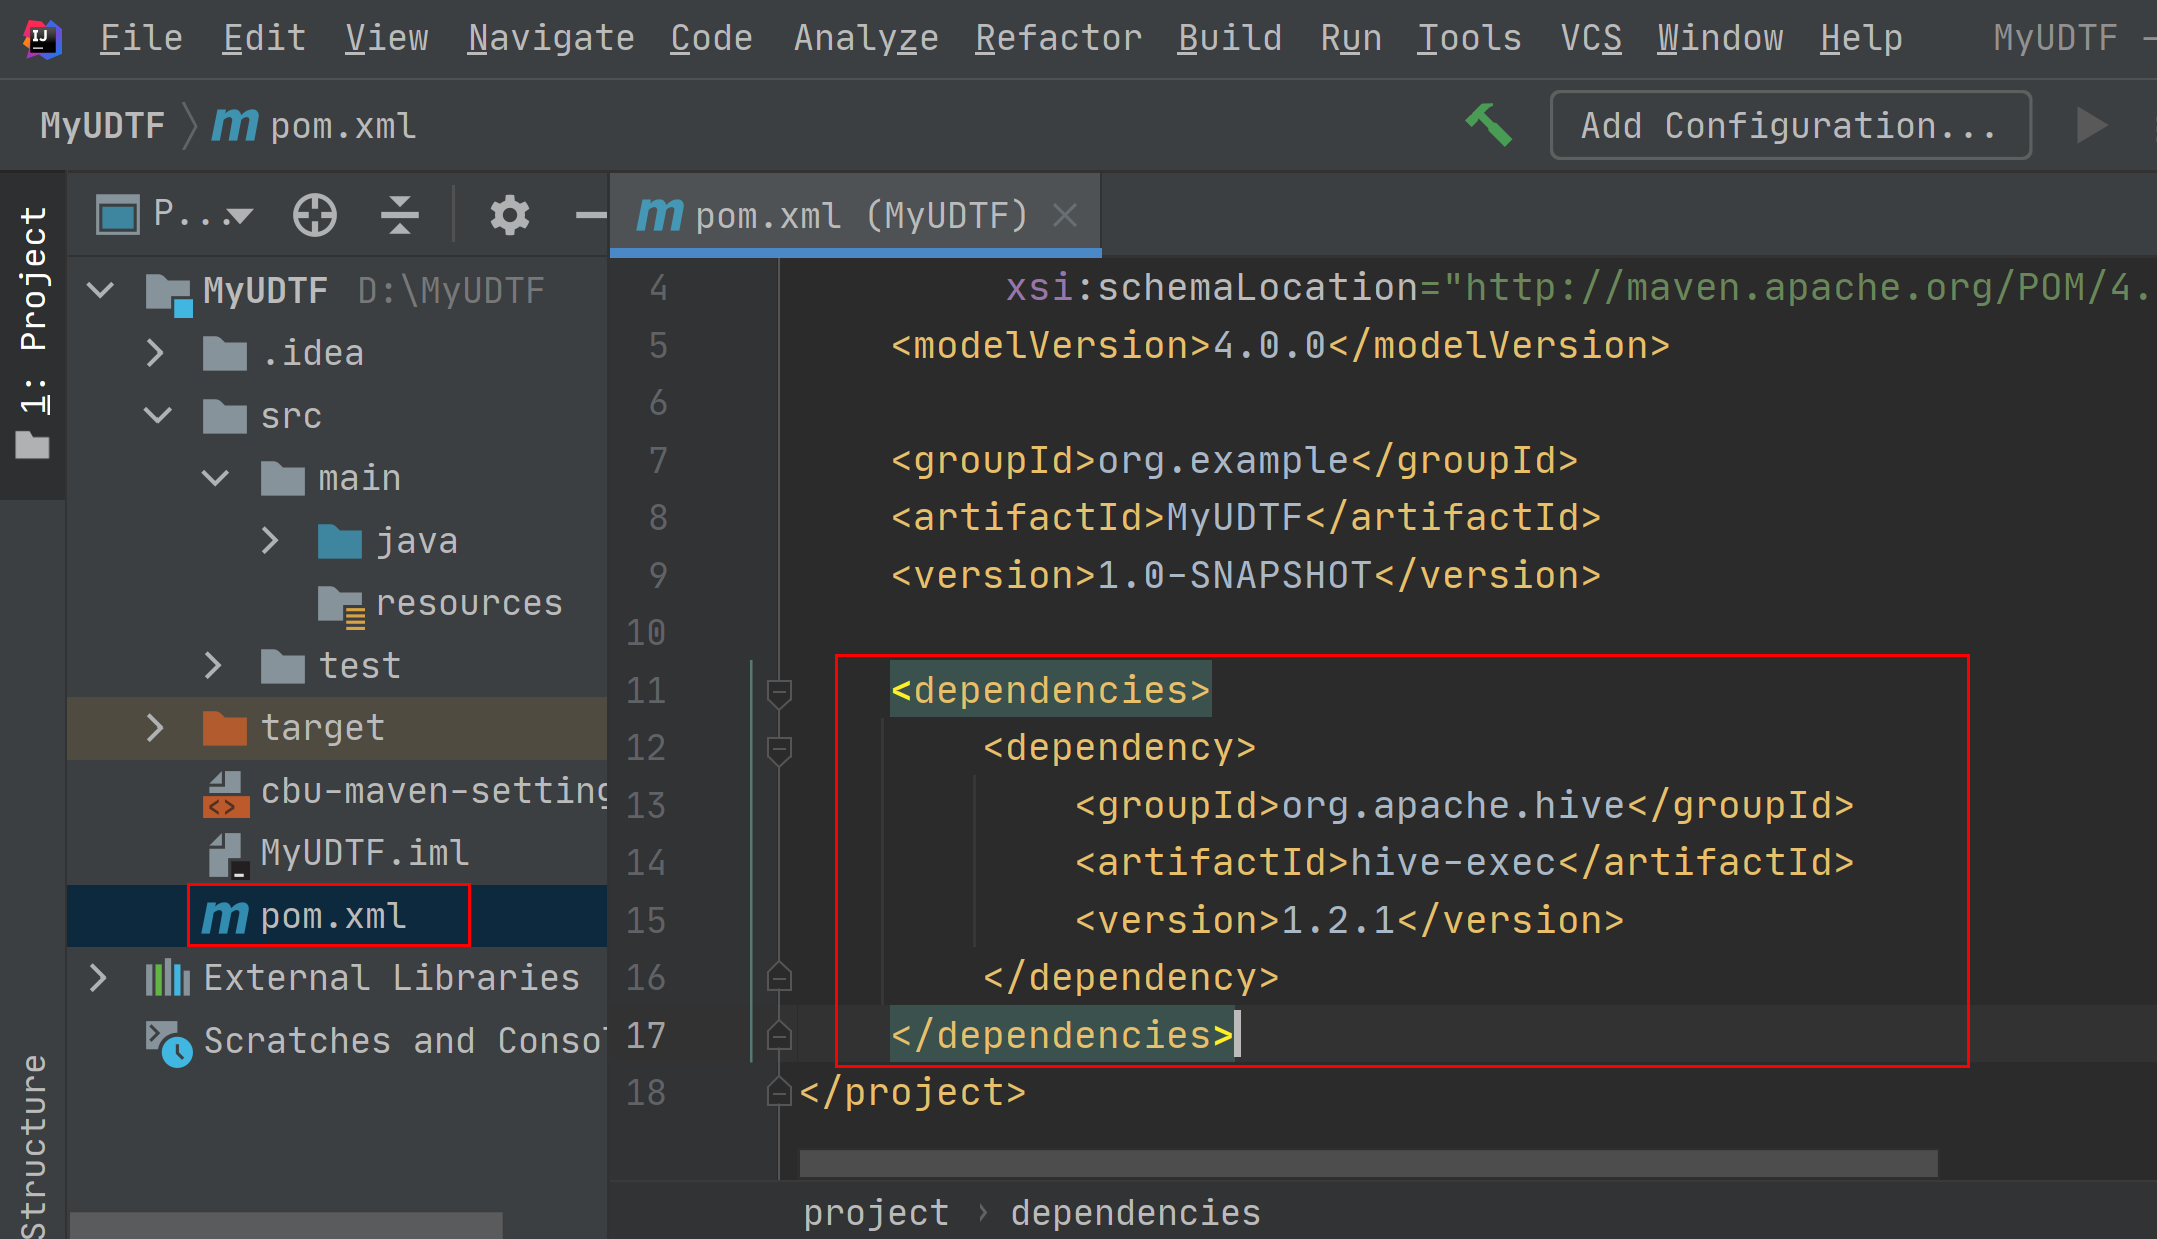
4. 在pom.xml文件中添加如下配置。
```
org.apache.hive
hive-exec
1.2.1
```
图5pom文件中添加配置
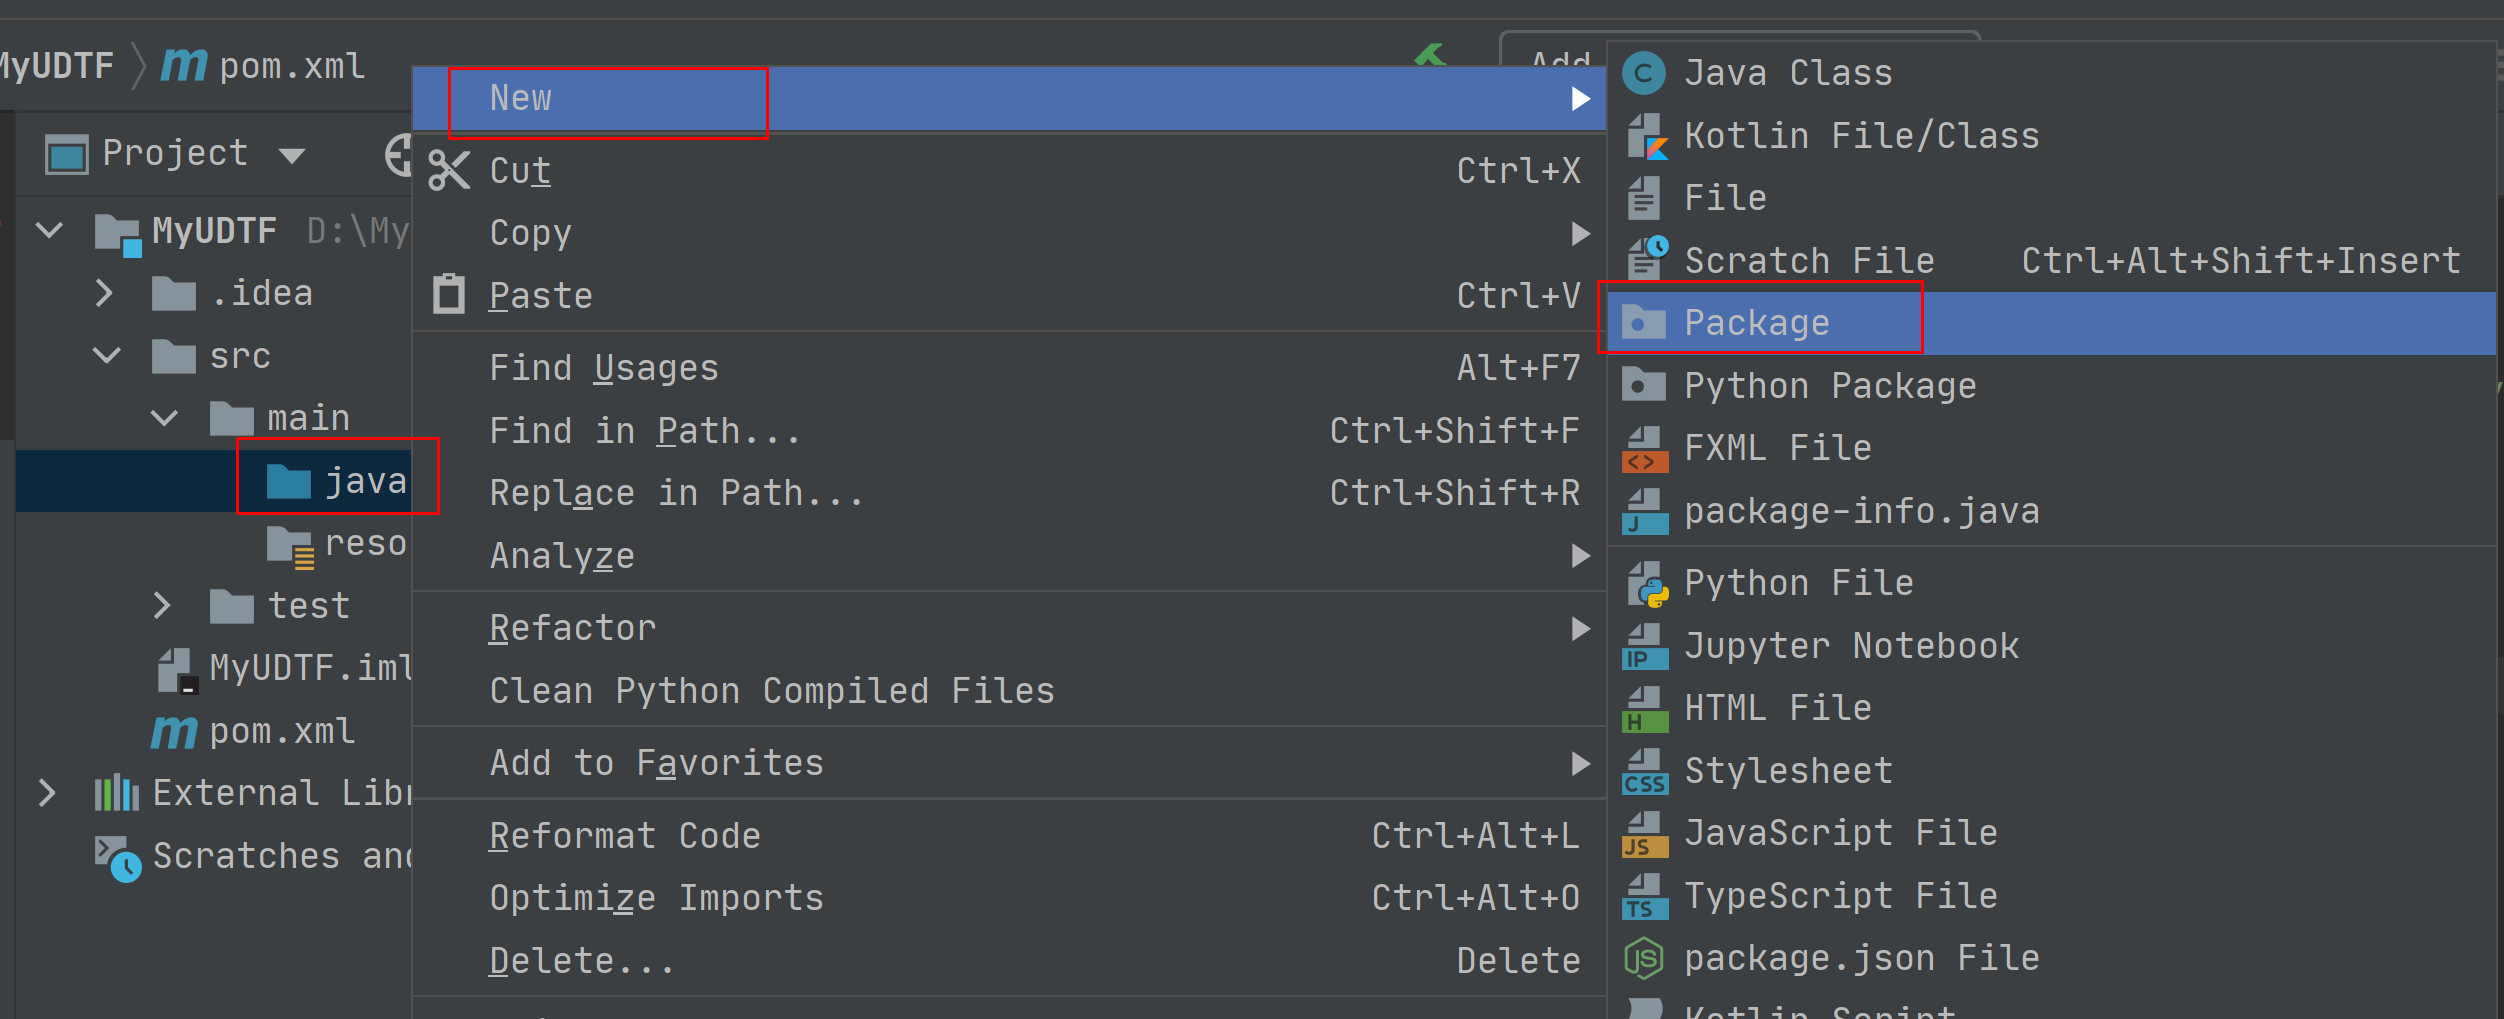
5. 在工程路径的"src \> main \> java"文件夹上鼠标右键,选择"New \> Package",新建Package和类文件。
图6新建Package和类文件
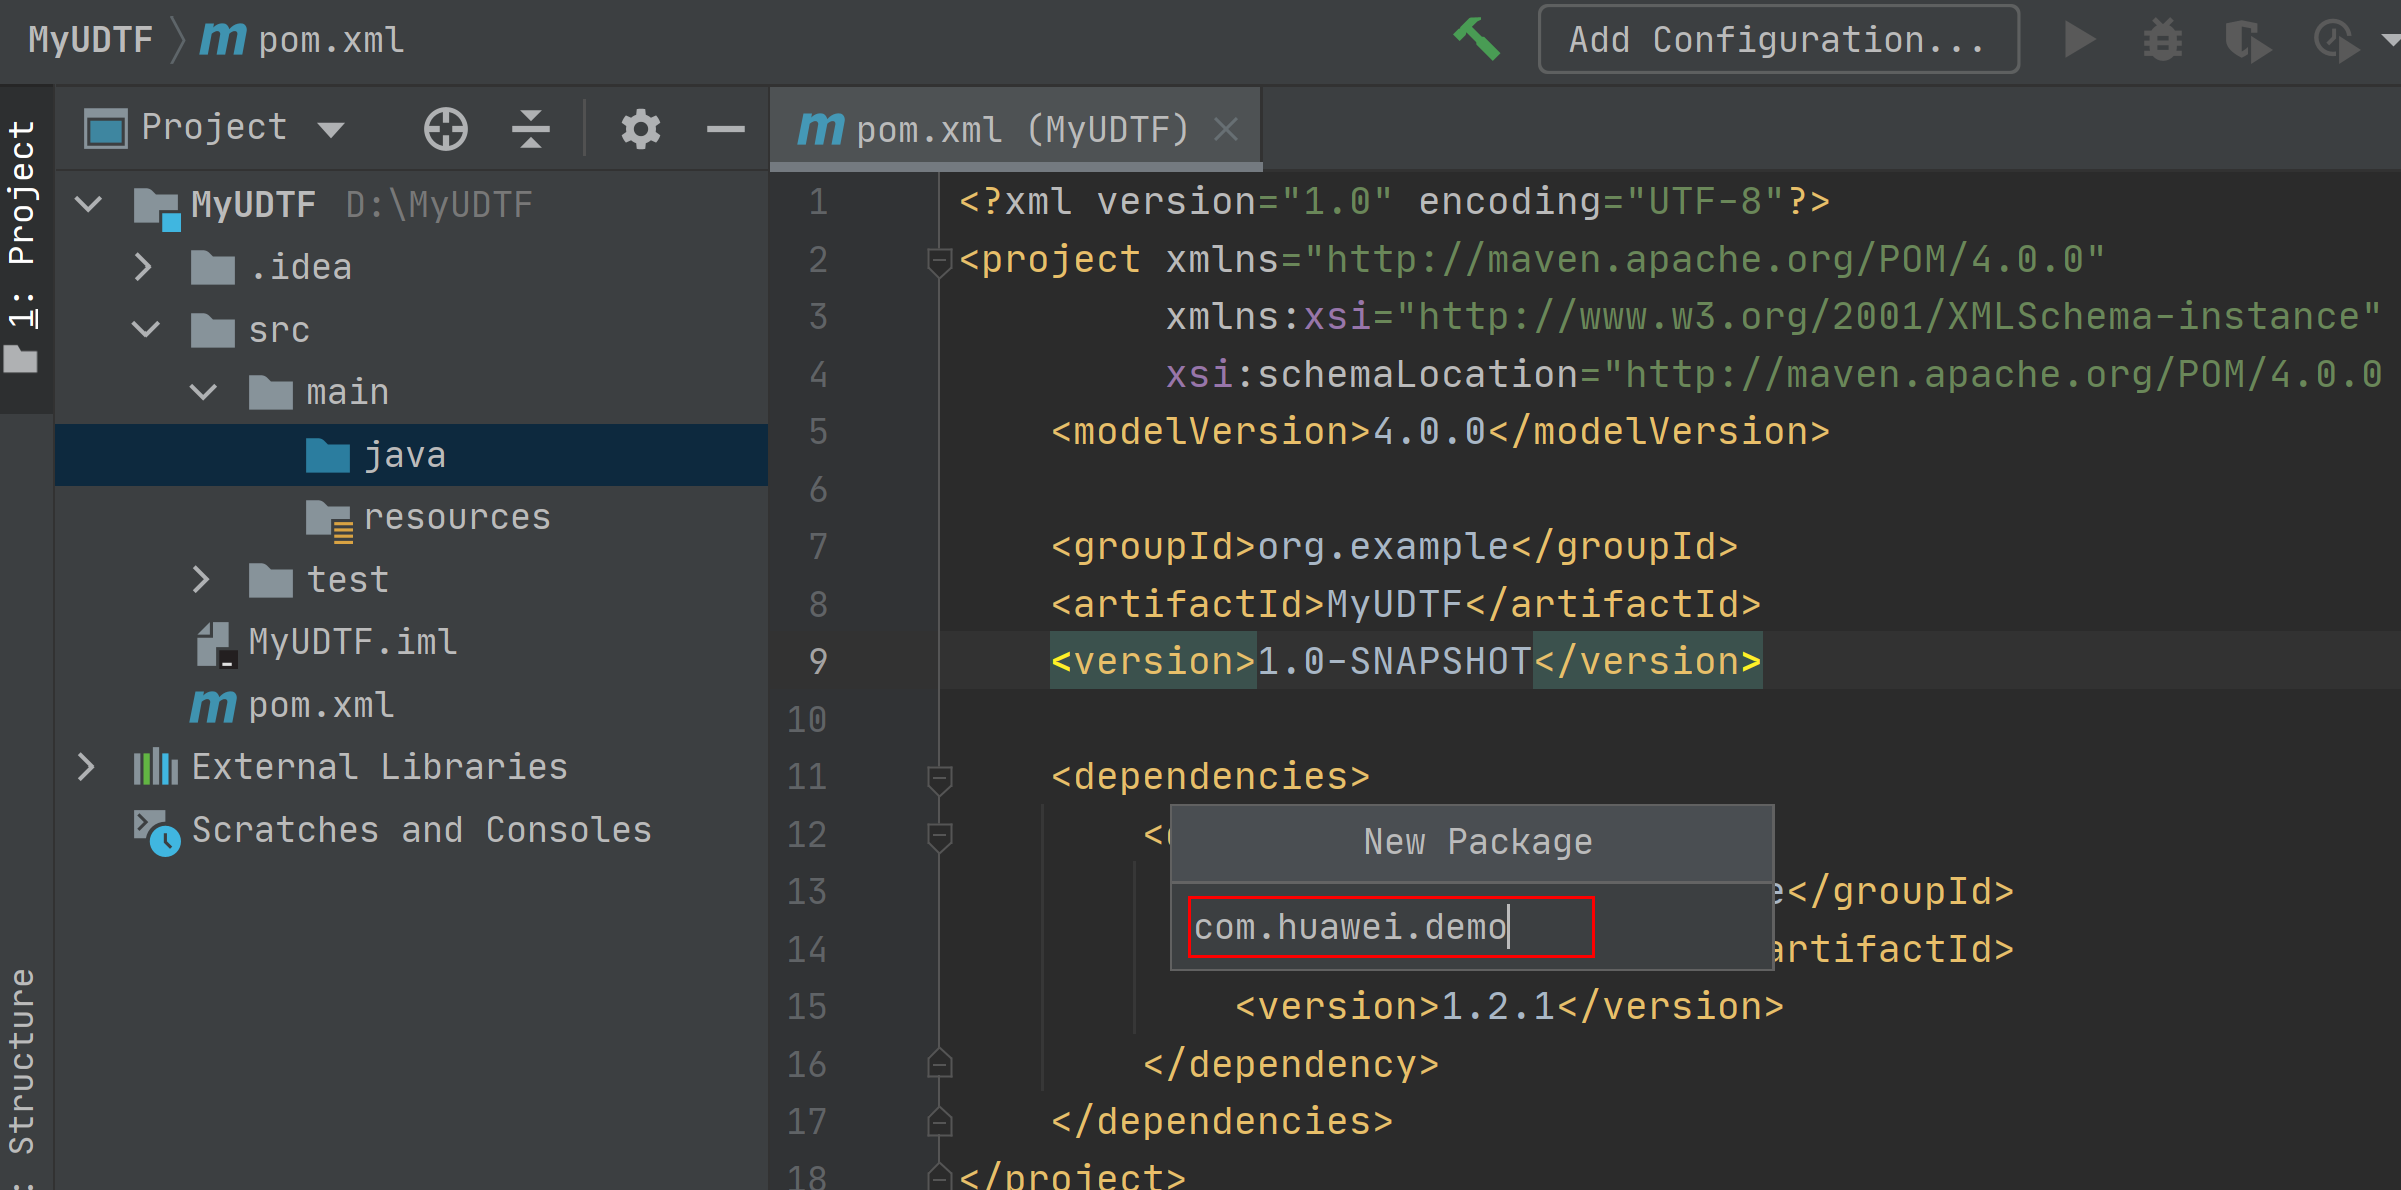
Package根据需要定义,本示例定义为:"com.huawei.demo",完成后回车。
图7自定义Package
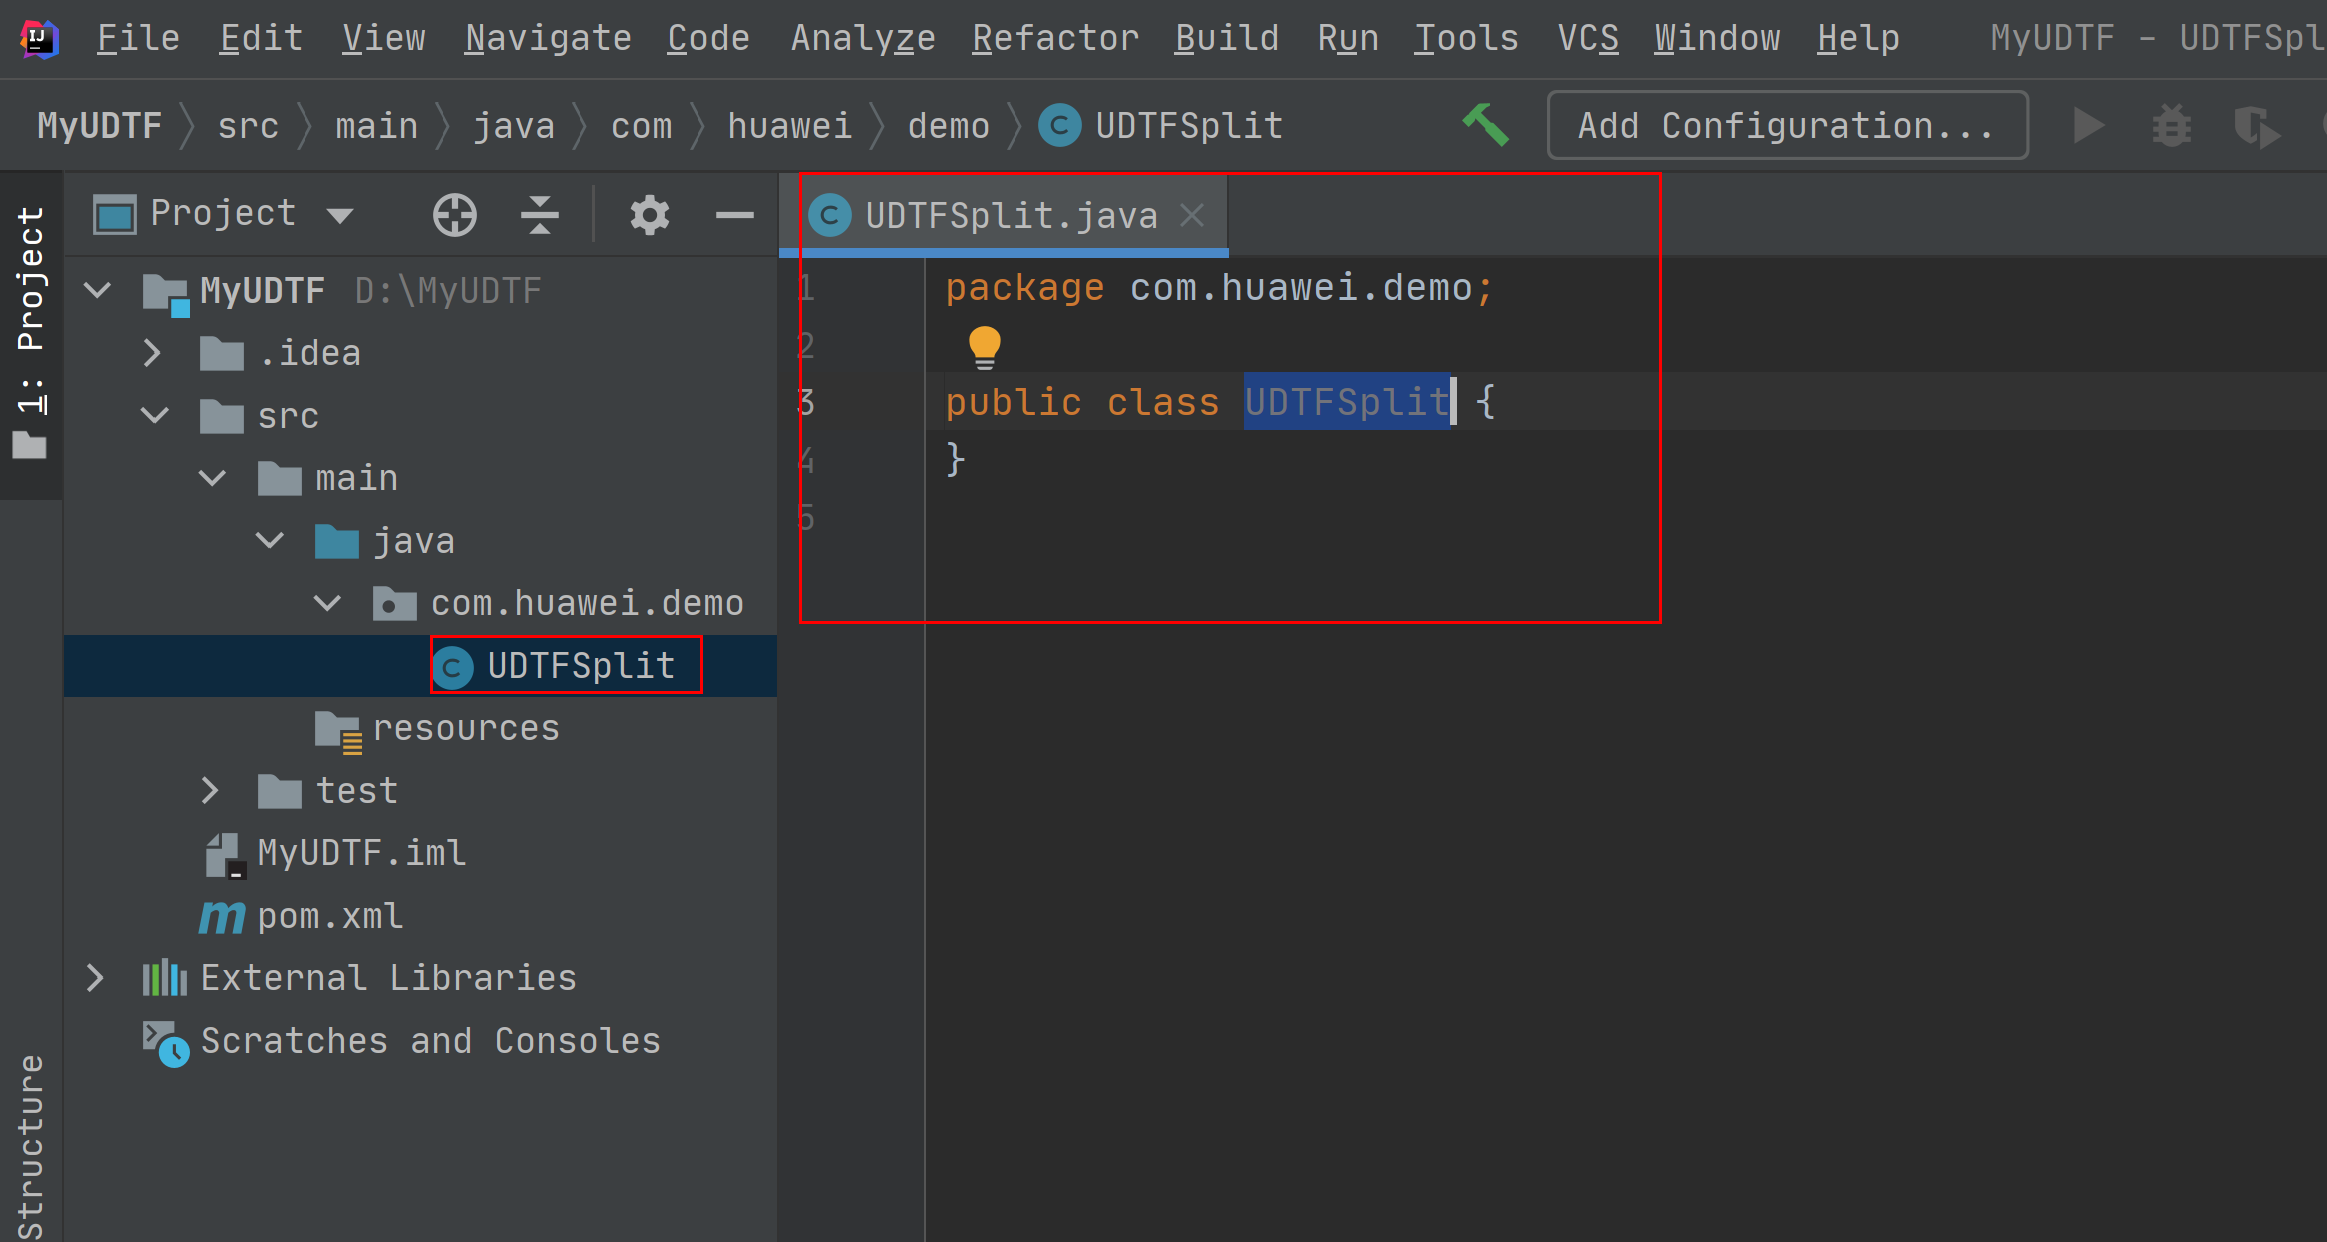
在包路径下新建Java Class文件,本示例定义为:UDTFSplit。
图8新建Java Class文件
2. 编写UDTF函数代码。完整样例代码请参考[样例代码]。
UDTF的类需要继承"org.apache.hadoop.hive.ql.udf.generic.GenericUDTF",实现initialize,process,close三个方法。
1. UDTF首先会调用initialize方法,此方法返回UDTF的返回行的信息,如,返回个数,类型等。
2. 初始化完成后,会调用process方法,真正处理在process函数中,在process中,每一次forward()调用产生一行。
如果产生多列可以将多个列的值放在一个数组中,然后将该数组传入到forward()函数。
```
public void process(Object[] args) throws HiveException {
// TODO Auto-generated method stub
if(args.length == 0){
return;
}
String input = args[0].toString();
if(StringUtils.isEmpty(input)){
return;
}
String[] test = input.split(";");
for (int i = 0; i < test.length; i++) {
try {
String[] result = test[i].split(":");
forward(result);
} catch (Exception e) {
continue;
}
}
}
```
3. 最后调用close方法,对需要清理的方法进行清理。
3. 编写调试完成代码后,通过IntelliJ IDEA工具编译代码并导出Jar包。
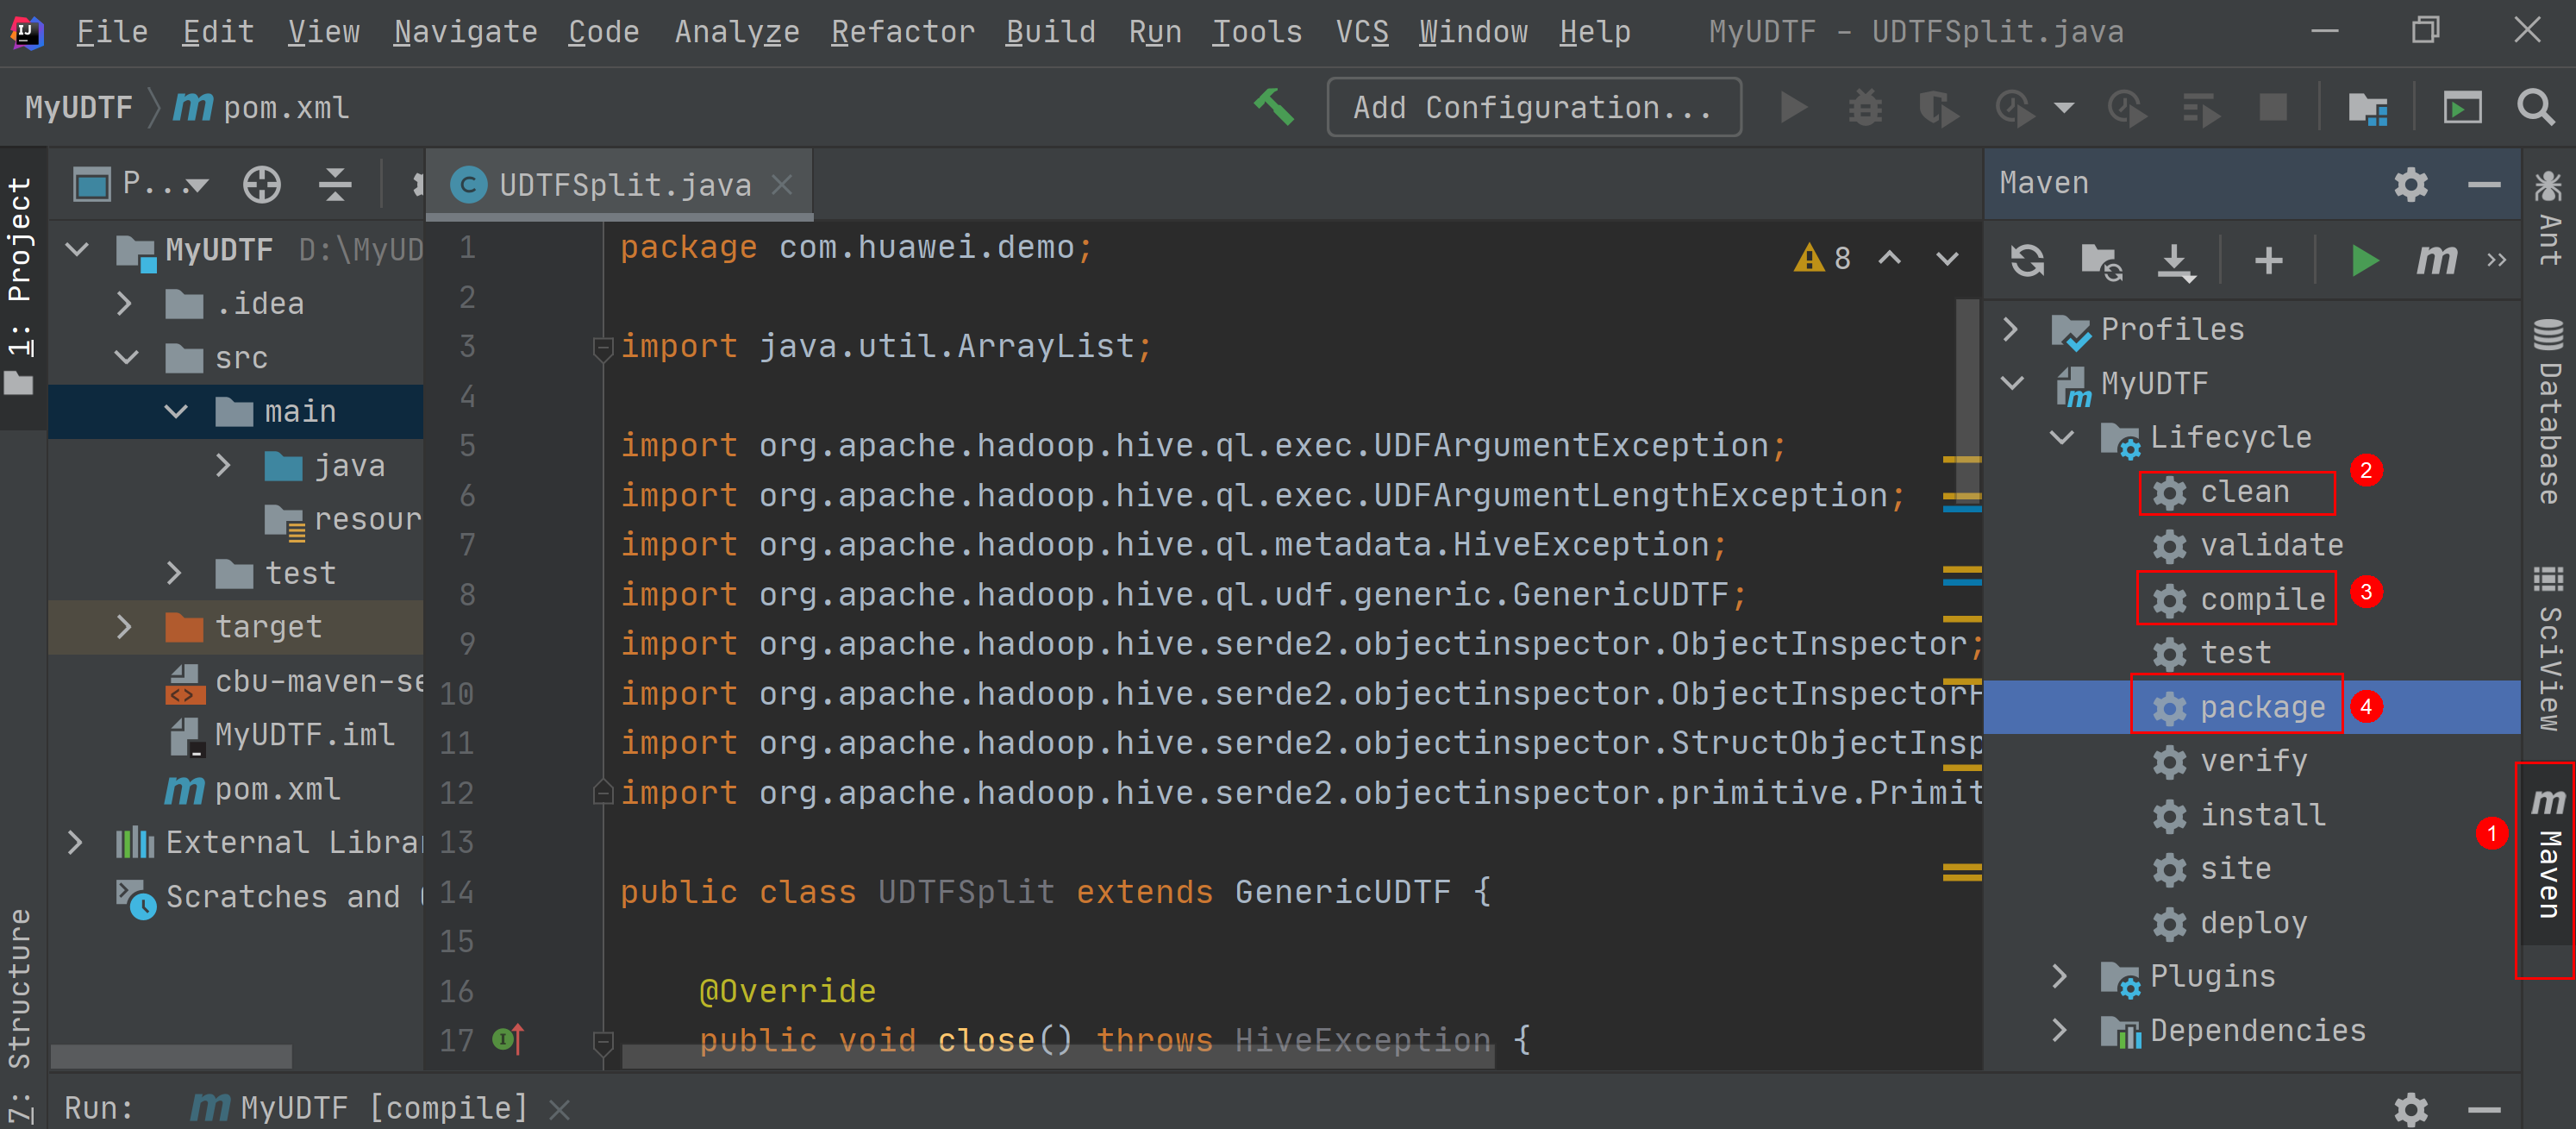
1. 单击工具右侧的"Maven",参考下图分别单击"clean"、"compile"对代码进行编译。
编译成功后,单击"package"对代码进行打包。
图9编译打包
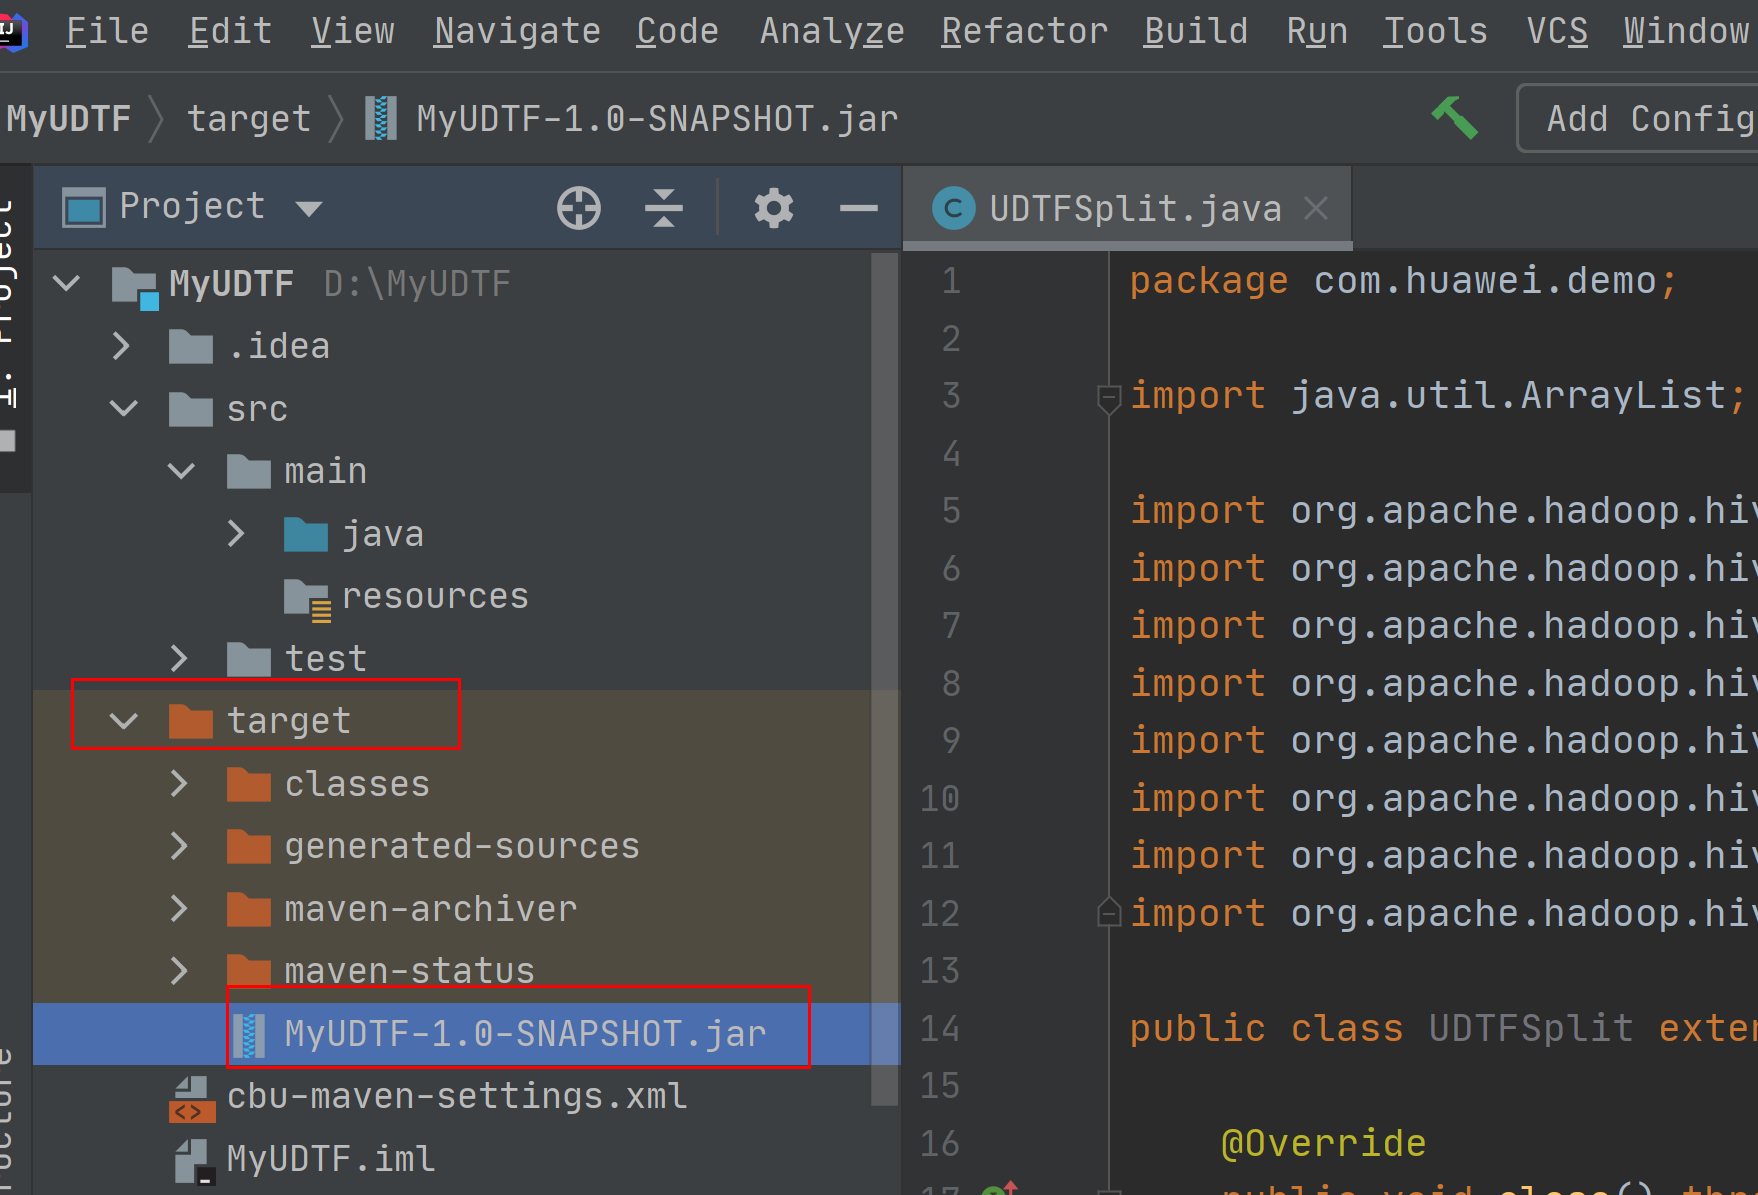
打包成功后,生成的Jar包会放到target目录下,以备后用。本示例将会生成到:"D:\\MyUDTF\\target"下名为"MyUDTF-1.0-SNAPSHOT.jar"。
图10生成Jar包
4. 登录OBS控制台,将生成的Jar包文件上传到OBS路径下。
Jar包文件上传的OBS桶所在的区域需与AI DataLake的工作空间区域相同,不可跨区域执行操作。
5. 创建UDTF函数。
1. 在[AI DataLake管理控制台](https://console.huaweicloud.com/fabric/)左下角,单击"DataArts Studio"。
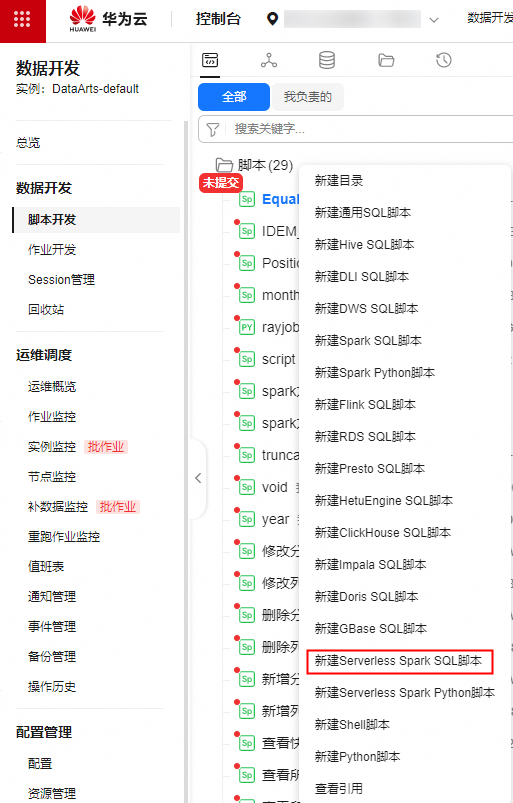
2. 在"脚本开发"页面,新建Serverless Spark SQL脚本后,选择端点,Catalog和数据库。
图11新建Serverless Spark SQL脚本
3. 在SQL编辑区域,输入创建UDTF函数的命令。
```
CREATE FUNCTION mytestsplit AS 'com.huawei.demo.UDTFSplit' using jar 'obs://aidatalake-test-obs01/MyUDTF-1.0-SNAPSHOT.jar';
```
4. 单击"运行"。
6. 验证和使用创建的UDTF函数。 在查询语句中使用创建的UDTF函数,如:
```
select mytestsplit('abc:123\;efd:567\;utf:890');
```
7. (可选)删除UDTF函数。 如果不再使用该Function,可执行以下语句删除UDTF函数:
```
Drop FUNCTION mytestsplit;
```
#### 样例代码
UDTFSplit.java完整的样例代码参考如下所示:
```
package com.huawei.demo;
import java.util.ArrayList;
import org.apache.commons.lang.StringUtils;
import org.apache.hadoop.hive.ql.exec.UDFArgumentException;
import org.apache.hadoop.hive.ql.exec.UDFArgumentLengthException;
import org.apache.hadoop.hive.ql.metadata.HiveException;
import org.apache.hadoop.hive.ql.udf.generic.GenericUDTF;
import org.apache.hadoop.hive.serde2.objectinspector.ObjectInspector;
import org.apache.hadoop.hive.serde2.objectinspector.ObjectInspectorFactory;
import org.apache.hadoop.hive.serde2.objectinspector.StructObjectInspector;
import org.apache.hadoop.hive.serde2.objectinspector.primitive.PrimitiveObjectInspectorFactory;
public class UDTFSplit extends GenericUDTF {
@Override
public void close() throws HiveException {
// TODO Auto-generated method stub
}
@Override
public void process(Object[] args) throws HiveException {
// TODO Auto-generated method stub
if(args.length == 0){
return;
}
String input = args[0].toString();
if(StringUtils.isEmpty(input)){
return;
}
String[] test = input.split(";");
for (int i = 0; i < test.length; i++) {
try {
String[] result = test[i].split(":");
forward(result);
} catch (Exception e) {
continue;
}
}
}
@Override
public StructObjectInspector initialize(ObjectInspector[] args) throws UDFArgumentException {
if (args.length != 1) {
throw new UDFArgumentLengthException("ExplodeMap takes only one argument");
}
if (args[0].getCategory() != ObjectInspector.Category.PRIMITIVE) {
throw new UDFArgumentException("ExplodeMap takes string as a parameter");
}
ArrayList fieldNames = new ArrayList();
ArrayList fieldOIs = new ArrayList();
fieldNames.add("col1");
fieldOIs.add(PrimitiveObjectInspectorFactory.javaStringObjectInspector);
fieldNames.add("col2");
fieldOIs.add(PrimitiveObjectInspectorFactory.javaStringObjectInspector);
return ObjectInspectorFactory.getStandardStructObjectInspector(fieldNames, fieldOIs);
}
}
```