# 使用MRS Spark SQL访问RDS表
#### 应用场景
在企业级数据处理场景中,使用Spark SQL访问RDS表是实现结构化数据高效分析的重要方式,广泛应用于以下业务场景:
- 跨数据源联合分析 当企业业务数据分散在RDS关系型数据库与HDFS、HBase等大数据存储中时,通过Spark SQL的JDBC连接能力,可将RDS中的结构化业务数据(如交易记录、用户信息)与大数据平台的海量日志数据进行联合查询。
- 海量数据离线处理 RDS作为在线业务数据库,更适用于高频次、小批量的事务性操作,难以承载大规模数据的复杂计算。借助Spark SQL可将RDS中的历史数据抽取至Spark集群,利用分布式计算能力完成数据清洗、聚合、建模等离线处理。
- 实时数据同步与分析 结合Spark的Streaming能力,可通过JDBC实时读取RDS的增量数据,与流数据(如实时支付流)进行融合分析。
这些场景均依托Spark SQL对JDBC数据源的原生支持,既保留了RDS在事务处理上的优势,又发挥了Spark在分布式计算上的性能,实现了在线业务数据与大数据分析平台的无缝衔接。
本实践案例展示了如何使用MRS Spark SQL访问RDS for PostgreSQL数据库中的数据。
#### 方案架构
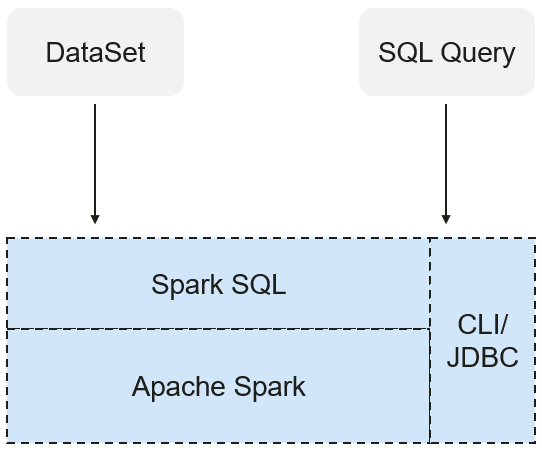
Spark SQL是Spark中用于结构化数据处理的模块,在Spark应用中,可以无缝地使用SQL语句亦或是DataSet API对结构化数据进行查询。
Spark SQL以及DataSet还提供了一种通用的访问多数据源的方式,可访问的数据源包括Hive、CSV、Parquet、ORC、JSON和JDBC数据源,这些不同的数据源之间也可以实现互相操作。Spark SQL复用了Hive的前端处理逻辑和元数据处理模块,使用Spark SQL可以直接对已有的Hive数据进行查询。
另外SparkSQL还提供了诸如API、CLI、JDBC等诸多接口,对客户端提供多样接入形式。
图1SparkSQL和DataSet
#### 前提条件
- 已创建包含了Spark组件的MRS集群。 在本示例中,以MRS 3.2.0-LTS.1版本的集群为例进行介绍,不同版本的集群部分操作可能有差异。
- 若MRS集群启用了Kerberos认证,需在集群Manager界面中提前创建具有Spark业务操作权限的用户。 例如创建一个人机用户sparkuser,关联用户组hadoop、hive,并通过Ranger为该用户添加了ADD JAR权限,相关操作可参考[添加Spark的Ranger访问权限策略](https://support.huaweicloud.com/cmpntguide-mrs/mrs_01_1860.html)。
若MRS集群未启用Kerberos认证,则无需添加该用户。
- 已获取待连接的RDS for PostgreSQL数据库的IP地址、端口、数据库名、连接用户名及密码(该用户必须对RDS表拥有读写权限)。 相关信息可联系数据库实例管理员获取,更多关于云数据库的操作可参考[云数据库 RDS for PostgreSQL帮助文档](https://support.huaweicloud.com/rds-pg/index.html)。
待连接的RDS for PostgreSQL数据库实例需要与MRS集群处于同一个VPC网络内,以保证网络互通。
- 已获取连接Postgres数据库所需的驱动程序。 在本示例中,已获取驱动文件"postgresql-42.2.5.jar",开源驱动包下载地址为。
#### 步骤一:准备RDS数据
1. 使用数据库连接工具,连接RDS for PostgreSQL实例默认数据库"postgres"。
2. 执行以下命令,创建一个数据库。
```
CREATE DATABASE rdspg_test;
```
3. 连接到创建的新数据库,并执行以下命令以创建名为"rdspg_order"的schema。
```
CREATE SCHEMA rdspg_data;
```
4. 创建数据表。
```
CREATE TABLE rdspg_data.rdspg_order (
order_id VARCHAR,
order_channel VARCHAR,
order_time VARCHAR,
cust_code VARCHAR,
pay_amount DOUBLE PRECISION,
real_pay DOUBLE PRECISION
);
```
5. 向表中插入示例数据。
```
INSERT INTO
rdspg_data.rdspg_order
VALUES
(
'202408270001',
'webShop',
'2023-06-27 10:00:00',
'CUST1',
1000,
1000
),
(
'202408270002',
'webShop',
'2023-06-27 11:00:00',
'CUST2',
5000,
5000
);
```
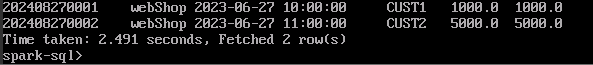
查询表数据,验证数据是否插入。
```
SELECT
*
FROM
rdspg_data.rdspg_order;
```
图2查询RDS表数据

#### 步骤二:配置MRS集群与数据库实例网络
1. 在MRS管理控制台的集群列表中,单击集群名称,在"节点管理"页签中,查看Master节点组内节点的IP地址信息并记录。
2. 在RDS管理控制台的实例列表中,单击已创建的PostgreSQL数据库实例名称,进入概览信息页面。
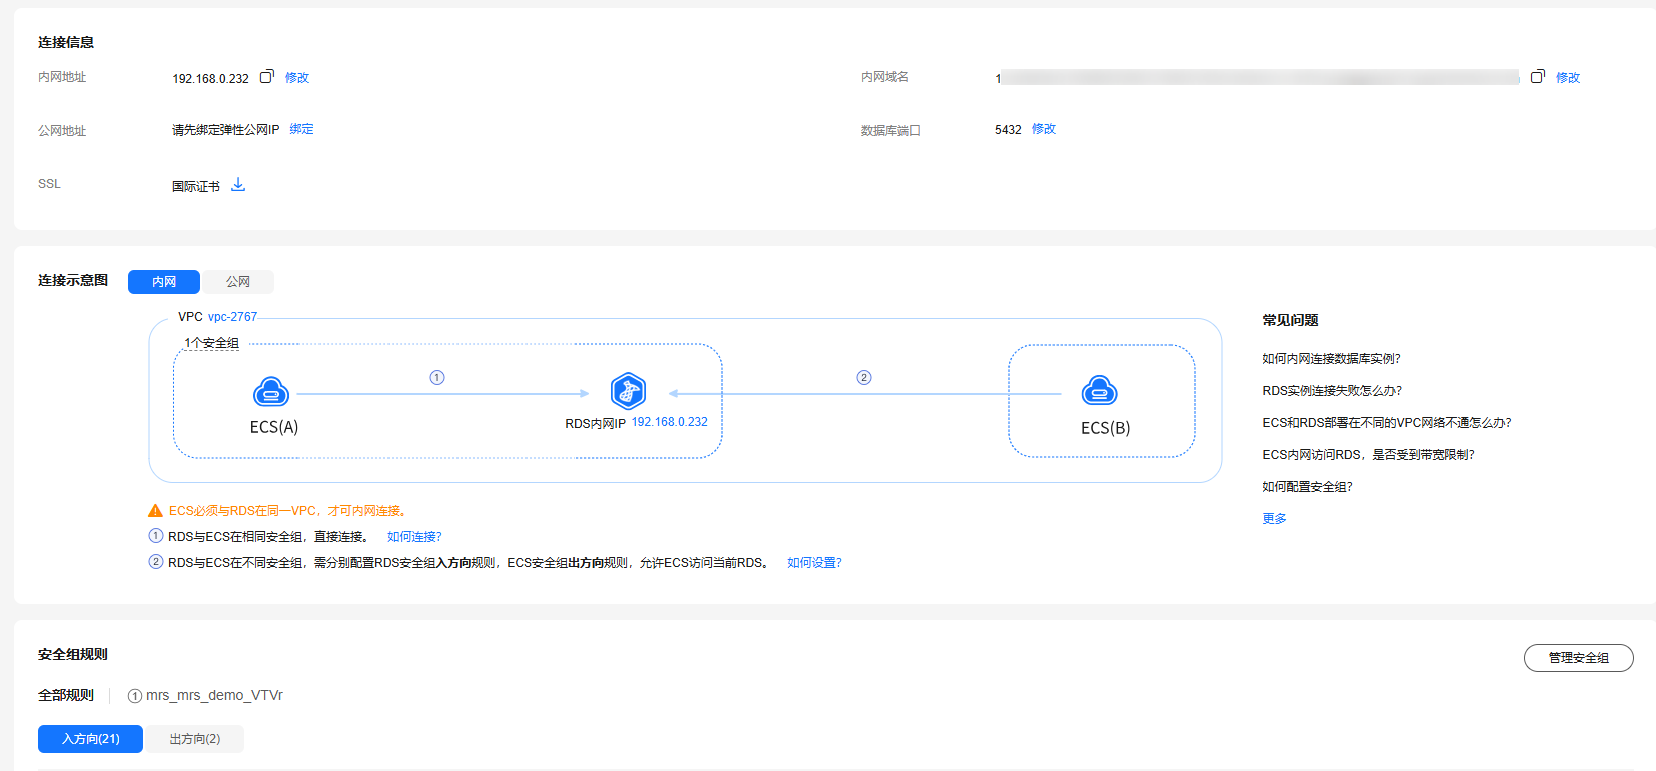
3. 在"连接管理"页签获取RDS实例的连接IP地址、数据库端口、VPC、安全组等信息。
图3查看RDS实例连接信息
4. 单击安全组名称,进入安全组配置界面。
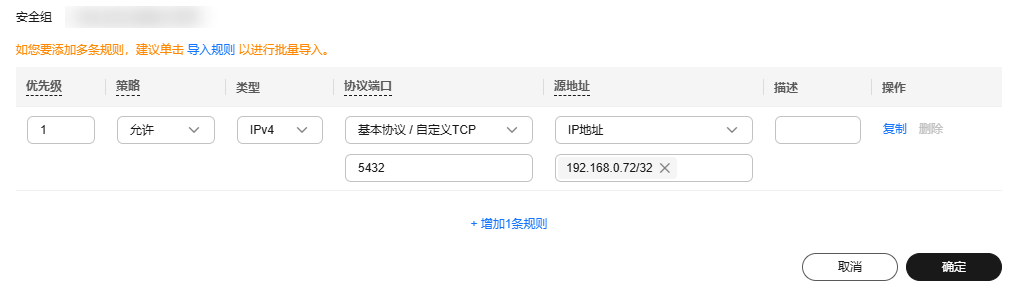
5. 在"入方向规则"页签中,添加MRS集群Master节点IP地址的规则,允许MRS集群访问数据库实例端口。
图4添加安全组规则
#### 步骤3:使用Spark客户端连接RDS表
1. 安装MRS集群客户端。
具体操作可参考[安装MRS集群客户端](https://support.huaweicloud.com/usermanual-mrs/mrs_01_0089.html)。
例如在MRS集群的Master1节点上安装客户端,客户端目录为"/opt/sparkclient"。
2. 将数据库驱动文件上传至客户端节点,例如上传至"/opt"目录下。
3. 使用**root** 用户登录客户端节点。
执行以下命令将驱动文件复制到客户端目录下。
```
cd /opt/sparkclient/Spark2x/spark/jars
```
```
cp /opt/postgresql-42.2.5.jar /opt/sparkclient/Spark2x/spark/jars
```
查看并修改文件权限信息:
```
ls -l postgresql-42.2.5.jar
```
```
chmod 755 postgresql-42.2.5.jar
```
4. 移除与PostgreSQL数据库冲突的jar包。
```
mv ./gsjdbc4-V100R003C10SPC125.jar ./sqlline-1.3.0.jar /tmp/.
```
5. 更新Spark配置文件。
1. 查看Spark应用配置文件地址。
```
cat /opt/sparkclient/Spark2x/spark/conf/spark-defaults.conf | grep 'spark.yarn.archive'
```
查看结果如下:
```
spark.yarn.archive = hdfs://hacluster/user/spark2x/jars/8.2.0.1/spark-archive-2x.zip
```
**不同版本集群归档位置可能有区别,请以实际查询结果为准。**
2. 下载Spark配置文件压缩包到本地。
```
cd /opt
```
```
mkdir sparkTmp
```
```
cd sparkTmp
```
```
source /opt/sparkclient/bigdata_env
```
如果集群开启了Kerberos认证,执行以下命令进行认证:
```
kinit sparkuser
```
执行以下命令下载HDFS文件到本地:
```
hdfs dfs -ls /user/spark2x/jars
```
```
hdfs dfs -get hdfs://hacluster/user/spark2x/jars/8.2.0.1/spark-archive-2x.zip
```
3. 解压并更新Spark配置文件压缩包。
```
unzip spark-archive-2x.zip
```
```
rm -f spark-archive-2x.zip
```
```
ls -l gsjdbc4-V100R003C10SPC125.jar sqlline-1.3.0.jar
```
```
rm -f gsjdbc4-V100R003C10SPC125.jar sqlline-1.3.0.jar
```
4. 添加驱动文件。
```
cp /opt/sparkclient/Spark2x/spark/jars/postgresql-42.2.5.jar .
```
重新压缩文件:
```
zip spark-archive-2x.zip ./*
```
6. 备份并重新上传Spark配置文件。
```
hdfs dfs -mv hdfs://hacluster/user/spark2x/jars/8.2.0.1/spark-archive-2x.zip /tmp
```
```
hdfs dfs -put spark-archive-2x.zip hdfs://hacluster/user/spark2x/jars/8.2.0.1/spark-archive-2x.zip
```
7. 在MRS Spark中创建数据源表,并访问RDS for PostgreSQL数据。
启动SparkSQL:
```
spark-sql --master yarn --jars ./postgresql-42.2.5.jar
```

在Spark中通过JDBC方式创建一个指向PostgreSQL表的外部表。
```
CREATE TABLE USING JDBC OPTIONS (
'url' = ' jdbc:postgresql://:/<数据库名称>',
'driver' = 'org.postgresql.Driver',
'dbtable' = '.',
'user' = '<数据库连接用户>',
'password' = '<数据库连接用户密码>'
);
```
例如执行示例如下:
```
CREATE TABLE spark_rdspg_order USING JDBC OPTIONS (
'url' = 'jdbc:postgresql://192.168.0.2:5432/rdspg_test',
'driver' = 'org.postgresql.Driver',
'dbtable' = 'rdspg_data.rdspg_order',
'user' = 'root',
'password' = '***'
);
```
8. 建表成功后,即可在Spark SQL中查看并操作PostgreSQL中的数据。
```
SELECT * FROM spark_rdspg_order;
```