# 通过华为云Logstash实现Elasticsearch集群间数据迁移
使用华为云CSS服务的Logstash集群可以实现Elasticsearch集群间的数据迁移。
#### 应用场景
华为云Logstash是一款全托管的数据接入处理服务,兼容开源Logstash的能力,支持用于Elasticsearch集群间数据迁移。
通过华为云Logstash可以实现华为云Elasticsearch、自建Elasticsearch或第三方Elasticsearch迁移至华为云Elasticsearch,该方案常用于以下场景:
- 跨版本迁移:利用Logstash的兼容性和灵活性,实现不同版本间的数据迁移,确保数据在新版本中的可用性和一致性。适用于Elasticsearch集群版本跨度较大的迁移场景,例如从6.X版本迁移至7.X版本。
- 集群合并:使用Logstash进行数据迁移,将多个Elasticsearch集群的数据整合到一个Elasticsearch集群中,实现多个Elasticsearch数据的统一管理和分析。
- 服务迁移上云:将自建的Elasticsearch服务迁移到云平台,以利用云服务的可扩展性、维护简便性和成本效益。
- 变更服务提供商:如果企业当前使用的是第三方Elasticsearch服务,但出于成本、性能或其他战略考虑,希望更换服务提供商至华为云。
#### 方案架构
图1迁移流程

通过华为云Logstash实现Elasticsearch集群间数据迁移的迁移流程如[图1]所示。
1. 输入(Input):华为云Logstash接收来自华为云Elasticsearch、自建Elasticsearch或第三方Elasticsearch的数据。

华为云Elasticsearch、自建Elasticsearch或第三方Elasticsearch数据迁移到华为云Elasticsearch的操作步骤相同,只是获取源集群的访问地址有差异,具体请参见[获取Elasticsearch集群信息]。
2. 过滤(Filter):华为云Logstash对数据进行清洗和转换。
3. 输出(Output):华为云Logstash将数据输出到目标集群,如华为云Elasticsearch。
根据业务需求,可以选择全量数据迁移或增量数据迁移。
- 全量数据迁移:使用Logstash进行全量数据迁移,适用于迁移初期或需要确保数据完整性的场景。
- 增量数据迁移:通过Logstash配置增量查询,可以只迁移有增量字段的索引数据。此方法适用于需要持续同步数据或对数据实时性有较高要求的场景。
#### 方案优势
- 高版本兼容性:适用于不同版本的Elasticsearch集群迁移。
- 高效的数据处理能力:Logstash支持批量读写操作,可以大幅度提高数据迁移的效率。
- 并发同步技术:利用slice并发同步技术,可以提高数据迁移的速度和性能,尤其是在处理大规模数据时。
- 配置简单:华为云Logstash的配置相对简单直观,通过配置文件即可实现数据的输入、处理和输出。
- 强大的数据处理功能:Logstash内置了丰富的过滤器,可以在迁移过程中对数据进行清洗、转换和丰富。
- 灵活的迁移策略:根据业务需求,可以灵活选择全量迁移或增量迁移,优化存储使用和迁移时间。
#### 性能影响
使用Logstash迁移集群依托于Scroll API,此API能够高效读取源集群的索引数据,并批量同步至目标集群。这一过程可能会对源集群性能产生影响,具体影响程度取决于目标集群对源集群的读取速度,而读取速度取决于Scroll API的size和slice参数配置。参数配置的详细指导可参考[Reindex API](https://www.elastic.co/guide/en/elasticsearch/reference/7.10/docs-reindex.html)文档。
- 对于资源消耗较高的集群,建议通过调整size参数来减缓迁移速率,或者选择在业务流量低谷时段迁移,以减轻对集群资源的影响。
- 对于资源消耗较低的集群,在迁移时可以采用默认参数配置,建议同时监控源集群的性能负载,并根据实际情况适时调整size和slice参数,以优化迁移效率和资源使用。
#### 约束限制
全量迁移过程中,源集群的索引数据不能增删改,否则会导致迁移后的目标集群数据与源集群数据不一致。增量迁移不受此限制。
#### 前提条件
- 源Elasticsearch集群和目标Elasticsearch集群处于可用状态。
- 已创建CSS Logstash集群(例如集群名称为"Logstash-ES"),并确认Logstash与Elasticsearch之间网络连通。
- 如果源集群、Logstash和目标集群在同一VPC,则网络已连通。
- 如果源集群、Logstash和目标集群在不同VPC,则需要先打通VPC网络。具体操作请参见[配置Logstash集群路由](https://support.huaweicloud.com/usermanual-css/css_01_0225.html)。
- 如果是自建Elasticsearch集群迁移至华为云,则可以通过给自建Elasticsearch集群配置公网访问打通网络。
- 如果是第三方Elasticsearch集群迁移至华为云,则需要建立企业内部数据中心到华为云的VPN通道或专线。
- 确认集群的索引已开启"_source"。 集群索引的"_source"默认是开启的。执行命令GET {index}/_search,当返回的搜索结果里有"_source"信息时表示已开启。
#### 操作步骤
1. [获取Elasticsearch集群信息]。
2. [(可选)迁移索引结构]:通过脚本迁移Elasticsearch集群的索引模板和索引结构。
3. [验证集群间的网络连通性]:验证Logstash和源Elasticsearch集群的连通性。
4. 使用Logstash迁移集群
- 在集群迁移初期或需要确保数据完整性的场景,推荐[使用Logstash全量迁移集群数据]。
- 在需要持续同步数据或对数据实时性有较高要求的场景,推荐[使用Logstash增量迁移集群数据]。
5. [释放Logstash集群]:当集群迁移完成后,请及时释放Logstash集群。
#### 获取Elasticsearch集群信息
在迁移集群前,需要先获取必备的集群信息,用于配置迁移任务。
表1需要获取的Elasticsearch集群信息
| 集群来源 || 要获取的信息 | 获取方式 |
|:---|---|:---|:---|
| 源集群 | 华为云Elasticsearch集群 | - 源集群的名称 - 源集群的访问地址 - 访问源集群的用户名和密码(仅安全集群涉及) | - 获取集群名称和访问地址请参见[3]。 - 用户名和密码请联系服务管理员获取。 |
| 源集群 | 自建Elasticsearch集群 | - 源集群的名称 - 源集群的公网访问地址 - 访问源集群的用户名和密码(仅安全集群涉及) | 联系服务管理员获取。 |
| 源集群 | 第三方Elasticsearch集群 | - 源集群的名称 - 源集群的访问地址 - 访问源集群的用户名和密码(仅安全集群涉及) | 联系服务管理员获取。 |
| 目标集群 | 华为云Elasticsearch集群 | - 目标集群的访问地址 - 访问目标集群的用户名和密码(仅安全集群涉及) | - 获取访问地址请参见[3]。 - 用户名和密码请联系服务管理员获取。 |
源集群的来源不同,获取信息的方式不同,此处仅介绍如何获取华为云Elasticsearch集群的信息。
1. 登录[云搜索服务管理控制台](https://console.huaweicloud.com/elasticsearch/)。
2. 在左侧导航栏,选择"集群管理 \> Elasticsearch"。
3. 在集群列表,选择目标集群,获取集群名称和访问地址。
图2获取集群信息

#### (可选)迁移索引结构
如果您直接在目标Elasticsearch集群手动创建索引结构,则跳过该步骤。此处提供了一种通过脚本迁移Elasticsearch集群的索引模板和索引结构的方法。
1. 创建弹性云服务器ECS,用于迁移源集群的元数据。
1. 创建弹性云服务器ECS,ECS的操作系统选择CentOS,规格选择2U4G,且和CSS服务的集群在同一个虚拟私有云和安全组中。
2. 测试ECS和源集群、目标集群的连通性。 在ECS执行命令curl http://{ip}:{port}测试连通性,当返回200时,则表示已经连通。
IP是源集群和目标集群访问地址;port是端口号,默认是9200,请以集群实际端口号为准。
2. 安装Python,用于执行迁移脚本。 基于执行机环境选择合适的安装方式。
表2安装Python的方案介绍
| Python版本 | 环境是否联网 | 操作指导 |
|:---|:---|:---|
| Python3 | 是 | [•在线安装Python3] |
| Python3 | 否 | [•离线安装Python3] |
| Python2 | 是 | [•在线安装Python2] |
| Python2 | 否 | [•离线安装Python2] |
- **在线安装Python3**
直接使用yum和pip安装python3。
1. 安装python3。
```
[root@ecs opt]# yum install python3
```
2. 安装pip。
```
[root@ecs opt]# yum install python3-pip zlib-devel
```
3. 安装yaml依赖。
```
[root@ecs opt]# pip3 install pyyaml
```
4. 安装requests依赖。
```
[root@ecs opt]# pip3 install requests
```
5. 检查安装结果,确认安装成功。
```
# 检查python版本
[root@ecs opt]# python3 --version
Python 3.8.0
# 检查pip版本
[root@ecs opt]# pip3 --version
pip 9.0.3 from /usr/lib/python3.8/site-packages (python 3.8)
```
- **离线安装Python3**
离线下载安装包到虚拟机上执行安装命令。
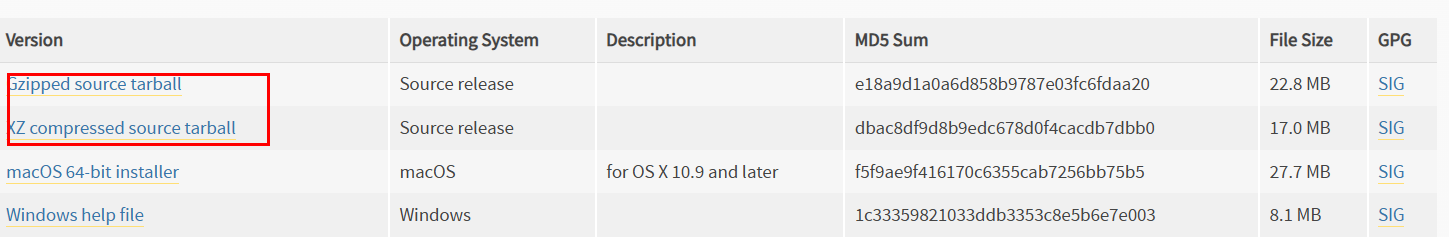
1. 下载python3安装包,下载地址。选择源码下载安装。
图3下载python3安装包
2. 使用WinSCP工具上传Python安装包到opt目录下,并安装python。
```
# 解压python压缩包
[root@ecs-52bc opt]# tar -xvf Python-3.8.0.tar.xz
Python-3.8.0/Modules/zlib/crc32.c
Python-3.8.0/Modules/zlib/gzlib.c
Python-3.8.0/Modules/zlib/inffast.c
Python-3.8.0/Modules/zlib/example.c
Python-3.8.0/Modules/python.c
Python-3.8.0/Modules/nismodule.c
Python-3.8.0/Modules/Setup.config.in
…
# 解压完成进入目录
[root@ecs-52bc opt]# cd Python-3.8.0
# 检查文件配置安装路径
[root@ecs-52bc Python-3.8.0]# ./configure --prefix=/usr/local/python3 --with-zlib
…
checking for build directories... checking for --with-computed-gotos... no value specified
checking whether gcc -pthread supports computed gotos... yes
done
checking for ensurepip... no
configure: creating ./config.status
config.status: creating Makefile.pre
config.status: creating Modules/Setup.config
config.status: creating Misc/python.pc
config.status: creating Modules/ld_so_aix
config.status: creating pyconfig.h
creating Modules/Setup
creating Modules/Setup.local
creating Makefile
# 编译python
[root@ecs-52bc Python-3.8.0]# make
# 安装python
[root@ecs-52bc Python-3.8.0]# make install
```
3. 检查安装结果,确认安装成功。
```
# 检查python版本
[root@ecs-52bc Python-3.8.0]# python3 --version
Python 3.8.0
# 检查pip版本
[root@ecs-52bc Python-3.8.0]# pip3 --version
pip 9.0.3 from /usr/lib/python3.8/site-packages (python 3.8)
```
- **在线安装Python2**
直接使用yum和pip安装python2。
1. 安装python2。
```
[root@ecs opt]# yum install python2
```
2. 安装pip。
```
[root@ecs opt]# yum install python-pip
```
3. 安装yaml依赖。
```
[root@ecs opt]# pip install pyyaml
```
4. 安装requests依赖。
```
[root@ecs opt]# pip install requests
```
5. 检查安装结果,确认安装成功。
```
# 检查python版本
[root@ecs opt]# python --version
Python 2.7.5
# 检查pip版本
[root@ecs opt]# pip --version
pip 7.1.2 from /usr/lib/python2.7/site-packages/pip-7.1.2-py2.7.egg (python 2.7)
```
- **离线安装Python2**
离线下载安装包到虚拟机上执行安装命令。
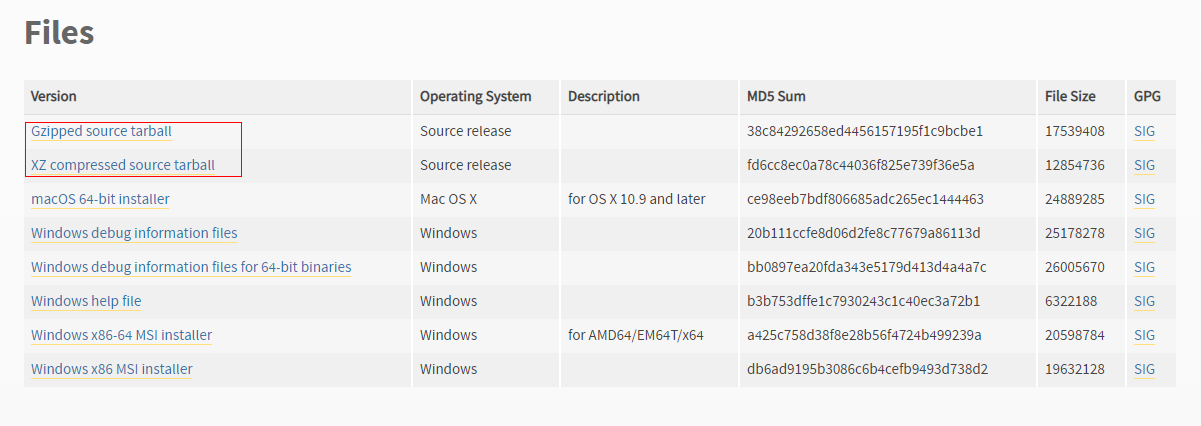
1. 下载python2安装包,下载地址。选择源码下载安装。
图4下载python2安装包
2. 使用WinSCP工具上传Python安装包到opt目录下,并安装python。
```
# 解压python压缩包
[root@ecs-52bc opt]# tar -xvf Python-2.7.18.tgz
Python-2.7.18/Modules/zlib/crc32.c
Python-2.7.18/Modules/zlib/gzlib.c
Python-2.7.18/Modules/zlib/inffast.c
Python-2.7.18/Modules/zlib/example.c
Python-2.7.18/Modules/python.c
Python-2.7.18/Modules/nismodule.c
Python-2.7.18/Modules/Setup.config.in
…
# 解压完成进入目录
[root@ecs-52bc opt]# cd Python-2.7.18
# 检查文件配置安装路径
[root@ecs-52bc Python-2.7.18]# ./configure --prefix=/usr/local/python2
…
checking for build directories... checking for --with-computed-gotos... no value specified
checking whether gcc -pthread supports computed gotos... yes
done
checking for ensurepip... no
configure: creating ./config.status
config.status: creating Makefile.pre
config.status: creating Modules/Setup.config
config.status: creating Misc/python.pc
config.status: creating Modules/ld_so_aix
config.status: creating pyconfig.h
creating Modules/Setup
creating Modules/Setup.local
creating Makefile
# 编译python
[root@ecs-52bc Python-2.7.18]# make
# 安装python
[root@ecs-52bc Python-2.7.18]# make install
```
3. 检查安装结果,确认安装成功。
```
# 检查python版本
[root@ecs-52bc Python-2.7.18]# python --version
Python 2.7.5
# 检查pip版本
[root@ecs-52bc Python-2.7.18]# pip --version
pip 7.1.2 from /usr/lib/python2.7/site-packages/pip-7.1.2-py2.7.egg (python 2.7)
```
3. 准备Elasticsearch集群的索引迁移脚本。
下面给出了迁移脚本的示例代码,请根据业务需求修改内容。
1. 执行vi migrateConfig.yaml命令,输入并基于实际信息修改以下内容,执行wq保存为**Logstash迁移脚本** 。集群信息的获取方式请参见[获取Elasticsearch集群信息]。
```
es_cluster_new:
# 源集群的名称
clustername: es_cluster_new
# 源Elasticsearch集群的访问地址,集群使用HTTP协议时加上“http://”;集群使用HTTPS协议时加上“https://”。
src_ip: http://x.x.x.x:9200
# 访问源Elasticsearch集群的用户名和密码,如果为非安全集群则设置为""。
src_username: ""
src_password: ""
# 目标Elasticsearch集群的访问地址,集群使用HTTP协议时加上“http://”;集群使用HTTPS协议时加上“https://”。
dest_ip: http://x.x.x.x:9200
# 访问目标Elasticsearch集群的用户名和密码,如果为非安全集群则设置为""。
dest_username: ""
dest_password: ""
# “only_mapping”可以不定义,默认值为false,需要搭配“migrateMapping.py”使用,表示是否只处理这个文件中mapping地址的索引。当设置成true时,则只迁移源集群中和下面mapping的key一致的索引数据;当设置成false时,则迁移源集群中除“.kibana”和“.*”之外的所有索引数据。
# 迁移过程中会将索引名称与下面的mapping匹配,如果匹配一致,则使用mapping的value作为目标集群的索引名称;如果匹配不到,则使用源集群原始的索引名称。
only_mapping: false
# 设置要迁移的索引,key为源集群的索引名字,value为目标集群的索引名字,涉及多个索引时要换行。
mapping:
test_index_1: test_index_1
```
2. 执行vi migrateTemplate.py命令,直接复制输入以下内容无需修改,执行wq保存为**索引模板迁移脚本** 。
```
# -*- coding:UTF-8 -*-
import json
import os
import sys
import requests
import yaml
requests.packages.urllib3.disable_warnings()
def loadConfig(argv):
if argv is None or len(argv) != 2:
config_yaml = "migrateConfig.yaml"
else:
config_yaml = argv[1]
config_file = open(config_yaml)
return yaml.safe_load(config_file)
def put_template_to_target(url, template, cluster, template_name, dest_auth=None):
headers = {'Content-Type': 'application/json'}
create_resp = requests.put(url, headers=headers, data=json.dumps(template), auth=dest_auth, verify=False)
if not os.path.exists("templateLogs"):
os.makedirs("templateLogs")
if create_resp.status_code != 200:
print("create template " + url + " failed with response: " + str(
create_resp) + ", source template is " + template_name)
print(create_resp.text)
filename = "templateLogs/" + str(cluster) + "#" + template_name
with open(filename + ".json", "w") as f:
json.dump(template, f)
return False
else:
return True
def process_template(index_mapping):
# remove unnecessary keys
if "settings" in index_mapping and "index" in index_mapping["settings"]:
# 移除routing配置
if "routing" in index_mapping["settings"]["index"]:
del index_mapping["settings"]["index"]["routing"]
if "mapper" in index_mapping["settings"]["index"]:
del index_mapping["settings"]["index"]["mapper"]
if "lifecycle" in index_mapping["settings"]["index"]:
del index_mapping["settings"]["index"]["lifecycle"]
return index_mapping
def main(argv):
print("begin to migration template!")
config = loadConfig(argv)
src_clusters = config.keys()
print("begin to process cluster name : " + ','.join(src_clusters))
print("cluster count : " + str(src_clusters.__len__()))
for name, value in config.items():
print("<=============================================================>")
source_user = value["src_username"]
source_passwd = value["src_password"]
source_auth = None
if source_user != "":
source_auth = (source_user, source_passwd)
dest_user = value["dest_username"]
dest_passwd = value["dest_password"]
dest_auth = None
if dest_user != "":
dest_auth = (dest_user, dest_passwd)
print("start to process cluster name: " + name)
source_url = value["src_ip"] + "/_template"
response = requests.get(source_url, auth=source_auth, verify=False)
if response.status_code != 200:
print("[error] get all template failed. resp statusCode:" + str(
response.status_code) + " response is " + response.text)
continue
all_template = response.json()
migrate_template = []
for template in all_template.keys():
if template.startswith(".") or template == "logstash":
continue
if "index_patterns" in all_template[template]:
if any(s.startswith(".") for s in all_template[template]["index_patterns"]):
print('[skip] skip (.*) template, cluster: %-10s, template %-30s ' % (str(name), str(template)))
continue
template_content = process_template(all_template[template])
migrate_template.append([template, template_content])
for template, template_content in migrate_template:
dest_index_url = value["dest_ip"] + "/_template/" + template
result = put_template_to_target(dest_index_url, template_content, name, template, dest_auth)
if result is True:
print('[success] migrate success, cluster: %-10s, template %-30s ' % (str(name), str(template)))
else:
print('[failure] migrate failure, cluster: %-10s, template %-30s ' % (str(name), str(template)))
if __name__ == '__main__':
main(sys.argv)
```
3. 执行vi migrateMapping.py命令,直接复制输入以下内容无需修改,执行wq保存为**索引结构迁移脚本** 。
```
# -*- coding:UTF-8 -*-
import json
import os
import sys
import requests
import yaml
requests.packages.urllib3.disable_warnings()
def loadConfig(argv):
if argv is None or len(argv) != 2:
config_yaml = "migrateConfig.yaml"
else:
config_yaml = argv[1]
config_file = open(config_yaml)
return yaml.safe_load(config_file)
def process_mapping(index_mapping, dest_index):
# remove unnecessary keys
del index_mapping["settings"]["index"]["provided_name"]
del index_mapping["settings"]["index"]["uuid"]
del index_mapping["settings"]["index"]["creation_date"]
del index_mapping["settings"]["index"]["version"]
# 移除routing配置
if "routing" in index_mapping["settings"]["index"]:
del index_mapping["settings"]["index"]["routing"]
if "lifecycle" in index_mapping["settings"]["index"]:
del index_mapping["settings"]["index"]["lifecycle"]
# check alias
aliases = index_mapping["aliases"]
for alias in list(aliases.keys()):
if alias == dest_index:
print(
"source index[" + dest_index + "],alias[" + alias + "]is the same as dest_index name, will remove this alias.")
del index_mapping["aliases"][alias]
# 兼容生命周期管理策略
if "lifecycle" in index_mapping["settings"]["index"]:
lifecycle = index_mapping["settings"]["index"]["lifecycle"]
opendistro = {"opendistro": {"index_state_management":
{"policy_id": lifecycle["name"],
"rollover_alias": lifecycle["rollover_alias"]}}}
index_mapping["settings"].update(opendistro)
del index_mapping["settings"]["index"]["lifecycle"]
# replace synonyms_path
if "analysis" in index_mapping["settings"]["index"]:
analysis = index_mapping["settings"]["index"]["analysis"]
if "filter" in analysis:
filter = analysis["filter"]
if "my_synonym_filter" in filter:
my_synonym_filter = filter["my_synonym_filter"]
if "synonyms_path" in my_synonym_filter:
del index_mapping["settings"]["index"]["analysis"]["filter"]["my_synonym_filter"]["synonyms_path"]
return index_mapping
def get_index(source, source_auth):
response = requests.get(source + "/_alias", auth=source_auth, verify=False)
if response.status_code != 200:
print("[error] get all index failed. resp statusCode:" + str(
response.status_code) + " response is " + response.text)
exit()
all_index = response.json()
system_index = []
create_index = []
for index in list(all_index.keys()):
if index.startswith("."):
system_index.append(index)
else:
create_index.append(index)
return system_index, create_index
def get_mapping(source, source_index, source_auth):
source_url = source + "/" + source_index
response = requests.get(source_url, auth=source_auth, verify=False)
if response.status_code != 200:
print("[error] get ElasticSearch message failed. resp statusCode:" + str(
response.status_code) + " response is " + response.text)
return None
return response.json()
def put_mapping_to_target(url, mapping, cluster, source_index, dest_auth=None):
headers = {'Content-Type': 'application/json'}
create_resp = requests.put(url, headers=headers, data=json.dumps(mapping), auth=dest_auth, verify=False)
if not os.path.exists("mappingLogs"):
os.makedirs("mappingLogs")
if create_resp.status_code != 200:
print("[error] create index " + url + " failed with response: " + str(create_resp) + ", source index is " + str(
source_index))
print(create_resp.text)
filename = "mappingLogs/" + str(cluster) + "#" + str(source_index)
with open(filename + ".json", "w") as f:
json.dump(mapping, f)
return False
else:
return True
def main(argv):
print("begin to migrate index mapping!")
config = loadConfig(argv)
src_clusters = config.keys()
print("begin to process cluster name : " + ','.join(src_clusters))
print("cluster count : " + str(src_clusters.__len__()))
for name, value in config.items():
print("<=============================================================>")
source = value["src_ip"]
source_user = value["src_username"]
source_passwd = value["src_password"]
source_auth = None
if source_user != "":
source_auth = (source_user, source_passwd)
dest = value["dest_ip"]
dest_user = value["dest_username"]
dest_passwd = value["dest_password"]
dest_auth = None
if dest_user != "":
dest_auth = (dest_user, dest_passwd)
print("start to process cluster: " + name)
indices = []
# only deal with mapping list
if 'only_mapping' in value and value["only_mapping"]:
for source_index, dest_index in value["mapping"].items():
indices.append([source_index, dest_index])
else:
# get all indices
system_index, create_index = get_index(source, source_auth)
for index in create_index:
dest_index = index
if 'mapping' in value:
if index in value["mapping"].keys():
dest_index = value["mapping"][index]
indices.append([index, dest_index])
success_index = 0
for source_index, dest_index in indices:
mapping = get_mapping(source, source_index, source_auth)
if mapping is None:
print("[failure] cluster name:" + name + ", " + source_index)
continue
index_mapping = process_mapping(mapping[source_index], dest_index)
dest_url = dest + "/" + dest_index
result = put_mapping_to_target(dest_url, index_mapping, name, source_index, dest_auth)
if result is False:
print("[failure] migrate mapping cluster name: " + name + ", " + source_index)
continue
print("[success] migrate mapping cluster name: " + name + ", " + source_index)
success_index = success_index + 1
print("create index mapping success total: " + str(success_index))
if __name__ == '__main__':
main(sys.argv)
```
4. 执行vi checkIndices.py命令,直接复制输入以下内容无需修改,执行wq保存为**索引数据对比脚本** 。
```
# -*- coding:UTF-8 -*-
import sys
import requests
import yaml
requests.packages.urllib3.disable_warnings()
def loadConfig(argv):
if argv is None or len(argv) != 2:
config_yaml = "migrateConfig.yaml"
else:
config_yaml = argv[1]
config_file = open(config_yaml)
return yaml.safe_load(config_file)
# get all indices
def get_indices(url, source_auth):
response = requests.get(url + "/_alias", auth=source_auth, verify=False)
if response.status_code != 200:
print("[error] get all index failed. resp statusCode:" + str(
response.status_code) + " response is " + response.text)
exit()
all_index = response.json()
system_index = []
create_index = []
for index in list(all_index.keys()):
if (index.startswith(".")):
system_index.append(index)
else:
create_index.append(index)
return create_index
def get_index_total(url, index, es_auth):
stats_url = url + "/" + index + "/_stats"
index_response = requests.get(stats_url, auth=es_auth, verify=False)
if index_response.status_code != 200:
print("[error] get ElasticSearch stats message failed. resp statusCode:" + str(
index_response.status_code) + " response is " + index_response.text)
return 0
return index_response.json()
def main(argv):
print("begin to check index documents count!")
config = loadConfig(argv)
src_clusters = config.keys()
print("begin to process cluster name : " + ','.join(src_clusters))
print("cluster count : " + str(src_clusters.__len__()))
for name, value in config.items():
print("<=============================================================>")
source = value["src_ip"]
source_user = value["src_username"]
source_passwd = value["src_password"]
source_auth = None
if source_user != "":
source_auth = (source_user, source_passwd)
dest = value["dest_ip"]
dest_user = value["dest_username"]
dest_passwd = value["dest_password"]
dest_auth = None
if dest_user != "":
dest_auth = (dest_user, dest_passwd)
cluster_name = name
if "clustername" in value:
cluster_name = value["clustername"]
print("start to process cluster: " + cluster_name)
# get all indices
all_source_index = get_indices(source, source_auth)
all_dest_index = get_indices(dest, dest_auth)
print("source indices total : " + str(all_source_index.__len__()))
print("destination indices total : " + str(all_dest_index.__len__()))
for index in all_source_index:
index_total = get_index_total(value["src_ip"], index, source_auth)
src_total = index_total["_all"]["primaries"]["docs"]["count"]
src_size = int(index_total["_all"]["primaries"]["store"]["size_in_bytes"]) / 1024 / 1024
dest_index = get_index_total(value["dest_ip"], index, dest_auth)
if dest_index == 0:
print('[failure] not found, index: %-20s, source total: %-10s size %6sM'
% (str(index), str(src_total), src_size))
continue
dest_total = dest_index["_all"]["primaries"]["docs"]["count"]
if src_total != dest_total:
print('[failure] not consistent, '
'index: %-20s, source total: %-10s size %6sM destination total: %-10s '
% (str(index), str(src_total), src_size, str(dest_total)))
continue
print('[success] compare index total equal : index : %-20s, total: %-20s '
% (str(index), str(dest_total)))
if __name__ == '__main__':
main(sys.argv)
```
4. 执行如下命令,迁移Elasticsearch集群的索引模板和索引结构。
```
# Python3执行如下命令
python3 migrateTemplate.py
python3 migrateMapping.py
# Python2执行如下命令
python migrateTemplate.py
python migrateMapping.py
```
#### 验证集群间的网络连通性
在启动迁移任务前,需要先验证Logstash和源Elasticsearch集群的网络连通性。
1. 进入Logstash配置中心页面。
1. 登录[云搜索服务管理控制台](https://console.huaweicloud.com/elasticsearch/)。
2. 在左侧导航栏,选择"集群管理 \> Logstash"。
3. 在集群列表,单击目标集群名称,进入集群详情页。
4. 选择"配置中心"页签。
2. 在配置中心页面,单击"连通性测试"。
3. 在弹窗中输入源集群的IP地址和端口号,单击"测试"。
图5连通性测试

当显示"可用"时,表示集群间网络连通。如果显示"不可用"可以参考[Logstash连通性测试的结果为不可用时怎么办?](https://support.huaweicloud.com/css_faq/css_02_0090.html)解决。
#### 使用Logstash全量迁移集群数据
在集群迁移初期或需要确保数据完整性的场景,推荐使用Logstash全量迁移集群数据,该方法会一次迁移整个Elasticsearch集群的数据。
1. 进入Logstash配置中心页面。
1. 登录[云搜索服务管理控制台](https://console.huaweicloud.com/elasticsearch/)。
2. 在左侧导航栏,选择"集群管理 \> Logstash"。
3. 在集群列表,单击目标集群名称,进入集群详情页。
4. 选择"配置中心"页签。
2. 在配置中心页面,单击右上角"创建",进入创建配置文件页面,编辑Elasticsearch集群的全量迁移配置文件。
1. 选择集群模板:展开系统模板,选择"elasticsearch",单击操作列的"应用"。
2. 设置配置文件名称:在"名称"处自定义配置文件名称,例如"es-es-all"。
3. 修改配置文件内容:在"配置文件内容"处填写Elasticsearch集群的迁移配置方案,配置文件示例如下:
```
input{
elasticsearch{
# 源端集群的节点访问地址,无需添加协议
hosts => ["xxx.xxx.xxx.xxx:9200", "xxx.xxx.xxx.xxx:9200"]
# 配置全量迁移的源索引名称。
index => "index*"
docinfo => true
slices => 3
size => 3000
# 安全集群必配 (非安全集群请删除以下配置)
# user => "xxx" # 访问集群的用户名
# password => "xxx" # 用户名对应的密码
# 源端集群启用SSL时,则需额外配置以下信息
# ssl => true
# ca_file => "/opt/logstash/extend/certs" # 用于认证源端集群的CA证书文件路径
}
}
filter {
# 移除一些Logstash事件添加的元数据字段
mutate {
remove_field => ["@version"]
}
}
output{
elasticsearch{
# 目的端集群的节点访问地址,无需添加协议
hosts => ["xxx.xxx.xxx.xxx:9200", "xxx.xxx.xxx.xxx:9200"]
# 事件写入的索引配置,以下配置表示保留源数据的索引名称、文档类型和文档id
index => "%{[@metadata][_index]}"
document_type => "%{[@metadata][_type]}"
document_id => "%{[@metadata][_id]}"
# 安全集群必配 (非安全集群请删除以下配置)
# user => "xxx" # 访问集群的用户名
# password => "xxx" # 用户名对应的密码
# 目的端集群启用SSL时,则需额外配置以下信息
# ssl => true
# cacert => "/opt/logstash/extend/certs" # 用于认证目的端集群的CA证书文件路径
# ssl_certificate_verification => false # 目的端集群是否启用安全证书认证
}
}
```
表3全量迁移配置项说明
| **配置**项名称 || **说明** |
|:---|---|:---|
| input | hosts | 源端集群的节点访问地址。支持配置多个IP地址。 取值格式:\["\<节点IP地址1\>:\<端口号\>", "\<节点IP地址2\>:\<端口号\>"\] |
| input | user | 访问源端集群的用户名。 安全模式的集群必填。 |
| input | password | 访问源端集群的用户名对应的密码。 安全模式的集群必填。 |
| input | index | 待全量迁移的源索引名称。 - 单个索引:直接输入索引名称(如"my_index")。 - 多个索引:用英文逗号分隔多个索引(如"my_index1,my_index2")。 - 通配符:支持通配符 \*(匹配任意字符),如"myindex\*"表示匹配所有以myindex开头的索引。 |
| input | docinfo | 是否保留源文档的元数据信息。 取值范围: - true:会将元数据提取到事件的@metadata字段中。 - false(默认值):只提取文档的_source内容。 |
| input | slices | 并行分片数,将读取任务拆分为多个并行的切片,用于提高数据迁移吞吐量。 默认值:1 分片数过多可能导致资源竞争,需根据集群负载调整。在确保集群资源充足的情况下,需提升性能时,可适当增加本参数值,建议设置在2\~8。 |
| input | size | 每次查询返回的最大命中数。 |
| input | ssl | 源端集群是否启用SSL。 取值范围: - true:使用HTTPS协议传输数据。 - false:使用HTTP协议传输数据。 |
| input | ca_file | 用于认证源端集群的CA证书文件路径。 取值格式:\<证书路径\>\<证书名称\>(如/opt/logstash/extend/certs) - 当源端集群是CSS服务的Elasticsearch或OpenSearch时,获取默认CA证书的"证书名称"和"证书路径"。操作指导请参见[查看默认证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 - 当源端集群是自建或第三方Elasticsearch或OpenSearch时,则将源端集群的安全证书上传至Logstash并获取"证书名称"和"证书路径"。操作指导请参见[上传自定义证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 |
| output | hosts | 目的端集群的节点访问地址。支持配置多个IP地址。 取值格式:\["\<节点IP地址1\>:\<端口号\>", "\<节点IP地址2\>:\<端口号\>"\] |
| output | index | 事件写入的索引名称,即指定数据写入到哪个索引。 - 单个索引:直接输入单个索引名称(如"my_index")。 - 多个索引:基于字段的动态命名或多个条件输出块来匹配多个索引。 |
| output | document_type | 事件写入的文档类型。 建议将相似的事件写入同一类型中。 |
| output | document_id | 事件写入的文档ID。如需要自动生成,使用"#"注释掉即可。 如果指定了相同ID,则历史数据会被覆盖。 在数据迁移场景中建议配置本参数,避免数据重复。 |
| output | user | 访问目的端集群的用户名。 安全模式的集群必填。 |
| output | password | 访问目的端集群的用户名对应的密码。 安全模式的集群必填。 |
| output | ssl | 目的端集群是否启用SSL。 取值范围: - true:使用HTTPS协议传输数据。 - false:使用HTTP协议传输数据。 |
| output | cacert | 用于认证目的端集群的CA证书文件路径。 取值格式:\<证书路径\>\<证书名称\>(如/opt/logstash/extend/certs) - 当目的端集群是CSS服务的Elasticsearch或OpenSearch时,获取默认CA证书的"证书名称"和"证书路径"。操作指导请参见[查看默认证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 - 当目的端集群是自建或第三方Elasticsearch或OpenSearch时,则将目的端集群的安全证书上传至Logstash并获取"证书名称"和"证书路径"。操作指导请参见[上传自定义证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 |
| output | ssl_certificate_verification | 目的端集群是否启用安全证书认证。 取值范围: - true(默认值):使用安全证书认证目的端集群。 - false:忽略安全证书认证。 |
4. 编辑完成后,单击"下一页"配置Logstash配置文件运行参数。 此示例保持默认值即可,如需设置请参见[创建Logstash配置文件](https://support.huaweicloud.com/usermanual-css/css_01_0159.html)。
5. 配置完成后,单击"创建"。 在配置中心页面可以看到创建的配置文件,状态为"可用",表示创建成功。
3. 启动全量迁移任务。
1. 在配置文件列表,选择配置文件"es-es-all",单击左上角的"启动"。
2. 在"启动Logstash服务"对话框中,根据业务需要选择"是否保持常驻"。此示例不开启保持常驻。 保持常驻会在每个节点上面配置一个守护进程,当Logstash服务出现故障的时候,会主动拉起并修复,从而保证Logstash管道稳定运行。保持常驻适用于需要长期运行的业务,不适用于短期运行的业务,短期业务如果源端无数据,开启保持常驻会导致任务失败。
3. 单击"确定",开始执行配置文件以启动Logstash全量迁移任务。 可以在管道列表看到启动的配置文件。
4. 数据迁移完毕检查数据一致性。
- 方式一:使用Putty登录迁移虚拟机,执行命令python checkIndices.py对比数据结果。
- 方式二:分别在源集群和目标集群的Kibana执行命令GET _cat/indices,对比两者的索引信息是否一致。
#### 使用Logstash增量迁移集群数据
在需要持续同步数据或对数据实时性有较高要求的场景,推荐使用Logstash增量迁移集群数据,该方法通过Logstash配置增量查询,仅支持迁移有增量字段的索引数据。
1. 进入Logstash配置中心页面。
1. 登录[云搜索服务管理控制台](https://console.huaweicloud.com/elasticsearch/)。
2. 在左侧导航栏,选择"集群管理 \> Logstash"。
3. 在集群列表,单击目标集群名称,进入集群详情页。
4. 选择"配置中心"页签。
2. 在配置中心页面,单击右上角"创建",进入创建配置文件页面,编辑Elasticsearch集群的增量迁移配置文件。
1. 选择集群模板:展开系统模板,选择"elasticsearch",单击操作列的"应用"。
2. 设置配置文件名称:在"名称"处自定义配置文件名称,例如"es-es-inc"。
3. 修改配置文件内容:在"配置文件内容"处填写Elasticsearch集群的迁移配置方案,配置文件示例如下。 不同的索引的增量迁移配置不同,必须基于索引分析给出增量配置文件迁移命令。集群信息的获取方式请参见[获取Elasticsearch集群信息]。
```
input{
elasticsearch{
# 源端集群的节点访问地址,无需添加协议
hosts => ["xxx.xxx.xxx.xxx:9200", "xxx.xxx.xxx.xxx:9200"]
# 配置增量迁移的源索引名称
index => "index*"
# 配置增量迁移查询语句
query => '{"query":{"bool":{"should":[{"range":{"postsDate":{"from":"2021-05-25 00:00:00"}}}]}}}'
docinfo => true
scroll => 1m
size => 1000
# 安全集群必配 (非安全集群请删除以下配置)
# user => "xxx" # 访问集群的用户名
# password => "xxx" # 用户名对应的密码
# 源端集群启用SSL时,则需额外配置以下信息
# ssl => true
# ca_file => "/opt/logstash/extend/certs" # 用于认证源端集群的CA证书文件路径
}
}
filter {
# 移除一些Logstash事件添加的元数据字段
mutate {
remove_field => ["@timestamp", "@version"]
}
}
output{
elasticsearch{
# 目的端集群的节点访问地址,无需添加协议
hosts => ["xxx.xxx.xxx.xxx:9200", "xxx.xxx.xxx.xxx:9200"]
# 事件写入的索引配置,以下配置表示保留源数据的索引名称、文档类型和文档id
index => "%{[@metadata][_index]}"
document_type => "%{[@metadata][_type]}"
document_id => "%{[@metadata][_id]}"
# 安全集群必配 (非安全集群请删除以下配置)
# user => "xxx" # 访问集群的用户名
# password => "xxx" # 用户名对应的密码
# 目的端集群启用SSL时,则需额外配置以下信息
# ssl => true
# cacert => "/opt/logstash/extend/certs" # 用于认证目的端集群的CA证书文件路径
# ssl_certificate_verification => false # 目的端集群是否启用安全证书认证
}
}
```
表4增量迁移配置项说明
| **配置**项名称 || **说明** |
|:---|---|:---|
| input | hosts | 源端集群的节点访问地址。支持配置多个IP地址。 取值格式:\["\<节点IP地址1\>:\<端口号\>", "\<节点IP地址2\>:\<端口号\>"\] |
| input | user | 访问源端集群的用户名。 安全模式的集群必填。 |
| input | password | 访问源端集群的用户名对应的密码。 安全模式的集群必填。 |
| input | index | 待增量迁移的源索引名称。 - 单个索引:直接输入索引名称(如"my_index")。 - 多个索引:用英文逗号分隔多个索引(如"my_index1,my_index2")。 - 通配符:支持通配符 \*(匹配任意字符),如"myindex\*"表示匹配所有以myindex开头的索引。 |
| input | query | 增量数据的识别标识,一般是Elasticsearch的DSL语句。 例如,迁移2021-05-25之后新增加的数据: ``` {"query":{"bool":{"should":[{"range":{"postsDate":{"from":"2021-05-25 00:00:00"}}}]}}} ``` 其中postsDate为业务中的时间字段。在多次增量迁移过程中需要修改此处的时间值,如果日期是时间戳方式请转换为时间戳。此处命令需要提前验证有效性。 |
| input | docinfo | 是否保留源文档的元数据信息。 取值范围: - true:会将元数据提取到事件的@metadata字段中。 - false(默认值):只提取文档的_source内容。 |
| input | scroll | 当源端数据量过大,为了防止Logstash内存溢出,可以使用scroll分批次获取数据。 默认值:1m 间隔时间不要太长,否则可能会丢失数据。 |
| input | size | 每次查询返回的最大命中数。 |
| input | ssl | 源端集群是否启用SSL。 取值范围: - true:使用HTTPS协议传输数据。 - false:使用HTTP协议传输数据。 |
| input | ca_file | 用于认证源端集群的CA证书文件路径。 取值格式:\<证书路径\>\<证书名称\>(如/opt/logstash/extend/certs) - 当源端集群是CSS服务的Elasticsearch或OpenSearch时,获取默认CA证书的"证书名称"和"证书路径"。操作指导请参见[查看默认证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 - 当源端集群是自建或第三方Elasticsearch或OpenSearch时,则将源端集群的安全证书上传至Logstash并获取"证书名称"和"证书路径"。操作指导请参见[上传自定义证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 |
| output | hosts | 目的端集群的节点访问地址。支持配置多个IP地址。 取值格式:\["\<节点IP地址1\>:\<端口号\>", "\<节点IP地址2\>:\<端口号\>"\] |
| output | index | 事件写入的索引名称,即指定数据写入到哪个索引。 - 单个索引:直接输入单个索引名称(如"my_index")。 - 多个索引:基于字段的动态命名或多个条件输出块来匹配多个索引。 |
| output | document_type | 事件写入的文档类型。 建议将相似的事件写入同一类型中。 |
| output | document_id | 事件写入的文档ID。 如果指定了相同ID,则历史数据会被覆盖。 在数据迁移场景中建议配置本参数,避免数据重复。 |
| output | user | 访问目的端集群的用户名。 安全模式的集群必填。 |
| output | password | 访问目的端集群的用户名对应的密码。 安全模式的集群必填。 |
| output | ssl | 目的端集群是否启用SSL。 取值范围: - true:使用HTTPS协议传输数据。 - false:使用HTTP协议传输数据。 |
| output | cacert | 用于认证目的端集群的CA证书文件路径。 取值格式:\<证书路径\>\<证书名称\>(如/opt/logstash/extend/certs) - 当目的端集群是CSS服务的Elasticsearch或OpenSearch时,获取默认CA证书的"证书名称"和"证书路径"。操作指导请参见[查看默认证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 - 当目的端集群是自建或第三方Elasticsearch或OpenSearch时,则将目的端集群的安全证书上传至Logstash并获取"证书名称"和"证书路径"。操作指导请参见[上传自定义证书](https://support.huaweicloud.com/usermanual-css/css_01_0247.html)。 |
| output | ssl_certificate_verification | 目的端集群是否启用安全证书认证。 取值范围: - true(默认值):使用安全证书认证目的端集群。 - false:忽略安全证书认证。 |
3. 启动增量迁移任务。
1. 在配置文件列表,选择配置文件"es-es-inc",单击左上角的"启动"。
2. 在"启动Logstash服务"对话框中,根据业务需要选择"是否保持常驻"。此示例不开启保持常驻。 保持常驻会在每个节点上面配置一个守护进程,当Logstash服务出现故障的时候,会主动拉起并修复,从而保证Logstash管道稳定运行。保持常驻适用于需要长期运行的业务,不适用于短期运行的业务,短期业务如果源端无数据,开启保持常驻会导致任务失败。
3. 单击"确定",开始执行配置文件以启动Logstash增量迁移任务。 可以在管道列表看到启动的配置文件。
4. 数据迁移完毕检查数据一致性。
- 方式一:使用Putty登录迁移虚拟机,执行命令python checkIndices.py对比数据结果。
- 方式二:分别在源集群和目标集群的Kibana执行命令GET _cat/indices,对比两者的索引信息是否一致。
#### 释放Logstash集群
当集群迁移完成后,请及时释放Logstash集群,可以节约资源,避免产生不必要的费用。
1. 登录[云搜索服务管理控制台](https://console.huaweicloud.com/elasticsearch/)。
2. 在左侧导航栏,选择"集群管理 \> Logstash"。
3. 在Logstash集群列表,选择Logstash集群"Logstash-ES",单击操作列的"更多 \> 删除",在弹框中,输入**DELETE**,单击"确定"完成集群删除。